[코딩 자율학습 스프링 부트 3 자바 백엔드 개발 입문] 14장. 댓글 엔티티와 리파지터리 만들기
“코딩 자율학습 스프링 부트 3 자바 백엔드 개발 입문” 도서 바로가기
14장. 댓글 엔티티와 리파지터리 만들기
14.1 댓글 기능의 개요
14.1.1 댓글과 게시글의 관계
게시판에서 하나의 게시글에는 수많은 댓글이 달린다. 이러한 관계를 one-to-many, 즉 일대다(1:n) 관계라고 한다. 반대로 댓글 입장에서 보면 여러 댓글이 하나의 게시글에 달리므로 many-to-one, 즉 다대일(n:1) 관계이다.
DB에서 article 테이블과 comment 테이블은 id를 기준으로 관계를 맺는다. 두 테이블 모두 자신을 대표하는 속성을 대표키(PK, Primary Key)라고 하며, 동일 테이블 내에서 중복된 값이 없어야 한다. comment 테이블에는 연관 대상을 가리키는 속성인 외래키(FK, Foreign Key)인 article_id가 존재한다. 외래키는 항상 연관된 테이블의 대표키를 가리키며, 이를 통해 해당 댓글이 어떤 게시글에 달린 것인지 파악할 수 있다.
14.1.2 댓글 엔티티와 리파지터리 설계
- 엔티티: DB 데이터를 담는 자바 객체로, 엔티티를 기반으로 테이블이 생성된다.
- 리파지터리: 엔티티를 관리하는 인터페이스로, 데이터 CRUD 등의 기능을 제공한다.
댓글 작성을 위해 Comment 엔티티와 CommentRepository를 설계한다. 두 엔티티를 다대일 관계로 맺어 댓글에서 게시글을 찾아갈 수 있게 한다.
CommentRepository를 만들 때는 CrudRepository 대신 JpaRepository를 상속받는다. JpaRepository는 ListCrudRepository와 ListPagingAndSortingRepository를 상속받은 인터페이스로, CRUD 기능뿐만 아니라 엔티티를 페이지 단위로 조회 및 정렬하는 기능과 JPA에 특화된 여러 기능 등을 제공한다.
- Repository: 최상위 리파지터리 인터페이스
- CrudRepository 및 ListCrudRepository: 엔티티의 CRUD 기능 제공
- PagingAndSortingRepository 및 ListPagingAndSortingRepository: 엔티티의 페이징 및 정렬 기능 제공
- JpaRepository: 엔티티의 CRUD 기능과 페이징 및 정렬 기능뿐만 아니라 JPA에 특화된 기능을 추가로 제공
14.2 댓글 엔티티 만들기
14.2.1 댓글 엔티티 만들기
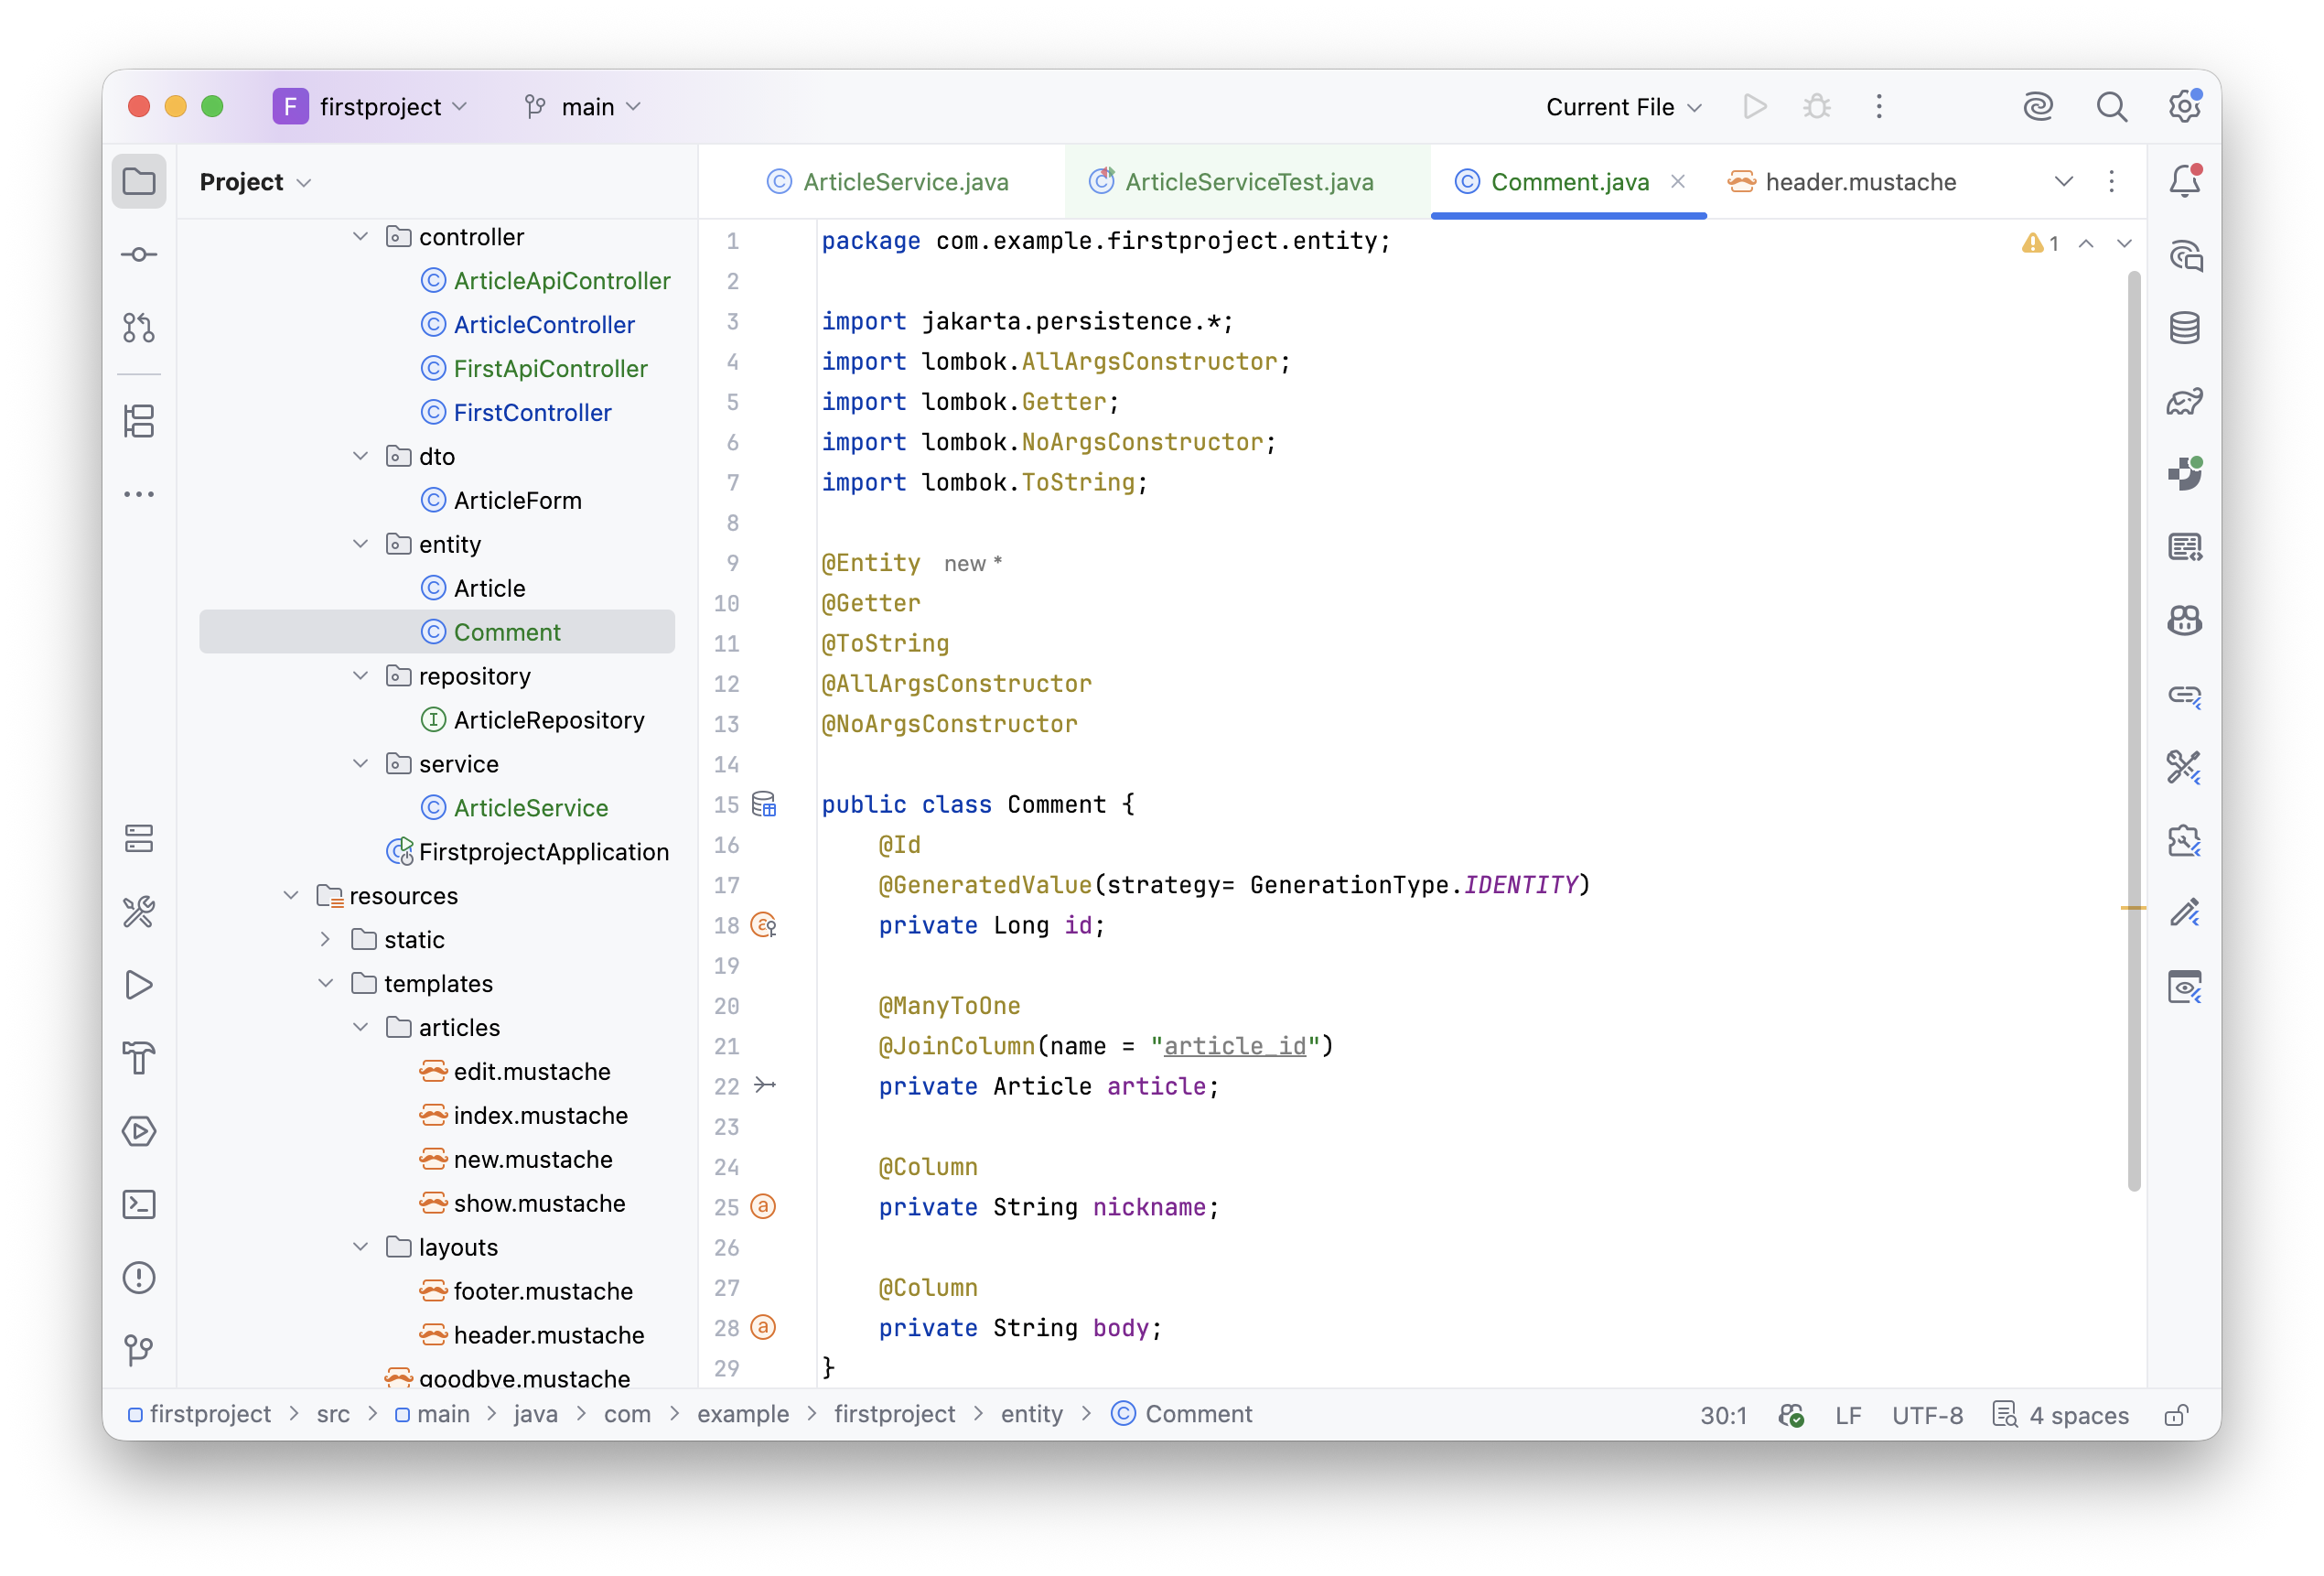
com.example.firstproject -> entity패키지에Comment클래스를 생성한다.- 클래스에
@Entity를 붙여 엔티티로 선언하고, 필요한 기능들을 위해 롬복 어노테이션(@Getter,@ToString,@AllArgsConstructor,@NoArgsConstructor)을 추가한다. Comment엔티티는 id(대표키), article(댓글의 부모 게시글), nickname(댓글을 단 사람), body(댓글 본문) 필드로 구성한다.id필드에@Id와@GeneratedValue(strategy=GenerationType.IDENTITY)를 붙여 DB가 알아서 id 값을 1씩 증가시키도록 설정한다.article필드에@ManyToOne어노테이션을 붙여Article엔티티와 다대일 관계를 설정한다.- 외래키 매핑을 위해
@JoinColumn(name="article_id")어노테이션을 사용하여Article엔티티의 기본키(id)와 매핑한다. nickname과body필드에는@Column어노테이션을 붙여 테이블의 속성으로 매핑한다.FirstprojectApplication을 실행하여 로그에서create table commentSQL 문을 확인하고,localhost:8080/h2-console에 접속하여comment테이블이 정상 생성되었는지 검증한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
package com.example.firstproject.entity;

import jakarta.persistence.*;
import lombok.AllArgsConstructor;
import lombok.Getter;
import lombok.NoArgsConstructor;
import lombok.ToString;

@Entity // 해당 클래스가 엔티티임을 선언, 클래스 필드를 바탕으로 DB에 테이블 생성
@Getter // 각 필드 값을 조회할 수 있는 getter 메서드 자동 생성
@ToString // 모든 필드를 출력할 수 있는 toString 메서드 자동 생성
@AllArgsConstructor // 모든 필드를 매개변수로 갖는 생성자 자동 생성
@NoArgsConstructor // 매개변수가 없는 기본 생성자 자동 생성
public class Comment{
    @Id // 대표키 지정
    @GeneratedValue(strategy = GenerationType.IDENTITY) // DB가 자동으로 1씩 증가
    private Long id; // 대표키

    @ManyToOne // Comment 엔티티와 Article 엔티티를 다대일 관계로 설정
    @JoinColumn(name = "article_id") // 외래키 생성, Article 엔티티의 기본키(id)와 매핑
    private Article article; // 해당 댓글의 부모 게시글

    @Column // 해당 필드를 테이블의 속성으로 매핑
    private String nickname; // 댓글을 단 사람

    @Column // 해당 필드를 테이블의 속성으로 매핑
    private String body; // 댓글 본문
}
14.2.2 더미 데이터 추가하기
resources/data.sql 파일에 기존 게시글 데이터 외에 댓글 조회를 실습할 수 있도록 추가적인 article 및 comment 더미 데이터를 삽입한다. id는 자동으로 증가하므로 생략하며, 외래키 article_id에는 연관된 게시글의 id를 지정한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
-- article 테이블에 데이터 추가
INSERT INTO article(title, content) VALUES('당신의 인생 영화는?', '댓글 고');
INSERT INTO article(title, content) VALUES('당신의 소울 푸드는?', '댓글 고고');
INSERT INTO article(title, content) VALUES('당신의 취미는?', '댓글 고고고');

-- 4번 게시글의 댓글 추가
INSERT INTO comment(article_id, nickname, body) VALUES (4, 'Park', '굿 윌 헌팅');
INSERT INTO comment(article_id, nickname, body) VALUES (4, 'Kim', '아이 엠 샘');
INSERT INTO comment(article_id, nickname, body) VALUES (4, 'Choi', '쇼생크 탈출');

-- 5번 게시글의 댓글 추가
INSERT INTO comment(article_id, nickname, body) VALUES (5, 'Park', '치킨');
INSERT INTO comment(article_id, nickname, body) VALUES (5, 'Kim', '샤브샤브');
INSERT INTO comment(article_id, nickname, body) VALUES (5, 'Choi', '초밥');

-- 6번 게시글의 댓글 추가
INSERT INTO comment(article_id, nickname, body) VALUES (6, 'Park', '조깅');
INSERT INTO comment(article_id, nickname, body) VALUES (6, 'Kim', '유튜브 시청');
INSERT INTO comment(article_id, nickname, body) VALUES (6, 'Choi', '독서');
서버를 재시작하고 H2 콘솔에서 테이블을 조회하여 총 9개의 댓글 데이터가 정상적으로 매핑되어 삽입되었는지 확인한다.
:
1
  SELECT * FROM comment WHERE article_id = 4;
특정 닉네임의 모든 댓글 조회 (Park):
1
  SELECT * FROM comment WHERE nickname = 'Park';
라고 한다. 네이티브 쿼리 메서드를 만드는 방법은 @Query 어노테이션을 이용하거나 orm.xml 파일을 이용하는 방법이 있다.
1. 특정 게시글의 모든 댓글 조회 (@Query 어노테이션 이용)
메서드 이름을 findByArticleId로 정의하고 반환형은 List<Comment>로 설정한다. @Query 어노테이션을 붙이되, nativeQuery = true 속성을 추가하면 기존 SQL 문을 그대로 사용할 수 있다. SQL 문의 WHERE 절에 조건을 작성할 때는 메서드의 매개변수와 매칭되도록 변수명 앞에 콜론(:)을 붙여야 한다.
2. 특정 닉네임의 모든 댓글 조회 (네이티브 쿼리 XML 이용)
메서드 이름은 findByNickname으로 정의하고 반환형은 List<Comment>로 설정한다. 쿼리문은 XML 파일로 분리하여 작성하기 위해 resources 디렉터리 아래에 반드시 META-INF 디렉터리를 만들고, 그 안에 반드시 orm.xml 파일명으로 생성한다.
resources/META-INF/orm.xml작성:<named-native-query>태그의name속성에는엔티티_이름.메서드_이름을 적고,result-class에는 전체 패키지 경로를 적는다.<query>태그 내부에는 쿼리를 기재하되, 대소 비교 연산자 등의 파싱 문제를 방지하기 위해<![CDATA[ ... ]]>구문 안에 SQL 문을 작성한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
<?xml version="1.0" encoding="utf-8"?>
<entity-mappings xmlns="https://jakarta.ee/xml/ns/persistence/orm"
                 xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
                 xsi:schemaLocation="https://jakarta.ee/xml/ns/persistence/orm
                 https://jakarta.ee/xml/ns/persistence/orm/orm_3_0.xsd"
                 version="3.0">

    <named-native-query
            name="Comment.findByNickname"
            result-class="com.example.firstproject.entity.Comment">
        <query>
            <![CDATA[
                SELECT * FROM comment WHERE nickname = :nickname
            ]]>
        </query>
    </named-native-query>

</entity-mappings>
- 완성된
CommentRepository.java:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
package com.example.firstproject.repository;

import com.example.firstproject.entity.Comment;
import org.springframework.data.jpa.repository.JpaRepository;
import org.springframework.data.jpa.repository.Query;
import java.util.List;

public interface CommentRepository extends JpaRepository<Comment, Long>{
    // 특정 게시글의 모든 댓글 조회
    @Query(value = "SELECT * FROM comment WHERE article_id = :articleId", nativeQuery = true)
    List<Comment> findByArticleId(Long articleId);

    // 특정 닉네임의 모든 댓글 조회
    List<Comment> findByNickname(String nickname);
}
14.3.2 댓글 리파지터리 테스트 코드 작성하기
작성한 두 네이티브 쿼리 메서드가 정상 동작하는지 테스트 코드를 구현하여 검증한다.
리파지터리와 엔티티 등 JPA 영역의 테스트를 진행할 때는 @DataJpaTest 어노테이션을 사용한다. 외부 객체 주입을 위해 @Autowired를 사용하여 CommentRepository를 선언한다. 메서드 이름을 그대로 둔 채 테스트 결과 창에 보여줄 이름을 지정하기 위해 @DisplayName 어노테이션을 활용한다. 테스트 단계는 1. 입력 데이터 준비, 2. 실제 데이터, 3. 예상 데이터, 4. 비교 및 검증 순으로 구분하여 진행한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
package com.example.firstproject.repository;

import com.example.firstproject.entity.Article;
import com.example.firstproject.entity.Comment;
import org.junit.jupiter.api.DisplayName;
import org.junit.jupiter.api.Test;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.autoconfigure.orm.jpa.DataJpaTest;
import java.util.Arrays;
import java.util.List;
import static org.junit.jupiter.api.Assertions.*;

@DataJpaTest // 해당 클래스를 JPA와 연동해 테스팅
class CommentRepositoryTest{

    @Autowired
    CommentRepository commentRepository; // commentRepository 객체 주입

    @Test
    @DisplayName("특정 게시글의 모든 댓글 조회")
    void findByArticleId(){
        /* Case 1: 4번 게시글의 모든 댓글 조회 */
        {
            // 1. 입력 데이터 준비
            Long articleId = 4L;

            // 2. 실제 데이터
            List<Comment> comments = commentRepository.findByArticleId(articleId);

            // 3. 예상 데이터
            Article article = new Article(4L, "당신의 인생 영화는?", "댓글 고");
            Comment a = new Comment(1L, article, "Park", "굿 윌 헌팅");
            Comment b = new Comment(2L, article, "Kim", "아이 엠 샘");
            Comment c = new Comment(3L, article, "Choi", "쇼생크 탈출");
            List<Comment> expected = Arrays.asList(a, b, c);

            // 4. 비교 및 검증
            assertEquals(expected.toString(), comments.toString(), "4번 글의 모든 댓글을 출력!");
        }

        /* Case 2: 1번 게시글의 모든 댓글 조회 */
        {
            // 1. 입력 데이터 준비
            Long articleId = 1L;

            // 2. 실제 데이터
            List<Comment> comments = commentRepository.findByArticleId(articleId);

            // 3. 예상 데이터
            Article article = new Article(1L, "가가가가", "1111");
            List<Comment> expected = Arrays.asList(); // 댓글이 없으므로 비어 있는 리스트 생성

            // 4. 비교 및 검증
            assertEquals(expected.toString(), comments.toString(), "1번 글은 댓글이 없음");
        }
    }

    @Test
    @DisplayName("특정 닉네임의 모든 댓글 조회")
    void findByNickname(){
        /* Case 1: "Park"의 모든 댓글 조회 */
        {
            // 1. 입력 데이터 준비
            String nickname = "Park";

            // 2. 실제 데이터
            List<Comment> comments = commentRepository.findByNickname(nickname);

            // 3. 예상 데이터
            // 부모 게시글이 각각 다르므로 각 댓글 생성 시 부모 객체를 따로 생성하여 전달한다
            Comment a = new Comment(1L, new Article(4L, "당신의 인생 영화는?", "댓글 고"), nickname, "굿 윌 헌팅");
            Comment b = new Comment(4L, new Article(5L, "당신의 소울 푸드는?", "댓글 고고"), nickname, "치킨");
            Comment c = new Comment(7L, new Article(6L, "당신의 취미는?", "댓글 고고고"), nickname, "조깅");
            List<Comment> expected = Arrays.asList(a, b, c);

            // 4. 비교 및 검증
            assertEquals(expected.toString(), comments.toString(), "Park의 모든 댓글을 출력!");
        }
    }
}
- 테스트 결과 검증: 테스트를 수행하여 정상 통과하면 실제 데이터와 예상 데이터가 일치함을 의미한다. 만약 실패하는 상황을 확인하고자 예상 데이터의 특정 필드 값(예:
Park이 작성한 1번 댓글의 id를 1L에서 2L로 수정)을 변경하고 테스트를 실행하면, Expected와 Actual 값이 일치하지 않아 테스트 실패 로그가 정상적으로 출력된다.
![사진4](/assets/img/posts/springboot3/springboot3_chap14_4.png