[혼자 공부하는 머신러닝+딥러닝] 3장. 회귀 알고리즘과 모델 규제
[혼자 공부하는 머신러닝+딥러닝] 3장. 회귀 알고리즘과 모델 규제
“혼자 공부하는 머신러닝+딥러닝(개정판)” 도서 바로가기
예제 코드 (저자 제공): 03-1, 03-2, 03-3
3장. 회귀 알고리즘과 모델 규제
03-1. k-최근접 이웃 회귀
k-최근접 이웃 회귀
- 지도 학습의 두 종류
- 분류(classification): 샘플을 몇 개의 클래스 중 하나로 구분하는 문제 (1~2장의 도미/빙어)
- 회귀(regression): 임의의 숫자를 예측하는 문제 (농어의 무게, 내년 경제 성장률 등)
- k-최근접 이웃 회귀: 예측하려는 샘플에 가장 가까운 이웃 k개를 찾은 다음, 이웃 타깃값의 평균을 예측값으로 삼는다
- 분류에서는 이웃의 다수 클래스가 예측이었지만, 회귀에서는 이웃의 평균값이 예측이 된다
데이터 준비
1
import numpy as np
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
perch_length = np.array(
    [8.4, 13.7, 15.0, 16.2, 17.4, 18.0, 18.7, 19.0, 19.6, 20.0,
     21.0, 21.0, 21.0, 21.3, 22.0, 22.0, 22.0, 22.0, 22.0, 22.5,
     22.5, 22.7, 23.0, 23.5, 24.0, 24.0, 24.6, 25.0, 25.6, 26.5,
     27.3, 27.5, 27.5, 27.5, 28.0, 28.7, 30.0, 32.8, 34.5, 35.0,
     36.5, 36.0, 37.0, 37.0, 39.0, 39.0, 39.0, 40.0, 40.0, 40.0,
     40.0, 42.0, 43.0, 43.0, 43.5, 44.0]
     )
perch_weight = np.array(
    [5.9, 32.0, 40.0, 51.5, 70.0, 100.0, 78.0, 80.0, 85.0, 85.0,
     110.0, 115.0, 125.0, 130.0, 120.0, 120.0, 130.0, 135.0, 110.0,
     130.0, 150.0, 145.0, 150.0, 170.0, 225.0, 145.0, 188.0, 180.0,
     197.0, 218.0, 300.0, 260.0, 265.0, 250.0, 250.0, 300.0, 320.0,
     514.0, 556.0, 840.0, 685.0, 700.0, 700.0, 690.0, 900.0, 650.0,
     820.0, 850.0, 900.0, 1015.0, 820.0, 1100.0, 1000.0, 1100.0,
     1000.0, 1000.0]
     )
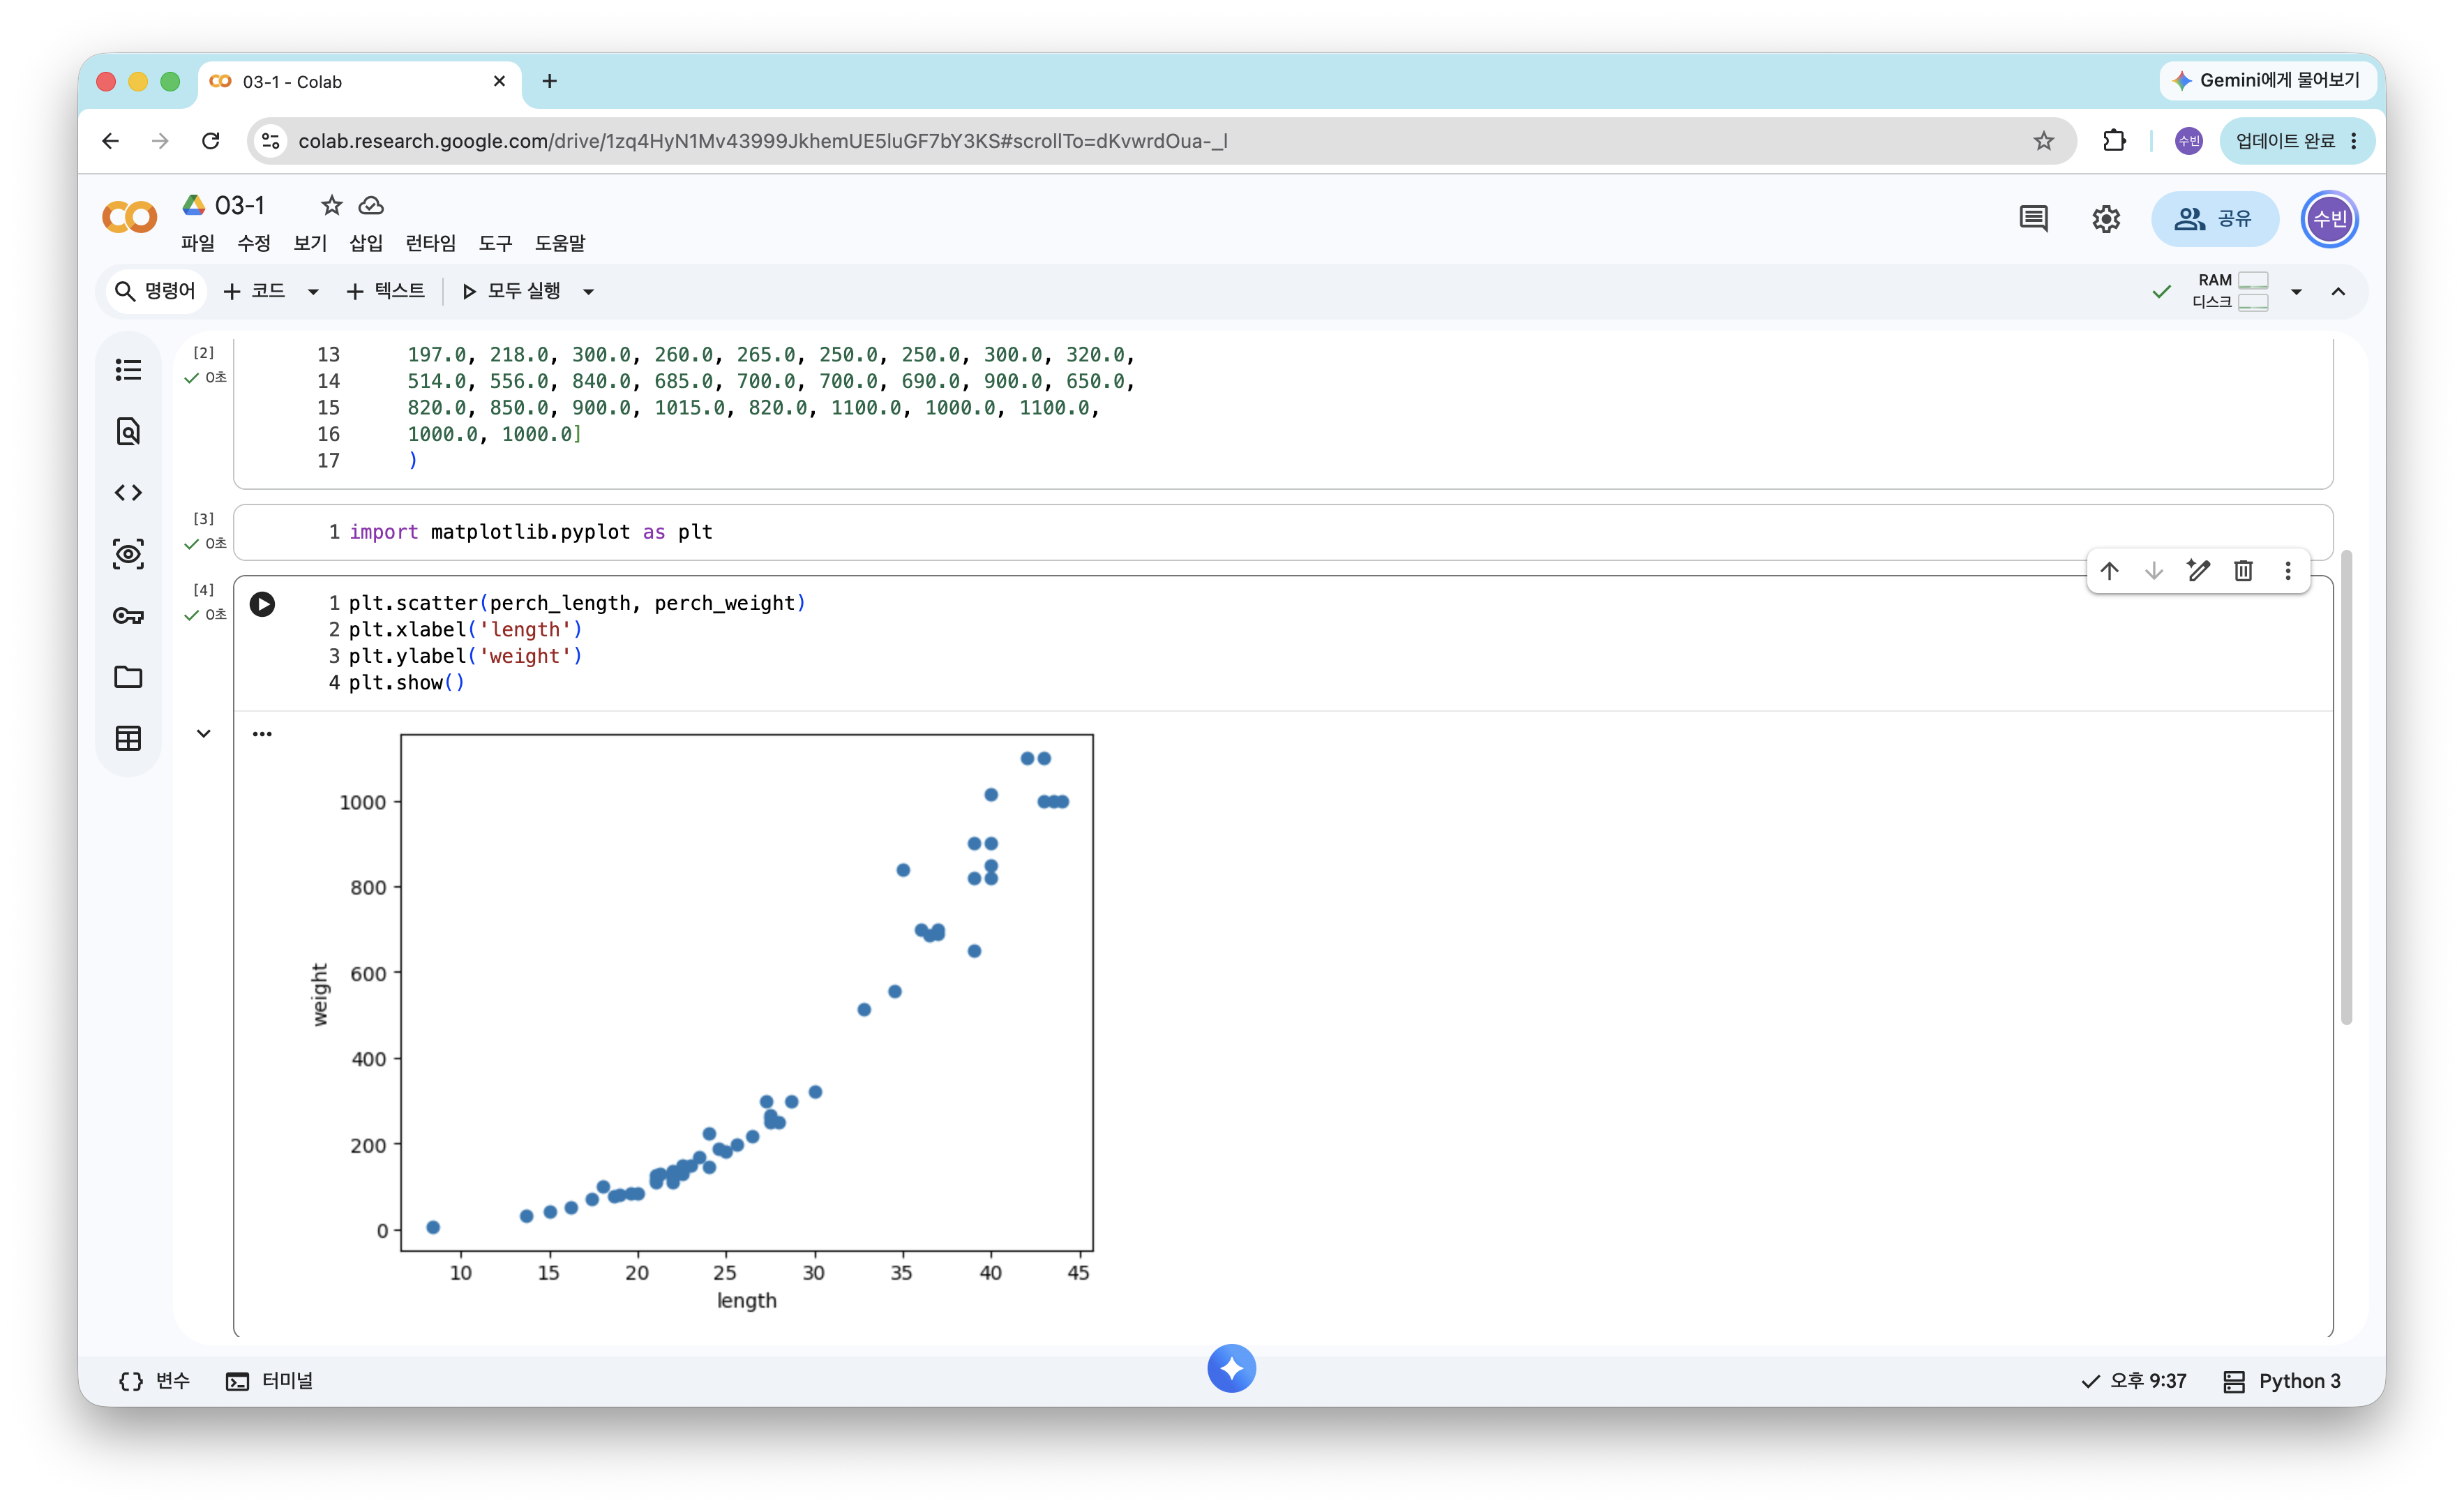
- 농어의 길이로 무게를 예측하는 문제. 타깃이 숫자이므로 회귀 문제다
1
import matplotlib.pyplot as plt
1
2
3
4
plt.scatter(perch_length, perch_weight)
plt.xlabel('length')
plt.ylabel('weight')
plt.show()
- 농어의 길이가 커질수록 무게도 늘어난다
1
from sklearn.model_selection import train_test_split
1
2
train_input, test_input, train_target, test_target = train_test_split(
    perch_length, perch_weight, random_state=42)
1
print(train_input.shape, test_input.shape)
1
(42,) (14,)
- 사이킷런에 쓰는 훈련 세트는 2차원 배열이어야 하는데, 특성이 하나뿐이라 1차원 배열이 되었다
1
2
test_array = np.array([1,2,3,4])
print(test_array.shape)
1
(4,)
1
2
test_array = test_array.reshape(2, 2)
print(test_array.shape)
1
(2, 2)
reshape(): 배열의 크기를 바꾼다. 바꾸기 전후의 원소 개수가 같아야 한다
1
2
train_input = train_input.reshape(-1, 1)
test_input = test_input.reshape(-1, 1)
1
print(train_input.shape, test_input.shape)
1
(42, 1) (14, 1)
- 크기에
-1을 지정하면 나머지 원소 개수로 알아서 채운다
결정계수(R²)
1
from sklearn.neighbors import KNeighborsRegressor
1
2
3
knr = KNeighborsRegressor()
# k-최근접 이웃 회귀 모델을 훈련합니다
knr.fit(train_input, train_target)
1
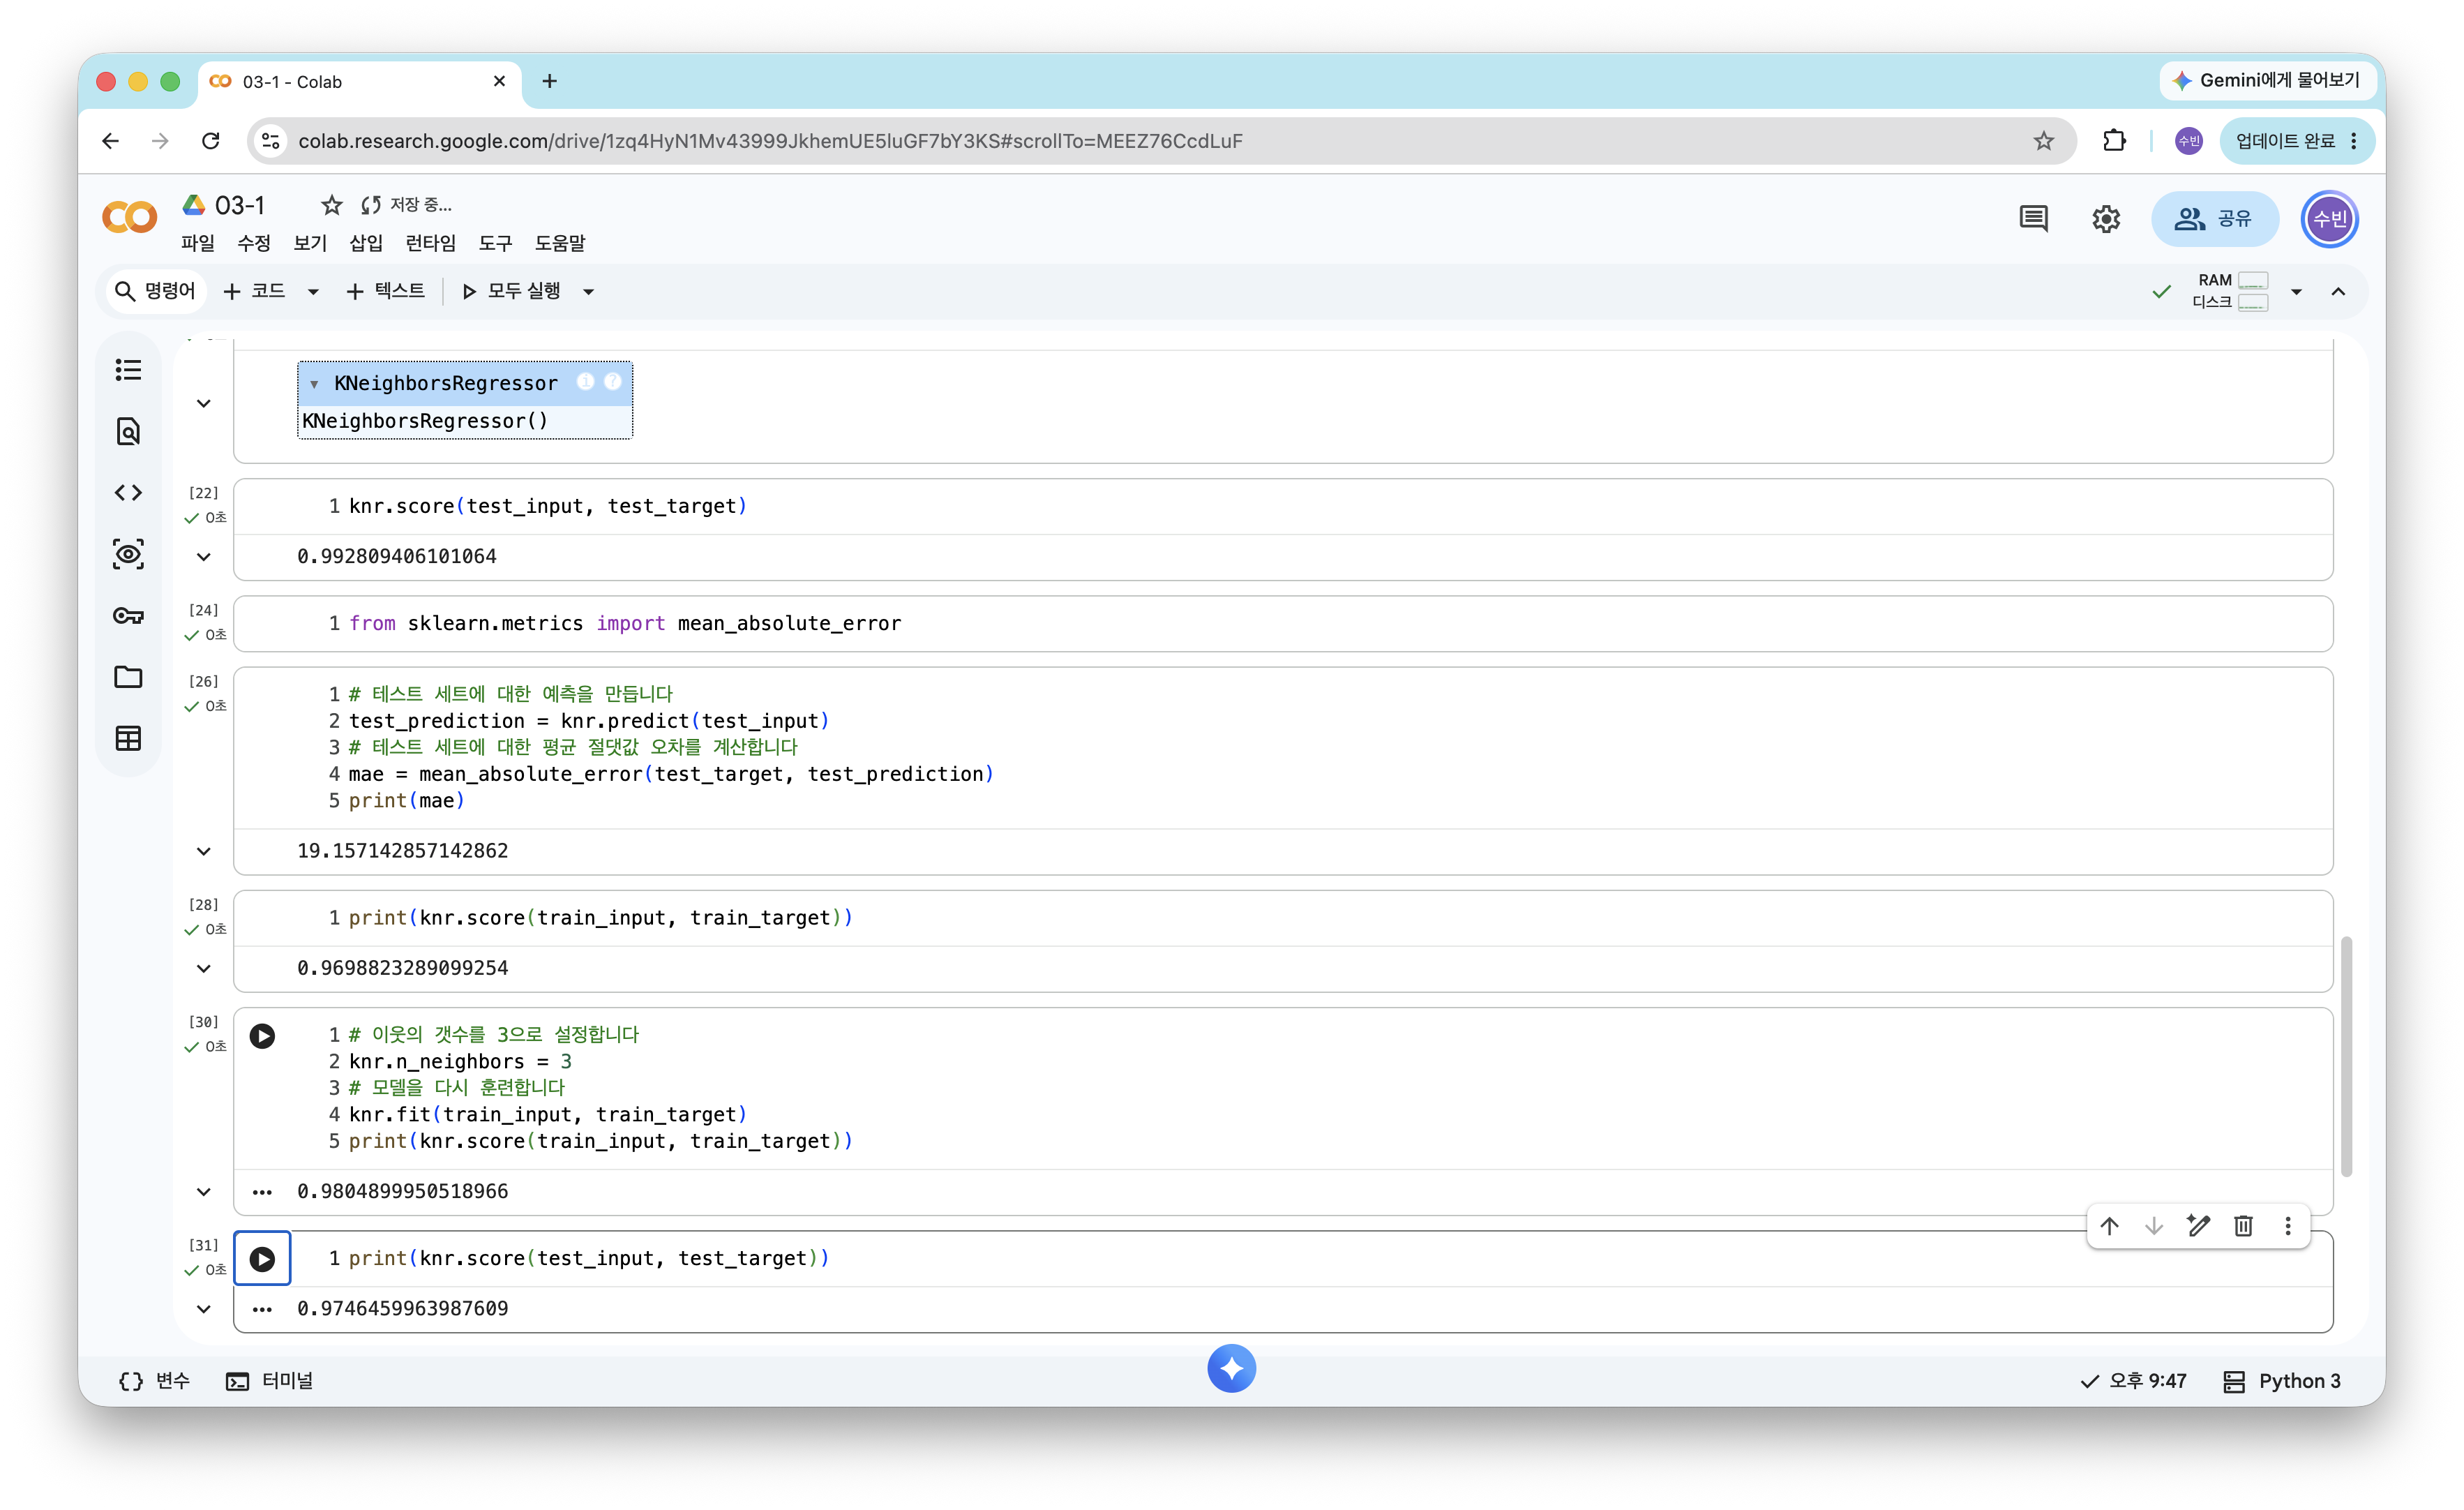
knr.score(test_input, test_target)
1
0.992809406101064
- 회귀에서
score()가 반환하는 값은 정확도가 아니라 결정계수(coefficient of determination, R²) 다 - R² = 1 − (타깃 − 예측)의 제곱합 / (타깃 − 평균)의 제곱합
- 예측이 타깃에 가까워지면 1에 가까워지고, 타깃의 평균 정도를 예측하면 0에 가까워진다
1
from sklearn.metrics import mean_absolute_error
1
2
3
4
5
# 테스트 세트에 대한 예측을 만듭니다
test_prediction = knr.predict(test_input)
# 테스트 세트에 대한 평균 절댓값 오차를 계산합니다
mae = mean_absolute_error(test_target, test_prediction)
print(mae)
1
19.157142857142862
- 평균 절댓값 오차(MAE): 타깃과 예측의 절댓값 오차를 평균한 값. 예측이 평균 19g 정도 타깃값과 다르다는 뜻
과대적합 vs 과소적합
1
print(knr.score(train_input, train_target))
1
0.9698823289099254
- 훈련 세트 점수(0.9699)가 테스트 세트 점수(0.9928)보다 낮다
- 과대적합(overfitting): 훈련 세트 점수는 높은데 테스트 세트 점수가 크게 낮은 경우. 훈련 세트에만 잘 맞는 모델
- 과소적합(underfitting): 훈련 세트보다 테스트 세트 점수가 높거나, 두 점수가 모두 너무 낮은 경우. 모델이 너무 단순한 것
- 훈련 세트 크기가 작을 때도 일어날 수 있다
1
2
3
4
5
# 이웃의 갯수를 3으로 설정합니다
knr.n_neighbors = 3
# 모델을 다시 훈련합니다
knr.fit(train_input, train_target)
print(knr.score(train_input, train_target))
1
0.9804899950518966
1
print(knr.score(test_input, test_target))
1
0.9746459963987609
- 과소적합을 해결하려면 모델을 조금 더 복잡하게 만들면 된다
- k-최근접 이웃에서는 이웃 개수 k를 줄이면 모델이 복잡해진다 (국지적인 패턴에 민감해짐)
- k를 3으로 줄이니 훈련 세트 점수가 테스트 세트 점수보다 높아졌고, 두 점수 차이도 크지 않다
회귀 문제 다루기
이번 절의 문제 해결 과정을 정리하면 다음과 같다.
- 문제 정의: 농어의 길이로 무게를 예측 → 타깃이 숫자이므로 회귀
- 데이터 준비: 훈련/테스트 세트로 나누고,
reshape()로 2차원 배열로 변환 - 훈련:
KNeighborsRegressor로 훈련 - 평가:
score()가 반환하는 결정계수(R²) 와mean_absolute_error()확인 - 문제 발견: 훈련 세트 점수가 테스트 세트 점수보다 낮음 → 과소적합
- 해결: 이웃 개수를 5 → 3으로 줄여 모델을 복잡하게 만듦
03-2. 선형 회귀
k-최근접 이웃의 한계
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
import numpy as np

perch_length = np.array(
    [8.4, 13.7, 15.0, 16.2, 17.4, 18.0, 18.7, 19.0, 19.6, 20.0,
     21.0, 21.0, 21.0, 21.3, 22.0, 22.0, 22.0, 22.0, 22.0, 22.5,
     22.5, 22.7, 23.0, 23.5, 24.0, 24.0, 24.6, 25.0, 25.6, 26.5,
     27.3, 27.5, 27.5, 27.5, 28.0, 28.7, 30.0, 32.8, 34.5, 35.0,
     36.5, 36.0, 37.0, 37.0, 39.0, 39.0, 39.0, 40.0, 40.0, 40.0,
     40.0, 42.0, 43.0, 43.0, 43.5, 44.0]
     )
perch_weight = np.array(
    [5.9, 32.0, 40.0, 51.5, 70.0, 100.0, 78.0, 80.0, 85.0, 85.0,
     110.0, 115.0, 125.0, 130.0, 120.0, 120.0, 130.0, 135.0, 110.0,
     130.0, 150.0, 145.0, 150.0, 170.0, 225.0, 145.0, 188.0, 180.0,
     197.0, 218.0, 300.0, 260.0, 265.0, 250.0, 250.0, 300.0, 320.0,
     514.0, 556.0, 840.0, 685.0, 700.0, 700.0, 690.0, 900.0, 650.0,
     820.0, 850.0, 900.0, 1015.0, 820.0, 1100.0, 1000.0, 1100.0,
     1000.0, 1000.0]
     )
1
2
3
4
5
6
7
8
from sklearn.model_selection import train_test_split

# 훈련 세트와 테스트 세트로 나눕니다
train_input, test_input, train_target, test_target = train_test_split(
    perch_length, perch_weight, random_state=42)
# 훈련 세트와 테스트 세트를 2차원 배열로 바꿉니다
train_input = train_input.reshape(-1, 1)
test_input = test_input.reshape(-1, 1)
1
2
3
4
5
from sklearn.neighbors import KNeighborsRegressor

knr = KNeighborsRegressor(n_neighbors=3)
# k-최근접 이웃 회귀 모델을 훈련합니다
knr.fit(train_input, train_target)
1
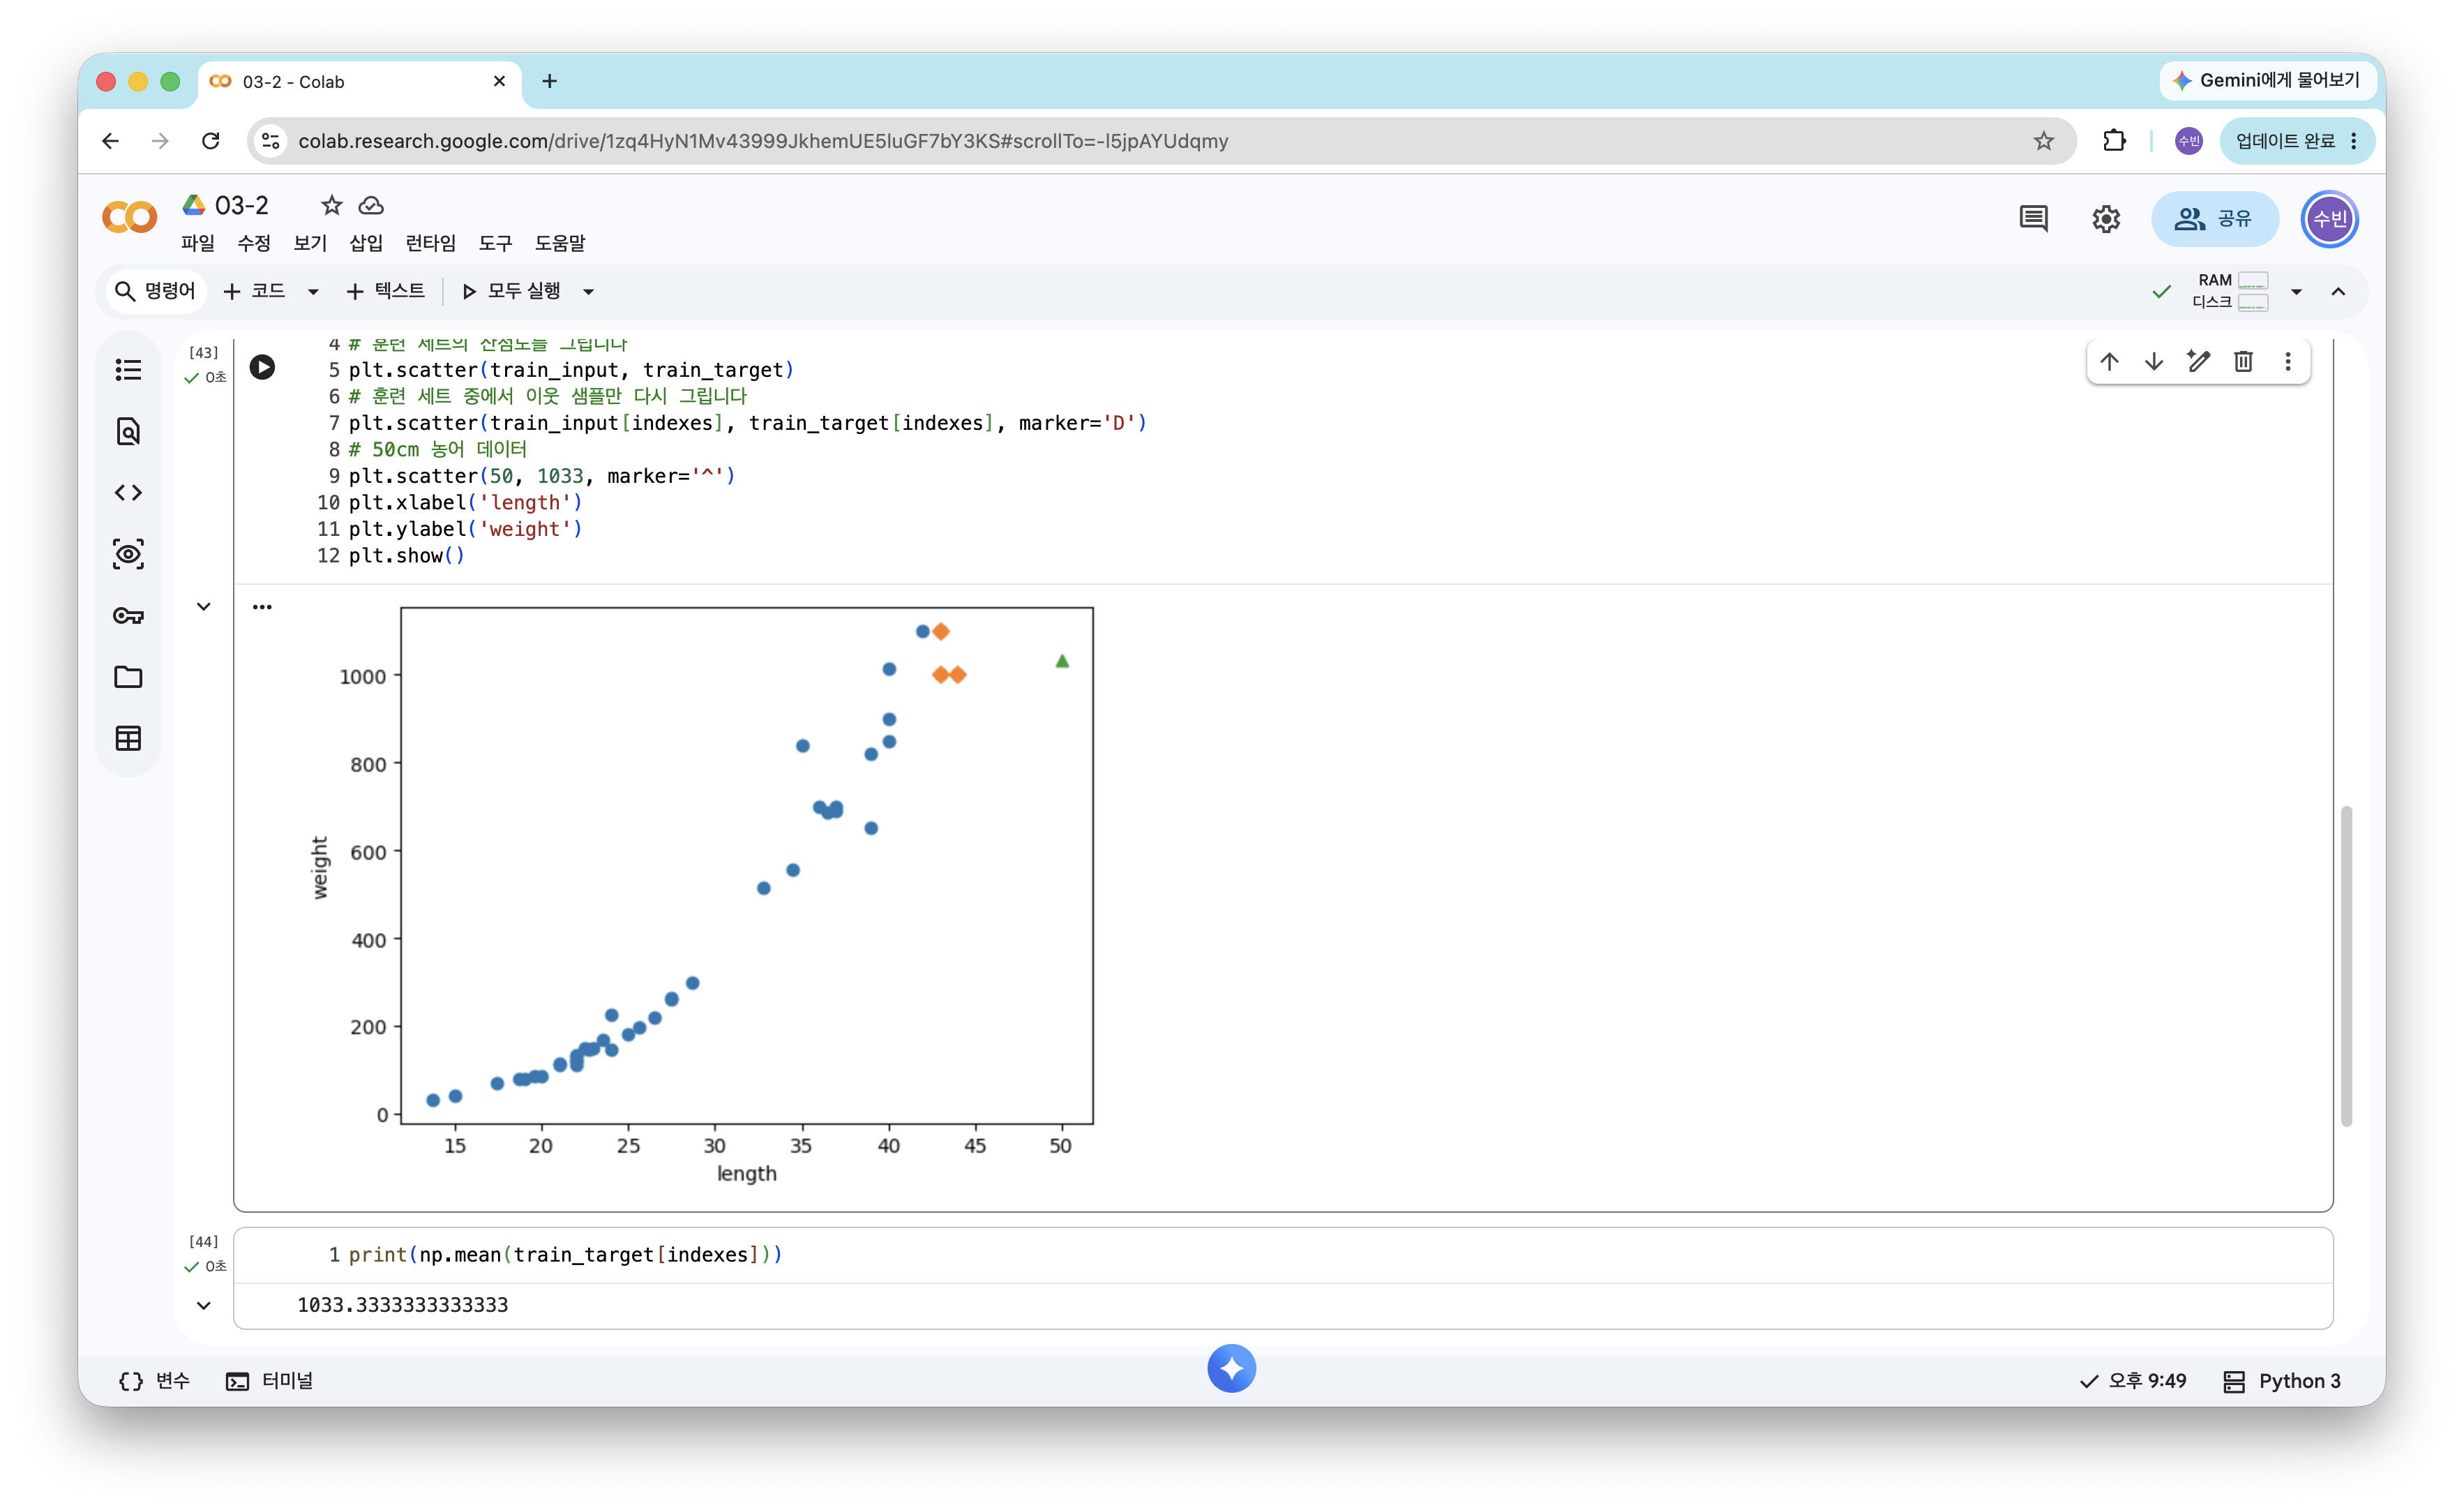
print(knr.predict([[50]]))
1
[1033.33333333]
- 실제 50cm 농어의 무게는 1.5kg 정도인데 1033g으로 예측했다
1
import matplotlib.pyplot as plt
1
2
3
4
5
6
7
8
9
10
11
12
# 50cm 농어의 이웃을 구합니다
distances, indexes = knr.kneighbors([[50]])

# 훈련 세트의 산점도를 그립니다
plt.scatter(train_input, train_target)
# 훈련 세트 중에서 이웃 샘플만 다시 그립니다
plt.scatter(train_input[indexes], train_target[indexes], marker='D')
# 50cm 농어 데이터
plt.scatter(50, 1033, marker='^')
plt.xlabel('length')
plt.ylabel('weight')
plt.show()
1
print(np.mean(train_target[indexes]))
1
1033.3333333333333
1
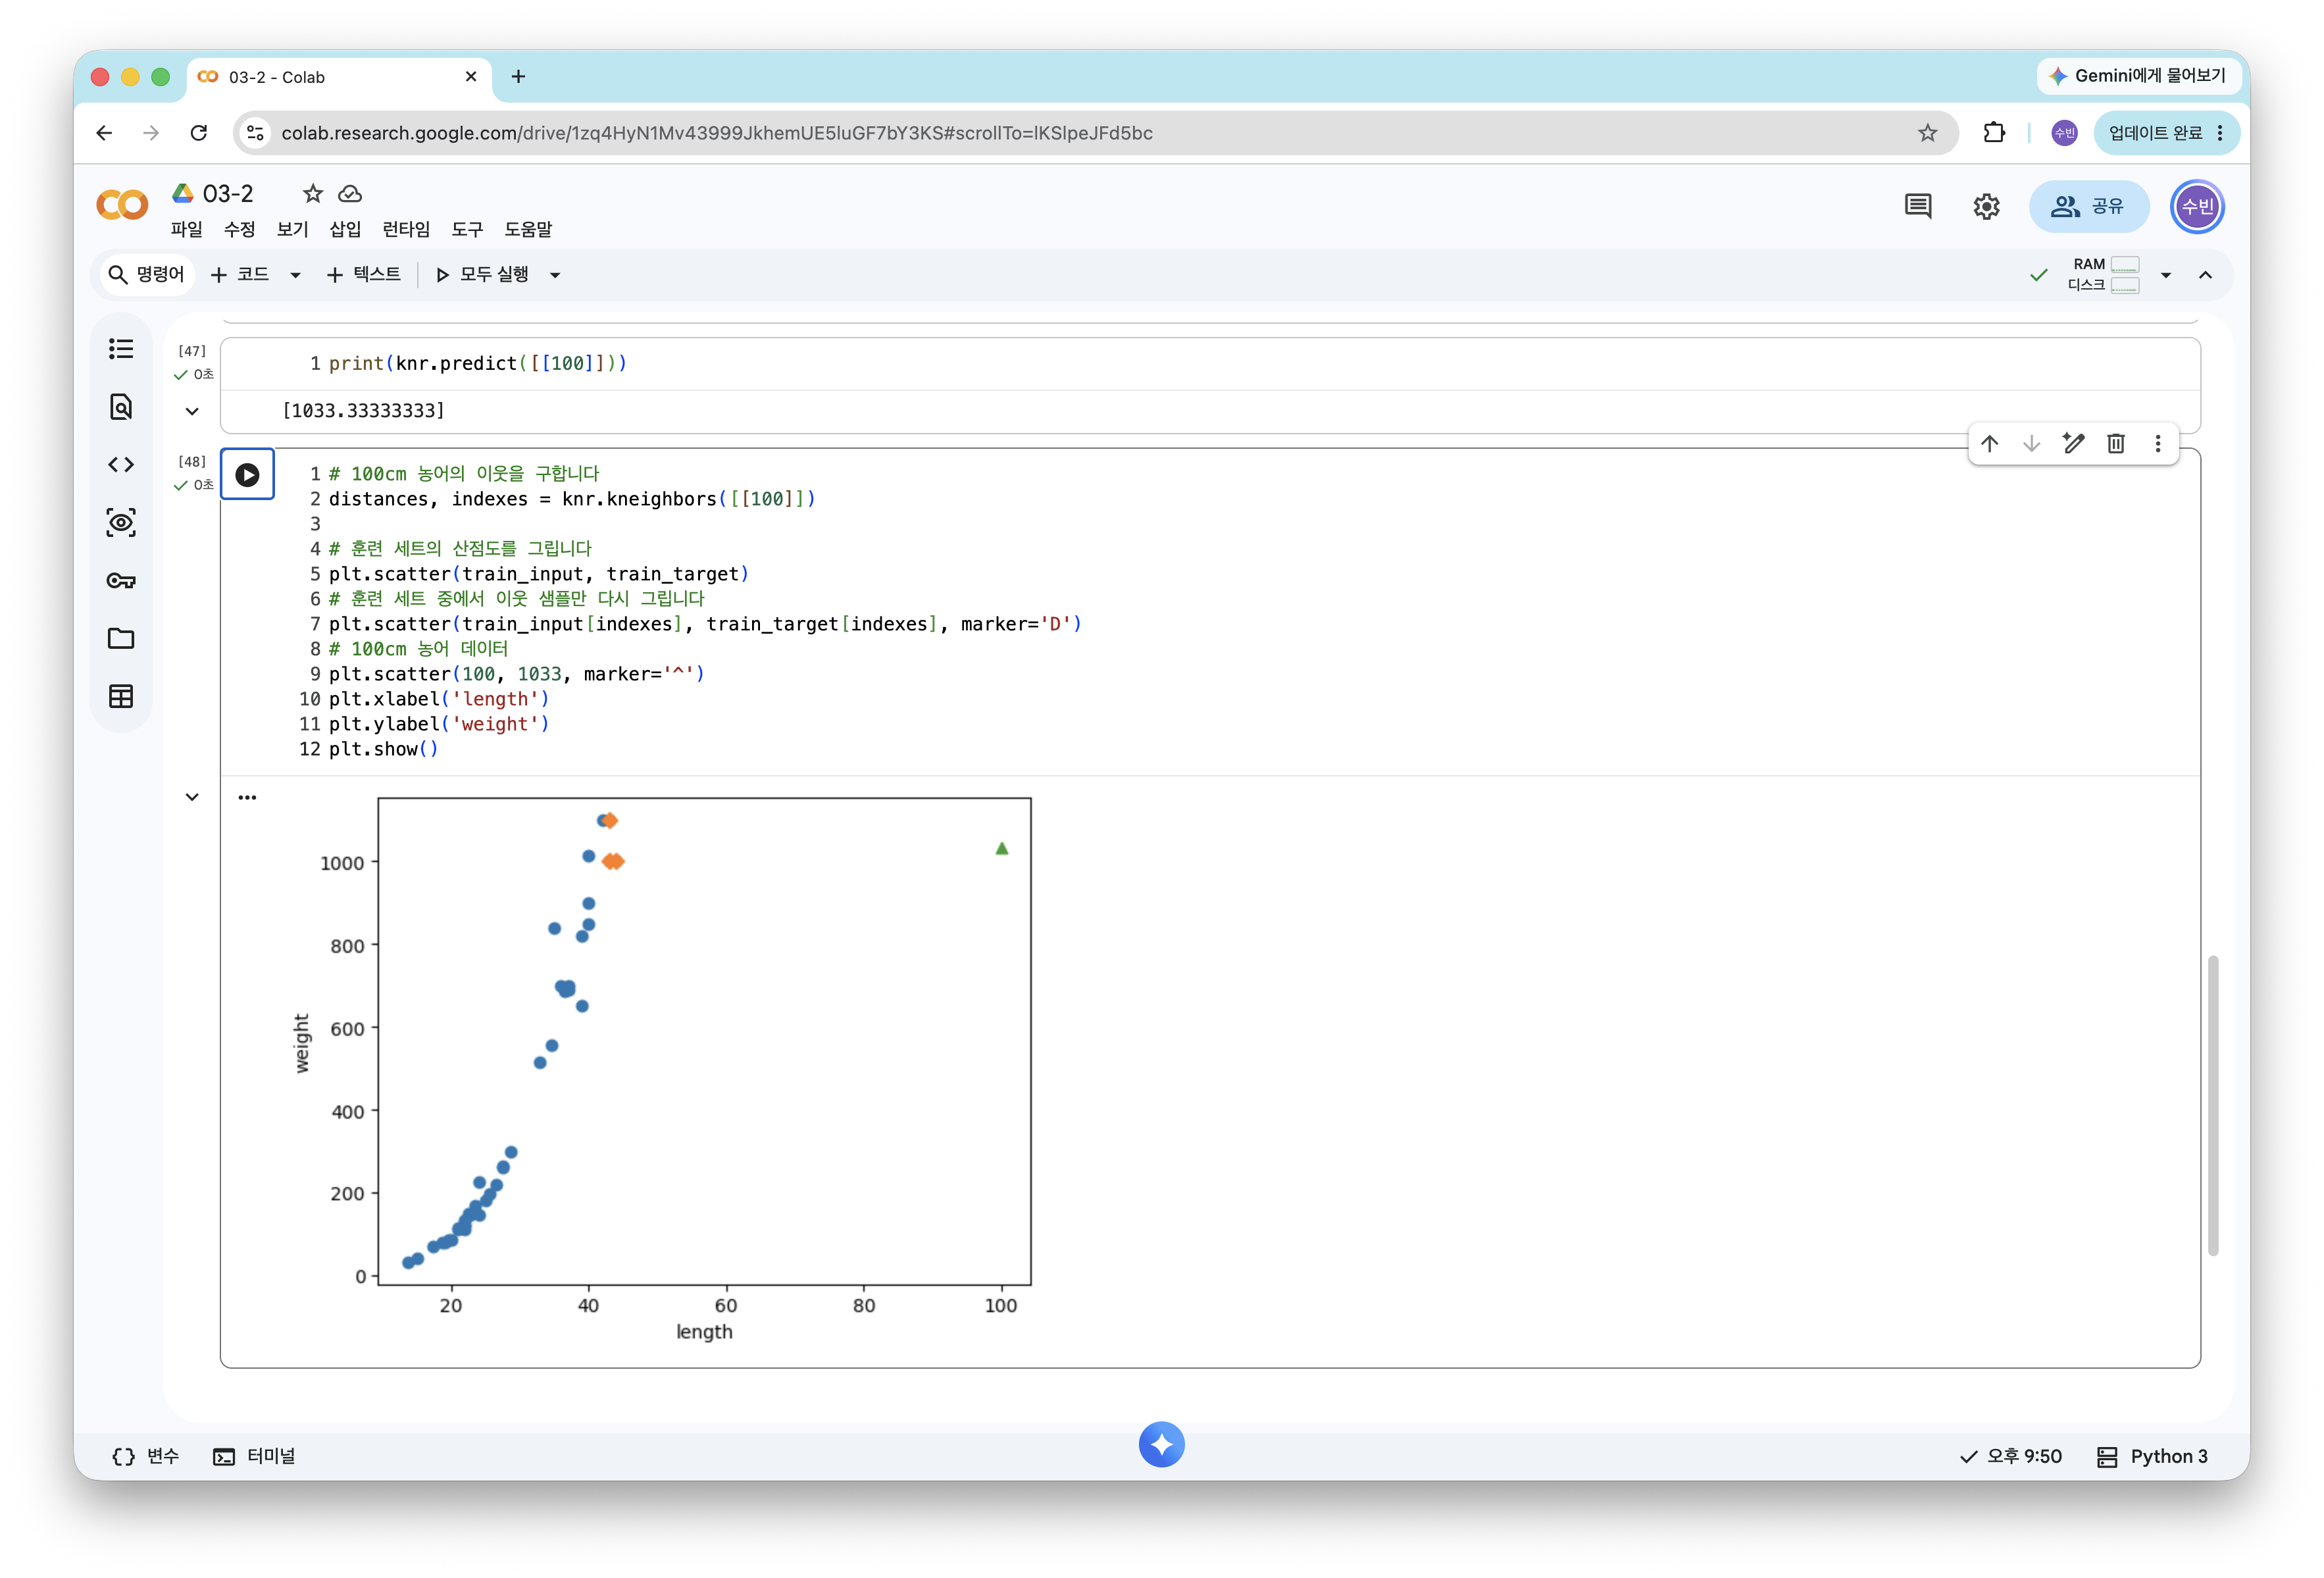
print(knr.predict([[100]]))
1
[1033.33333333]
1
2
3
4
5
6
7
8
9
10
11
12
# 100cm 농어의 이웃을 구합니다
distances, indexes = knr.kneighbors([[100]])

# 훈련 세트의 산점도를 그립니다
plt.scatter(train_input, train_target)
# 훈련 세트 중에서 이웃 샘플만 다시 그립니다
plt.scatter(train_input[indexes], train_target[indexes], marker='D')
# 100cm 농어 데이터
plt.scatter(100, 1033, marker='^')
plt.xlabel('length')
plt.ylabel('weight')
plt.show()
- k-최근접 이웃의 한계: 새로운 샘플이 훈련 세트의 범위를 벗어나면, 아무리 커져도 이웃은 그대로이므로 항상 같은 값을 예측한다
선형 회귀
: 특성과 타깃 사이의 관계를 가장 잘 나타내는 직선(일차 방정식) 을 학습하는 알고리즘
1
from sklearn.linear_model import LinearRegression
1
2
3
lr = LinearRegression()
# 선형 회귀 모델 훈련
lr.fit(train_input, train_target)
1
2
# 50cm 농어에 대한 예측
print(lr.predict([[50]]))
1
[1241.83860323]
1
print(lr.coef_, lr.intercept_)
1
[39.01714496] -709.0186449535477
- 모델 파라미터(model parameter): 머신러닝 알고리즘이 훈련하면서 찾은 값
coef_: 기울기(계수, 가중치),intercept_: 절편
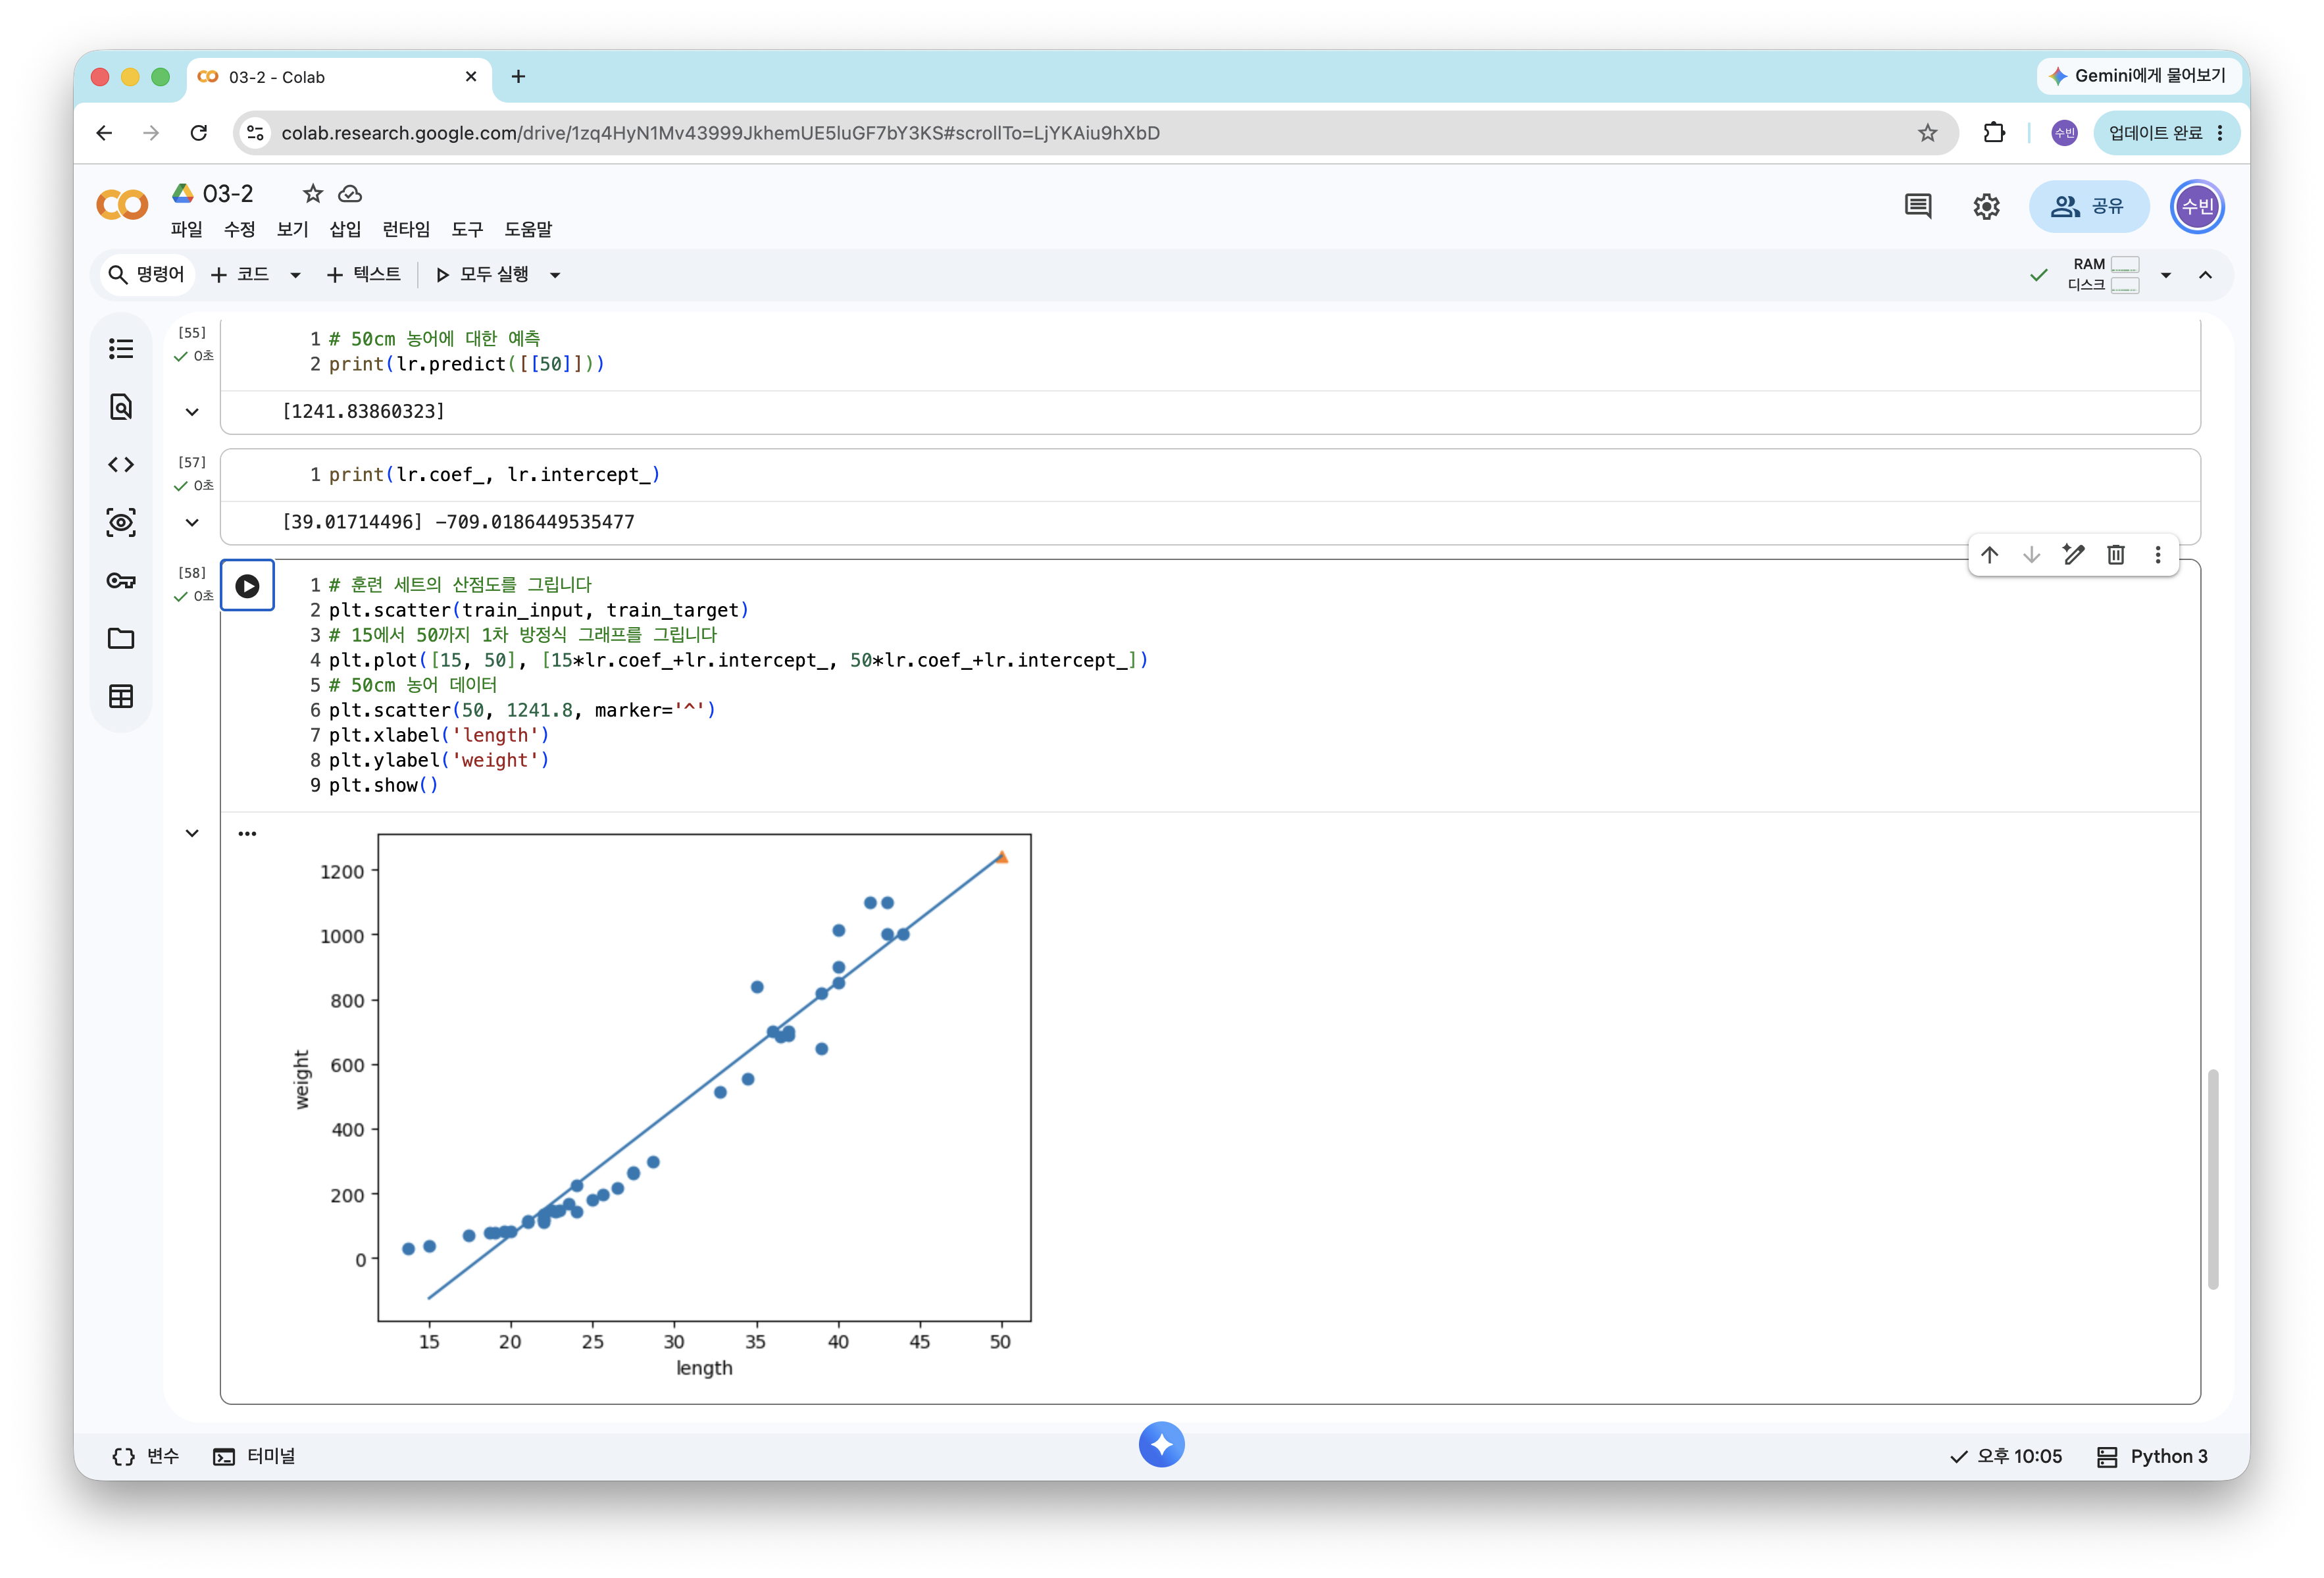
- 농어 무게 = 39.017 × 길이 − 709.019
1
2
3
4
5
6
7
8
9
# 훈련 세트의 산점도를 그립니다
plt.scatter(train_input, train_target)
# 15에서 50까지 1차 방정식 그래프를 그립니다
plt.plot([15, 50], [15*lr.coef_+lr.intercept_, 50*lr.coef_+lr.intercept_])
# 50cm 농어 데이터
plt.scatter(50, 1241.8, marker='^')
plt.xlabel('length')
plt.ylabel('weight')
plt.show()
1
2
print(lr.score(train_input, train_target))
print(lr.score(test_input, test_target))
1
2
0.939846333997604
0.8247503123313558
- 훈련 세트 점수도 높지 않고 두 점수 차이도 크다 → 전체적으로 과소적합
- 직선의 왼쪽 아래를 보면 길이가 짧을 때 무게가 음수가 되는 문제도 있다
다항 회귀
: 다항식을 사용한 선형 회귀. 여기서는 길이의 제곱을 특성으로 추가해 2차 방정식(곡선) 을 학습한다
1
2
train_poly = np.column_stack((train_input ** 2, train_input))
test_poly = np.column_stack((test_input ** 2, test_input))
1
print(train_poly.shape, test_poly.shape)
1
(42, 2) (14, 2)
- 타깃값은 그대로 두고 입력 특성만 제곱해서 추가한다
1
2
3
4
lr = LinearRegression()
lr.fit(train_poly, train_target)

print(lr.predict([[50**2, 50]]))
1
[1573.98423528]
1
print(lr.coef_, lr.intercept_)
1
[  1.01433211 -21.55792498] 116.0502107827827
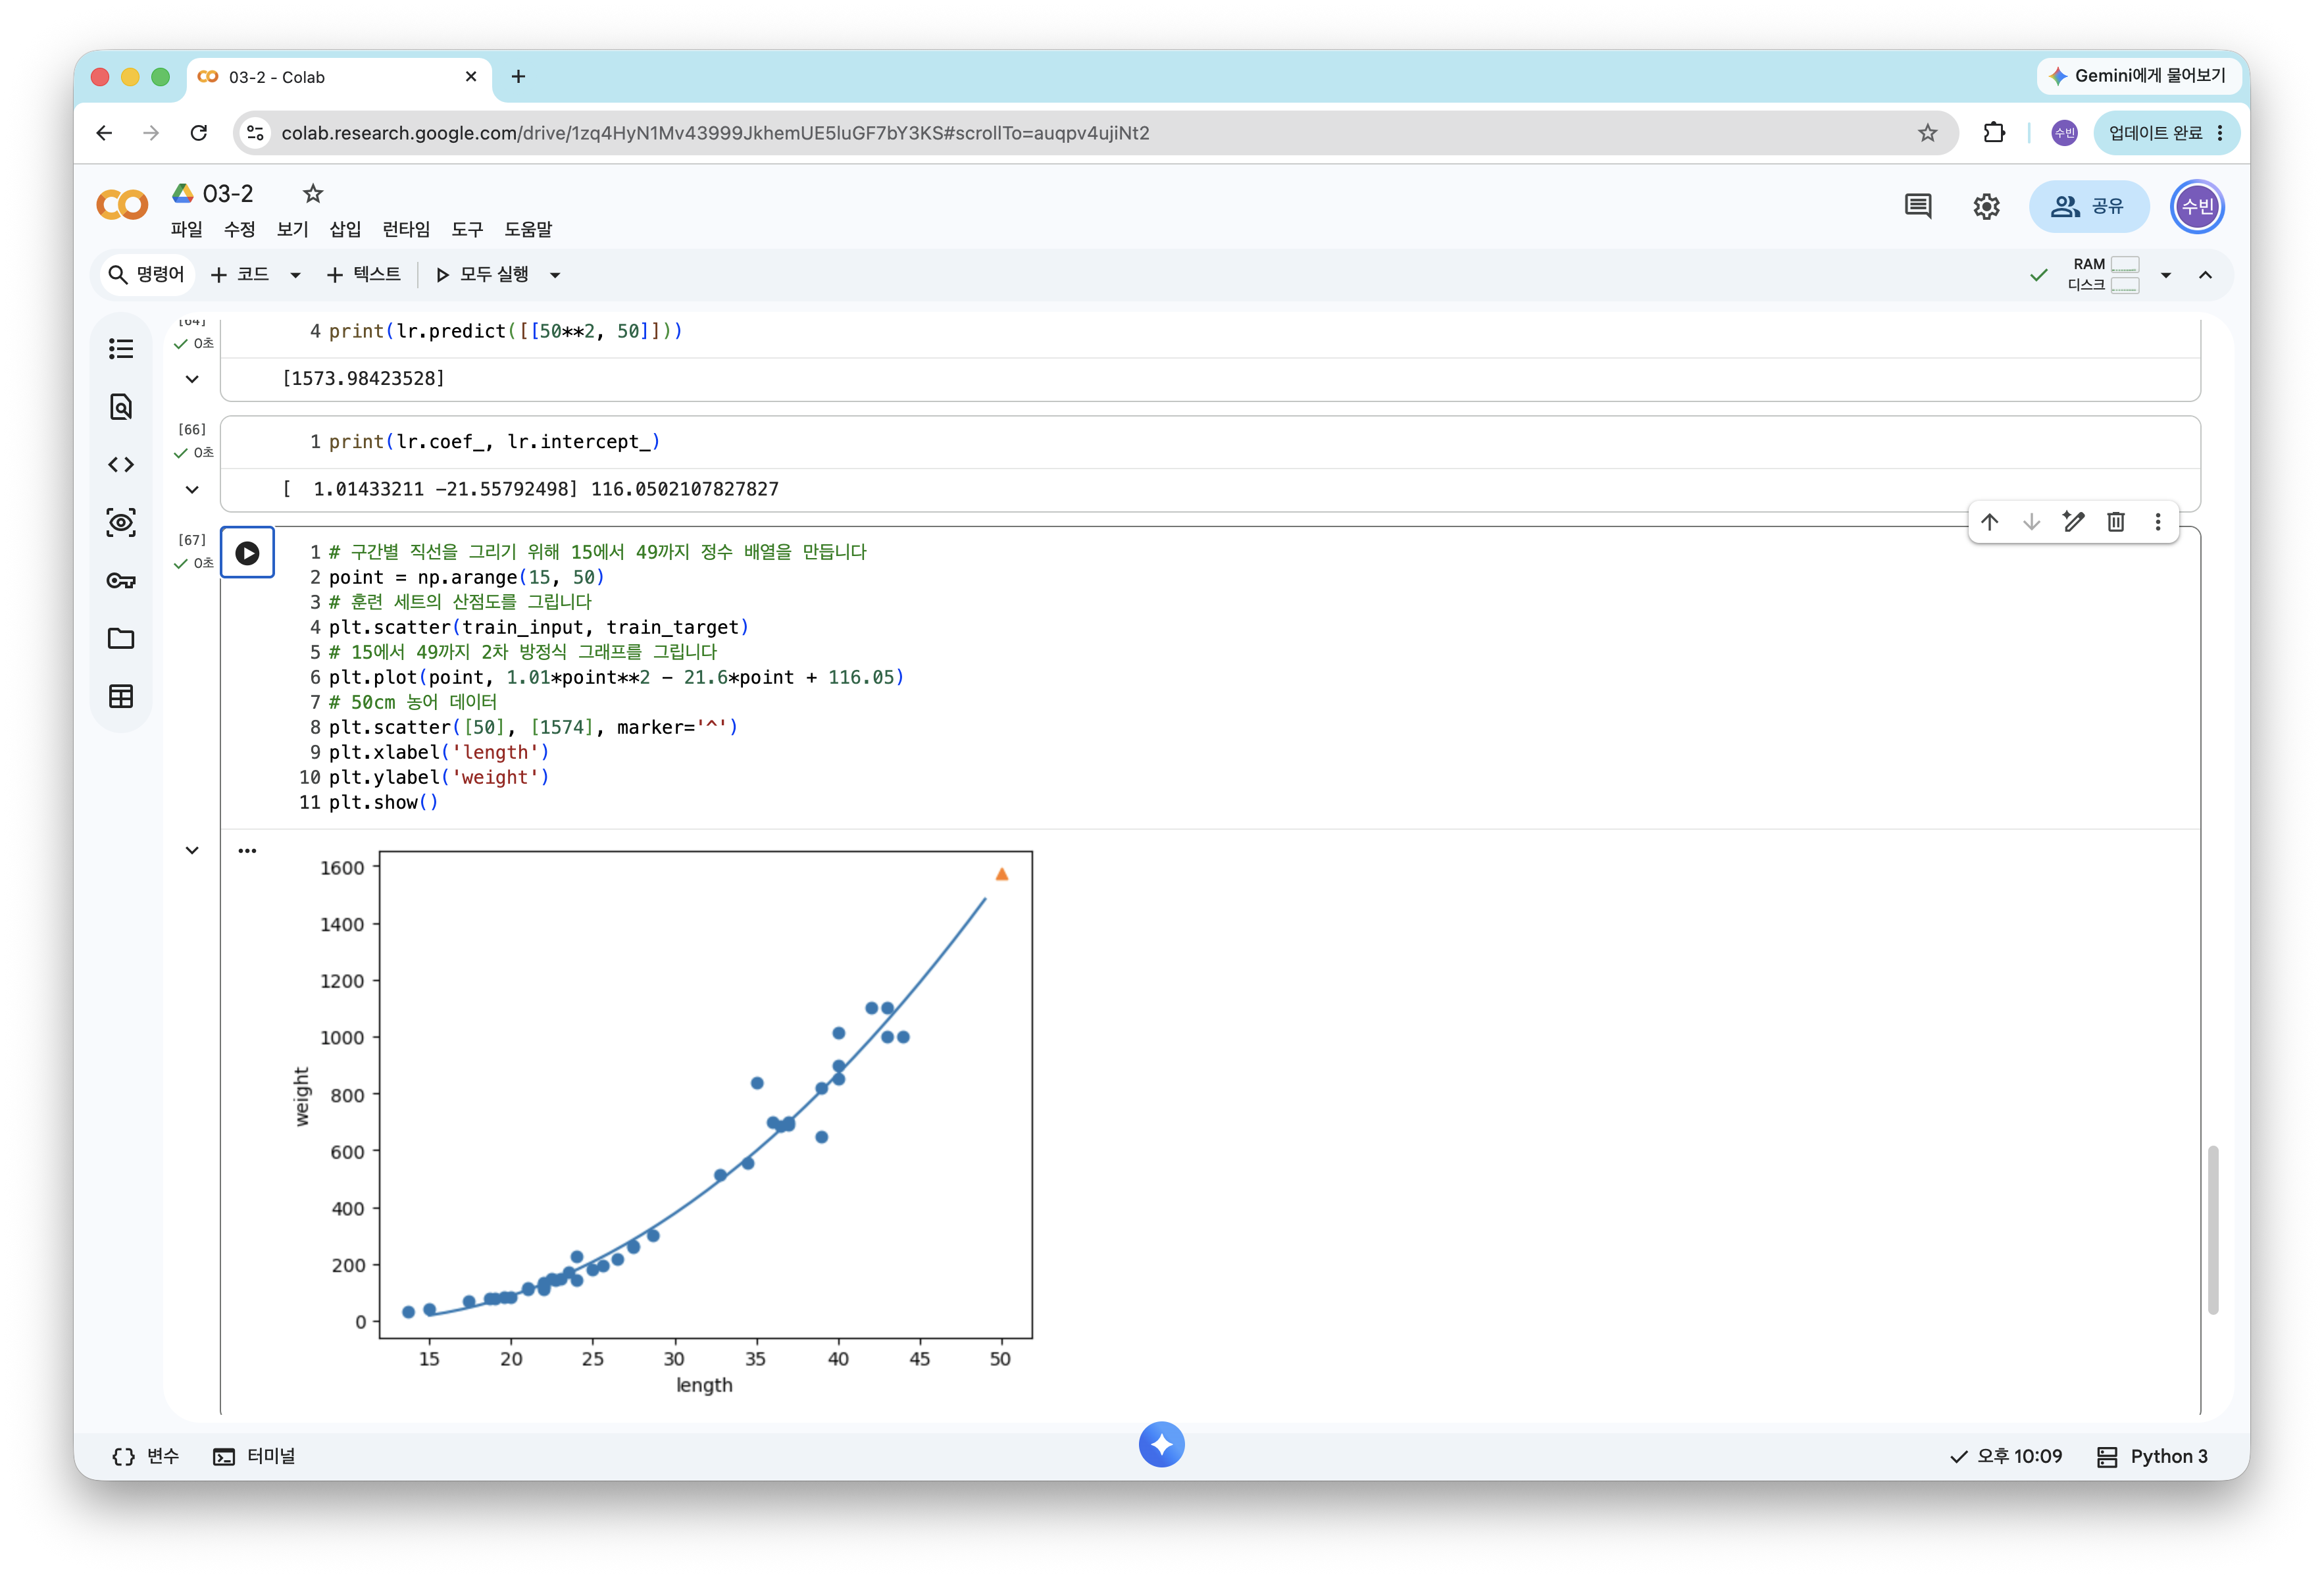
- 농어 무게 = 1.01 × 길이² − 21.6 × 길이 + 116.05
1
2
3
4
5
6
7
8
9
10
11
# 구간별 직선을 그리기 위해 15에서 49까지 정수 배열을 만듭니다
point = np.arange(15, 50)
# 훈련 세트의 산점도를 그립니다
plt.scatter(train_input, train_target)
# 15에서 49까지 2차 방정식 그래프를 그립니다
plt.plot(point, 1.01*point**2 - 21.6*point + 116.05)
# 50cm 농어 데이터
plt.scatter([50], [1574], marker='^')
plt.xlabel('length')
plt.ylabel('weight')
plt.show()
1
2
print(lr.score(train_poly, train_target))
print(lr.score(test_poly, test_target))
1
2
0.9706807451768623
0.9775935108325122
- 단순 선형 회귀보다 점수가 크게 올랐지만, 여전히 테스트 점수가 조금 높다 → 과소적합이 남아 있다
선형 회귀로 훈련 세트 범위 밖의 샘플 예측
이번 절의 문제 해결 과정을 정리하면 다음과 같다.
- 문제 인식: 50cm, 100cm 농어를 모두 1033g으로 예측 → k-최근접 이웃은 훈련 세트 범위 밖을 예측하지 못한다
- 해결 시도 1:
LinearRegression으로 직선을 학습 → 범위 밖도 예측할 수 있지만 과소적합, 음수 무게 문제 - 해결 시도 2: 길이의 제곱을 특성으로 추가한 다항 회귀 → 곡선을 학습해 점수가 크게 향상
- 남은 과제: 여전히 과소적합 → 3절에서 특성을 더 추가해 본다
03-3. 특성 공학과 규제
다중 회귀
: 여러 개의 특성을 사용한 선형 회귀
- 특성이 1개면 직선, 2개면 평면을 학습한다. 특성이 3개 이상이면 그림으로 그릴 수 없지만 원리는 같다
- 특성 공학(feature engineering): 기존 특성을 사용해 새로운 특성을 만들어 내는 작업
- 예: 농어 길이 × 농어 높이를 새로운 특성으로 추가
데이터 준비
1
import pandas as pd
1
2
perch_full = pd.read_csv('https://bit.ly/perch_csv_data')
perch_full.head()
1
2
3
4
5
6
   length   height   width
0     8.4     2.11    1.41
1    13.7     3.53    2.00
2    15.0     3.82    2.43
3    16.2     4.59    2.63
4    17.4     4.59    2.94
- 판다스(pandas): 데이터 분석 라이브러리. 데이터프레임(DataFrame) 이 대표 자료구조다
read_csv()로 CSV 파일을 읽어 데이터프레임으로 만들고, 넘파이 배열로 바꿔 사용할 수 있다- 이제 특성이 길이·높이·두께 3개가 되었다
1
2
3
4
5
6
7
8
9
10
11
import numpy as np

perch_weight = np.array(
    [5.9, 32.0, 40.0, 51.5, 70.0, 100.0, 78.0, 80.0, 85.0, 85.0,
     110.0, 115.0, 125.0, 130.0, 120.0, 120.0, 130.0, 135.0, 110.0,
     130.0, 150.0, 145.0, 150.0, 170.0, 225.0, 145.0, 188.0, 180.0,
     197.0, 218.0, 300.0, 260.0, 265.0, 250.0, 250.0, 300.0, 320.0,
     514.0, 556.0, 840.0, 685.0, 700.0, 700.0, 690.0, 900.0, 650.0,
     820.0, 850.0, 900.0, 1015.0, 820.0, 1100.0, 1000.0, 1100.0,
     1000.0, 1000.0]
     )
1
2
3
from sklearn.model_selection import train_test_split

train_input, test_input, train_target, test_target = train_test_split(perch_full, perch_weight, random_state=42)
사이킷런의 변환기
: 특성을 만들거나 전처리하는 사이킷런의 클래스. fit(), transform() 메서드를 제공한다
1
from sklearn.preprocessing import PolynomialFeatures
1
2
3
poly = PolynomialFeatures()
poly.fit([[2, 3]])
print(poly.transform([[2, 3]]))
1
[[1. 2. 3. 4. 6. 9.]]
PolynomialFeatures: 각 특성을 제곱한 항과 특성끼리 곱한 항을 추가한다- 맨 앞의
1은 절편을 위한 항이다. 사이킷런 모델은 절편을 자동으로 추가하므로 필요 없다
1
2
3
poly = PolynomialFeatures(include_bias=False)
poly.fit([[2, 3]])
print(poly.transform([[2, 3]]))
1
[[2. 3. 4. 6. 9.]]
1
2
3
4
poly = PolynomialFeatures(include_bias=False)

poly.fit(train_input)
train_poly = poly.transform(train_input)
1
print(train_poly.shape)
1
(42, 9)
1
poly.get_feature_names_out()
get_feature_names_out(): 만들어진 특성이 어떤 조합으로 이루어졌는지 알려 준다- 훈련 세트로
fit()한 변환기를 그대로 사용해 테스트 세트를 변환해야 한다
1
test_poly = poly.transform(test_input)
다중 회귀 모델 훈련하기
1
2
3
4
5
from sklearn.linear_model import LinearRegression

lr = LinearRegression()
lr.fit(train_poly, train_target)
print(lr.score(train_poly, train_target))
1
0.9903183436982125
1
print(lr.score(test_poly, test_target))
1
0.9714559911594111
- 특성을 늘렸더니 훈련 세트 점수가 크게 올랐고, 과소적합 문제가 사라졌다
1
2
3
4
5
poly = PolynomialFeatures(degree=5, include_bias=False)

poly.fit(train_input)
train_poly = poly.transform(train_input)
test_poly = poly.transform(test_input)
1
print(train_poly.shape)
1
(42, 55)
1
2
lr.fit(train_poly, train_target)
print(lr.score(train_poly, train_target))
1
0.9999999999996433
1
print(lr.score(test_poly, test_target))
1
-144.40579436844948
- 특성을 55개까지 늘리니 훈련 세트는 거의 완벽하게 맞히지만 테스트 세트 점수는 음수가 되었다
- 특성 개수가 샘플 개수보다 많아지면 훈련 세트에 완전히 맞춰져 심각한 과대적합이 일어난다
규제
: 모델이 훈련 세트에 과대적합되지 않도록 계수(기울기)의 크기를 줄여 훼방을 놓는 것
1
2
3
4
5
6
7
from sklearn.preprocessing import StandardScaler

ss = StandardScaler()
ss.fit(train_poly)

train_scaled = ss.transform(train_poly)
test_scaled = ss.transform(test_poly)
- 규제를 적용하기 전에 특성의 스케일을 정규화해야 한다. 스케일이 다르면 계수에 곱해지는 규제의 영향도 달라지기 때문
StandardScaler: 표준점수로 변환해 주는 사이킷런의 변환기. 2장에서 직접 계산한 것을 대신해 준다- 선형 회귀에 규제를 더한 모델이 릿지(ridge) 와 라쏘(lasso) 다
릿지 회귀
: 계수를 제곱한 값을 기준으로 규제를 적용하는 모델
1
2
3
4
5
from sklearn.linear_model import Ridge

ridge = Ridge()
ridge.fit(train_scaled, train_target)
print(ridge.score(train_scaled, train_target))
1
0.9896101671037343
1
print(ridge.score(test_scaled, test_target))
1
0.9790693977615387
- 특성이 55개인데도 훈련 세트 점수가 조금 낮아지고 테스트 세트 점수는 정상으로 돌아왔다
1
2
3
4
import matplotlib.pyplot as plt

train_score = []
test_score = []
1
2
3
4
5
6
7
8
9
alpha_list = [0.001, 0.01, 0.1, 1, 10, 100]
for alpha in alpha_list:
    # 릿지 모델을 만듭니다
    ridge = Ridge(alpha=alpha)
    # 릿지 모델을 훈련합니다
    ridge.fit(train_scaled, train_target)
    # 훈련 점수와 테스트 점수를 저장합니다
    train_score.append(ridge.score(train_scaled, train_target))
    test_score.append(ridge.score(test_scaled, test_target))
1
2
3
4
5
6
plt.plot(alpha_list, train_score)
plt.plot(alpha_list, test_score)
plt.xscale('log')
plt.xlabel('alpha')
plt.ylabel('R^2')
plt.show()
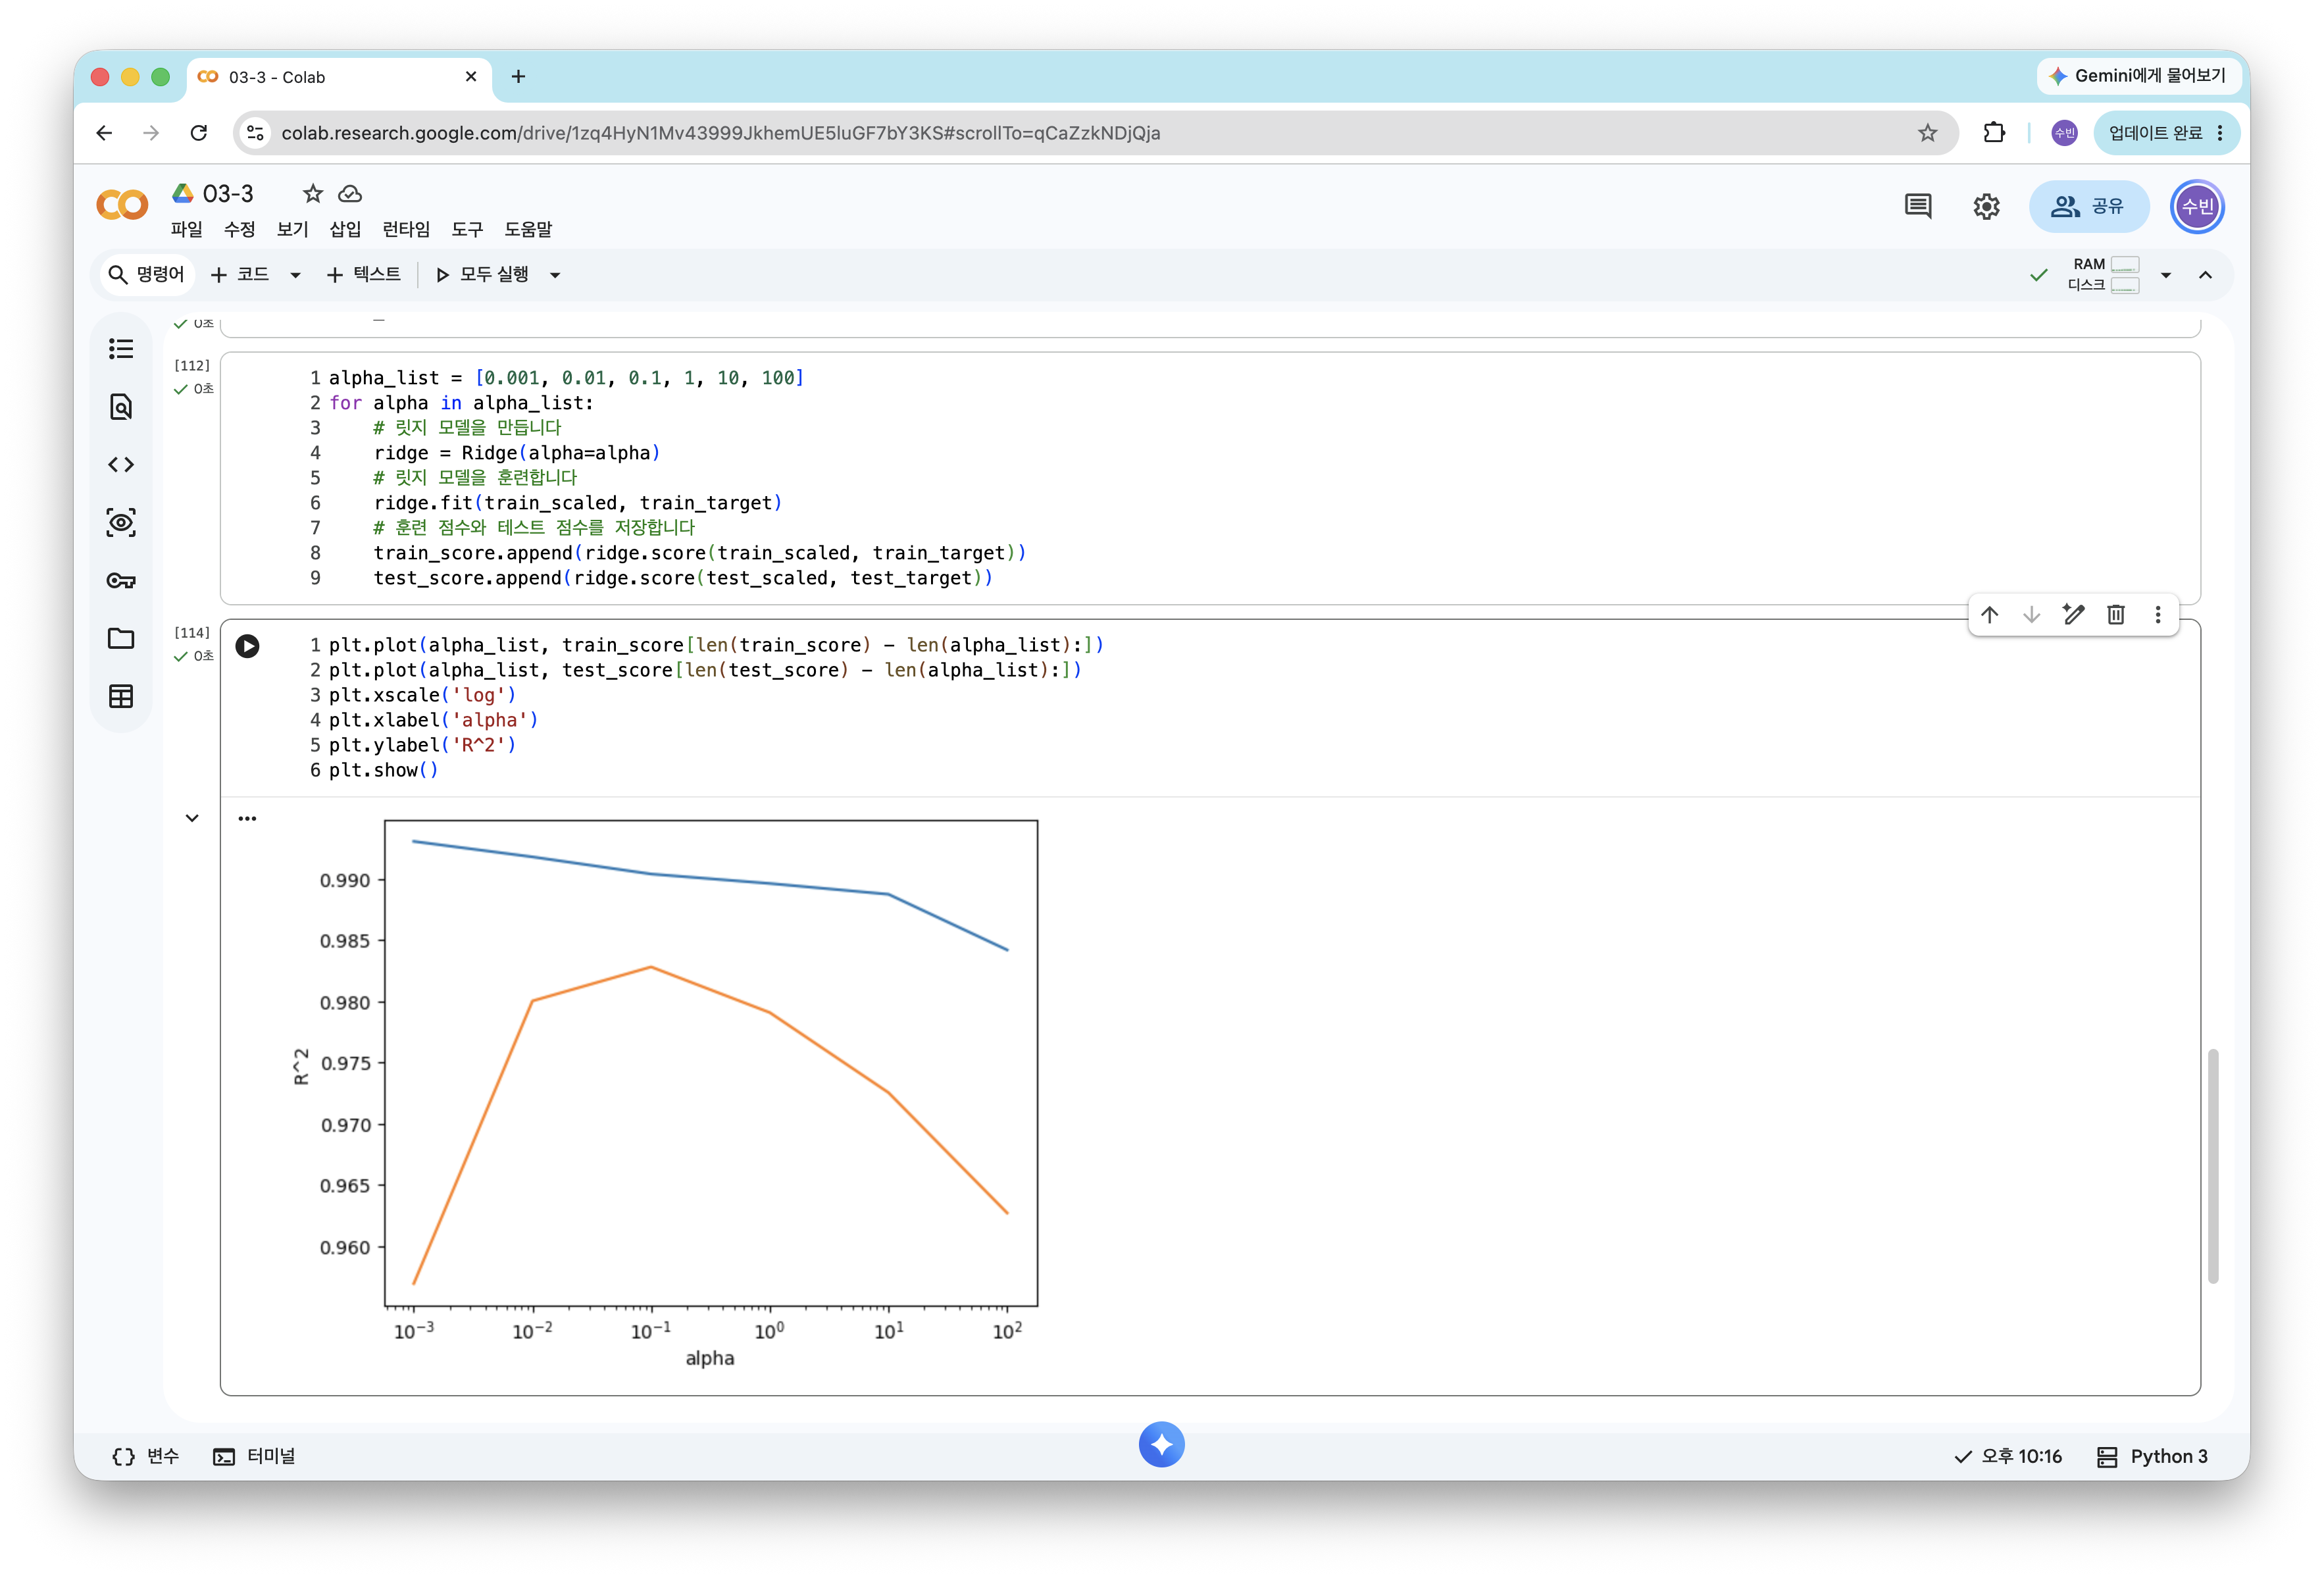
- alpha: 규제의 강도를 조절하는 매개변수. 값이 크면 규제가 세져 과소적합 쪽으로, 작으면 과대적합 쪽으로 간다
- 하이퍼파라미터(hyperparameter): 모델이 학습하는 값이 아니라 사람이 지정해야 하는 값
- alpha 값을 로그 스케일(0.001, 0.01, …)로 바꿔 가며 그래프를 그리면, 두 점수가 가장 가깝고 테스트 점수가 가장 높은 지점이 보인다
1
2
3
4
5
ridge = Ridge(alpha=0.1)
ridge.fit(train_scaled, train_target)

print(ridge.score(train_scaled, train_target))
print(ridge.score(test_scaled, test_target))
1
2
0.9903815817570367
0.9827976465386928
라쏘 회귀
: 계수의 절댓값을 기준으로 규제를 적용하는 모델. 계수를 아예 0으로 만들 수도 있다
1
2
3
4
5
from sklearn.linear_model import Lasso

lasso = Lasso()
lasso.fit(train_scaled, train_target)
print(lasso.score(train_scaled, train_target))
1
0.989789897208096
1
print(lasso.score(test_scaled, test_target))
1
0.9800593698421883
1
2
3
4
5
6
7
8
9
10
11
12
train_score = []
test_score = []

alpha_list = [0.001, 0.01, 0.1, 1, 10, 100]
for alpha in alpha_list:
    # 라쏘 모델을 만듭니다
    lasso = Lasso(alpha=alpha, max_iter=10000)
    # 라쏘 모델을 훈련합니다
    lasso.fit(train_scaled, train_target)
    # 훈련 점수와 테스트 점수를 저장합니다
    train_score.append(lasso.score(train_scaled, train_target))
    test_score.append(lasso.score(test_scaled, test_target))
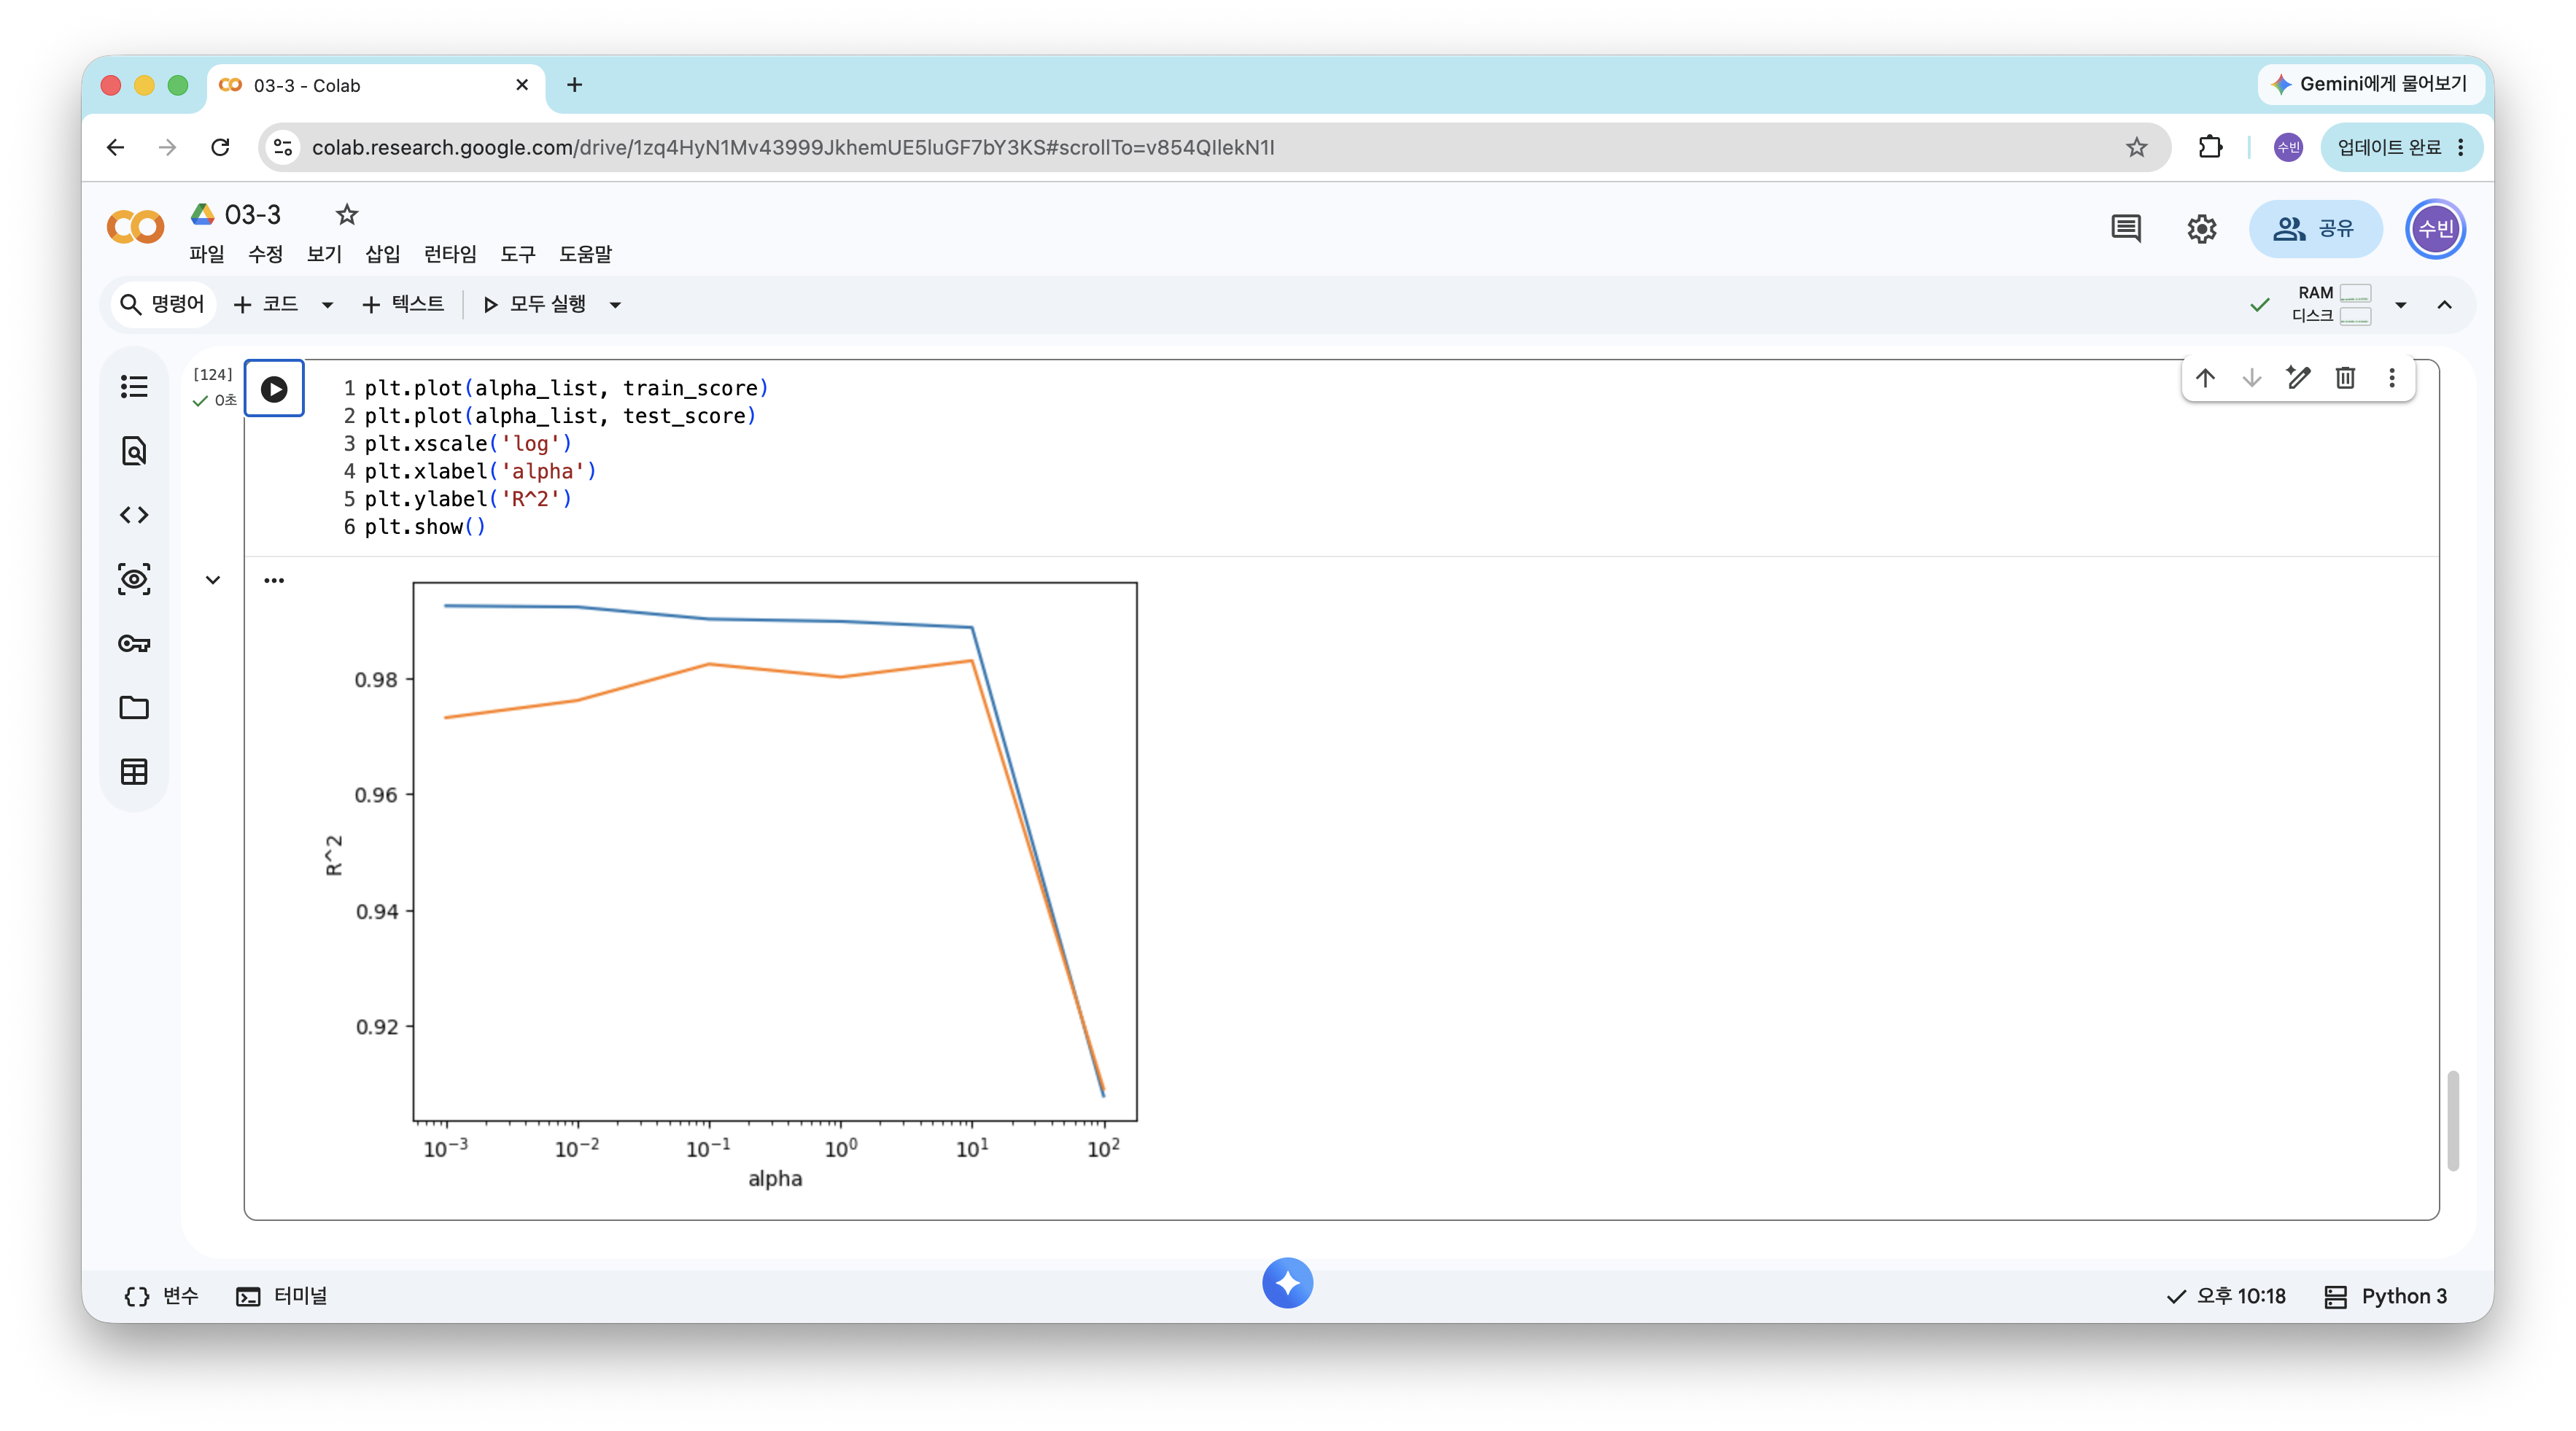
- 라쏘는 최적의 계수를 반복 계산으로 찾기 때문에, 반복 횟수가 부족하면 경고가 뜬다 →
max_iter로 늘려 준다
1
2
3
4
5
6
plt.plot(alpha_list, train_score)
plt.plot(alpha_list, test_score)
plt.xscale('log')
plt.xlabel('alpha')
plt.ylabel('R^2')
plt.show()
1
2
3
4
5
lasso = Lasso(alpha=10)
lasso.fit(train_scaled, train_target)

print(lasso.score(train_scaled, train_target))
print(lasso.score(test_scaled, test_target))
1
2
0.9888067471131867
0.9824470598706695
1
print(np.sum(lasso.coef_ == 0))
1
40
- 55개 특성 중 40개의 계수가 0이 되었다. 즉 라쏘가 실제로 사용한 특성은 15개뿐이다
- 이 성질 덕분에 라쏘는 유용한 특성을 골라내는 용도로도 쓸 수 있다
모델의 과대적합을 제어하기
이번 절의 문제 해결 과정을 정리하면 다음과 같다.
- 특성 추가: 길이 하나만 쓰던 것을 길이·높이·두께로 늘리고,
PolynomialFeatures로 특성을 더 만듦 (특성 공학) - 과대적합 발생: 특성을 55개까지 늘리자 훈련 점수는 1에 가깝고 테스트 점수는 음수
- 정규화:
StandardScaler로 특성의 스케일을 맞춤 - 규제 적용: 릿지(계수 제곱)와 라쏘(계수 절댓값)로 계수 크기를 제한
- 하이퍼파라미터 탐색: alpha를 바꿔 가며 훈련/테스트 점수 그래프를 그려 최적값 선택 (릿지 0.1, 라쏘 10)
- 특성을 늘리면 모델이 강력해지지만 과대적합의 위험도 같이 커진다. 규제로 이를 조절한다
📌 정리
- 타깃이 숫자인 회귀 문제를 k-최근접 이웃 회귀 → 선형 회귀 → 다항 회귀 순서로 풀었다
- 회귀의
score()는 정확도가 아니라 결정계수(R²) 이고, MAE로 오차 크기를 직접 확인할 수 있다 - k-최근접 이웃은 훈련 세트 범위 밖을 예측하지 못한다 → 선형 회귀로 해결했다
- 특성을 늘리면 모델이 강해지지만 과대적합 위험도 커진다 → 릿지·라쏘 규제와 alpha로 제어한다
핵심 용어: 회귀 / 결정계수(R²) / 평균 절댓값 오차 / 과대적합 / 과소적합 / 모델 파라미터 / 다항 회귀 / 다중 회귀 / 특성 공학 / 변환기 / 규제 / 릿지 / 라쏘 / 하이퍼파라미터
This post is licensed under CC BY 4.0 by the author.