[혼자 공부하는 머신러닝+딥러닝] 1장. 나의 첫 머신러닝
[혼자 공부하는 머신러닝+딥러닝] 1장. 나의 첫 머신러닝
“혼자 공부하는 머신러닝+딥러닝(개정판)” 도서 바로가기
예제 코드 (저자 제공): 01-3
1장. 나의 첫 머신러닝
01-1. 인공지능과 머신러닝, 딥러닝
인공지능이란
: 사람처럼 학습하고 추론할 수 있는 지능을 가진 컴퓨터 시스템을 만드는 기술
- 인공지능의 역사
- 1943년, 매컬러-피츠 뉴런: 뇌의 뉴런을 수학 모델로 표현한 최초의 시도
- 1950년, 튜링 테스트: 기계가 지능을 가졌는지 판별하는 기준 제안
- 1956년, 다트머스 회의: “인공지능(Artificial Intelligence)”이라는 용어가 처음 쓰인 자리 → 인공지능 태동기
- 이후 기대에 못 미치는 성과로 두 번의 인공지능 겨울(AI winter) 을 겪음
- 인공지능의 분류
- 강인공지능(인공일반지능, AGI): 사람과 구분할 수 없을 정도로 지능적인, 사람이 하는 모든 일을 할 수 있는 인공지능 (영화 속 인공지능)
- 약인공지능(Narrow AI): 특정 분야에서 사람의 일을 보조하는 수준의 인공지능 (음성 비서, 번역기, 추천 시스템 등 현재의 인공지능)
머신러닝이란
: 규칙을 하나하나 프로그래밍하지 않아도 데이터에서 규칙을 자동으로 학습하는 알고리즘을 연구하는 분야
- 인공지능의 하위 분야이며, 지능을 구현할 소프트웨어를 담당하는 핵심 분야
- 통계학과 깊은 관련이 있다. 통계학에서 유래한 알고리즘이 많고, 반대로 컴퓨터 과학 쪽에서 발전한 알고리즘도 통계학으로 설명된다.
- 대표 라이브러리: 사이킷런(scikit-learn)
- 파이썬 API를 제공하는 오픈소스 라이브러리
- 검증된 알고리즘만 추가하기 때문에 안정적이고, 사용법이 통일되어 있어 배우기 쉽다
딥러닝이란
: 머신러닝 알고리즘 중 인공 신경망(artificial neural network) 을 기반으로 한 방법들을 통칭하는 말
- 신경망이 주목받게 된 계기
- 1998년, 얀 르쿤의 LeNet-5 (합성곱 신경망으로 손글씨 숫자 인식)
- 2012년, 제프리 힌턴 팀의 AlexNet (이미지넷 대회에서 압도적 성적)
- 성공 배경: 풍부한 데이터, GPU 등 컴퓨터 성능 향상, 알고리즘 개선
- 대표 오픈소스 라이브러리
- 텐서플로(TensorFlow): 2015년 구글 공개. 케라스(Keras) API로 사용
- 파이토치(PyTorch): 2016년 페이스북(현 메타) 공개 (2018년 1.0 정식 출시)
- 포함 관계: 인공지능 ⊃ 머신러닝 ⊃ 딥러닝
01-2. 코랩과 주피터 노트북
구글 코랩
: 웹 브라우저에서 파이썬 코드를 작성하고 실행할 수 있는 클라우드 기반 주피터 노트북 개발 환경
- 구글 계정만 있으면 무료로 사용할 수 있고, 별도의 설치나 환경 설정이 필요 없다
- 실제 코드는 내 컴퓨터가 아니라 구글 클라우드의 가상 서버(VM) 에서 실행된다
- 무료 버전은 사용 시간·메모리·동시 세션 수에 제한이 있다
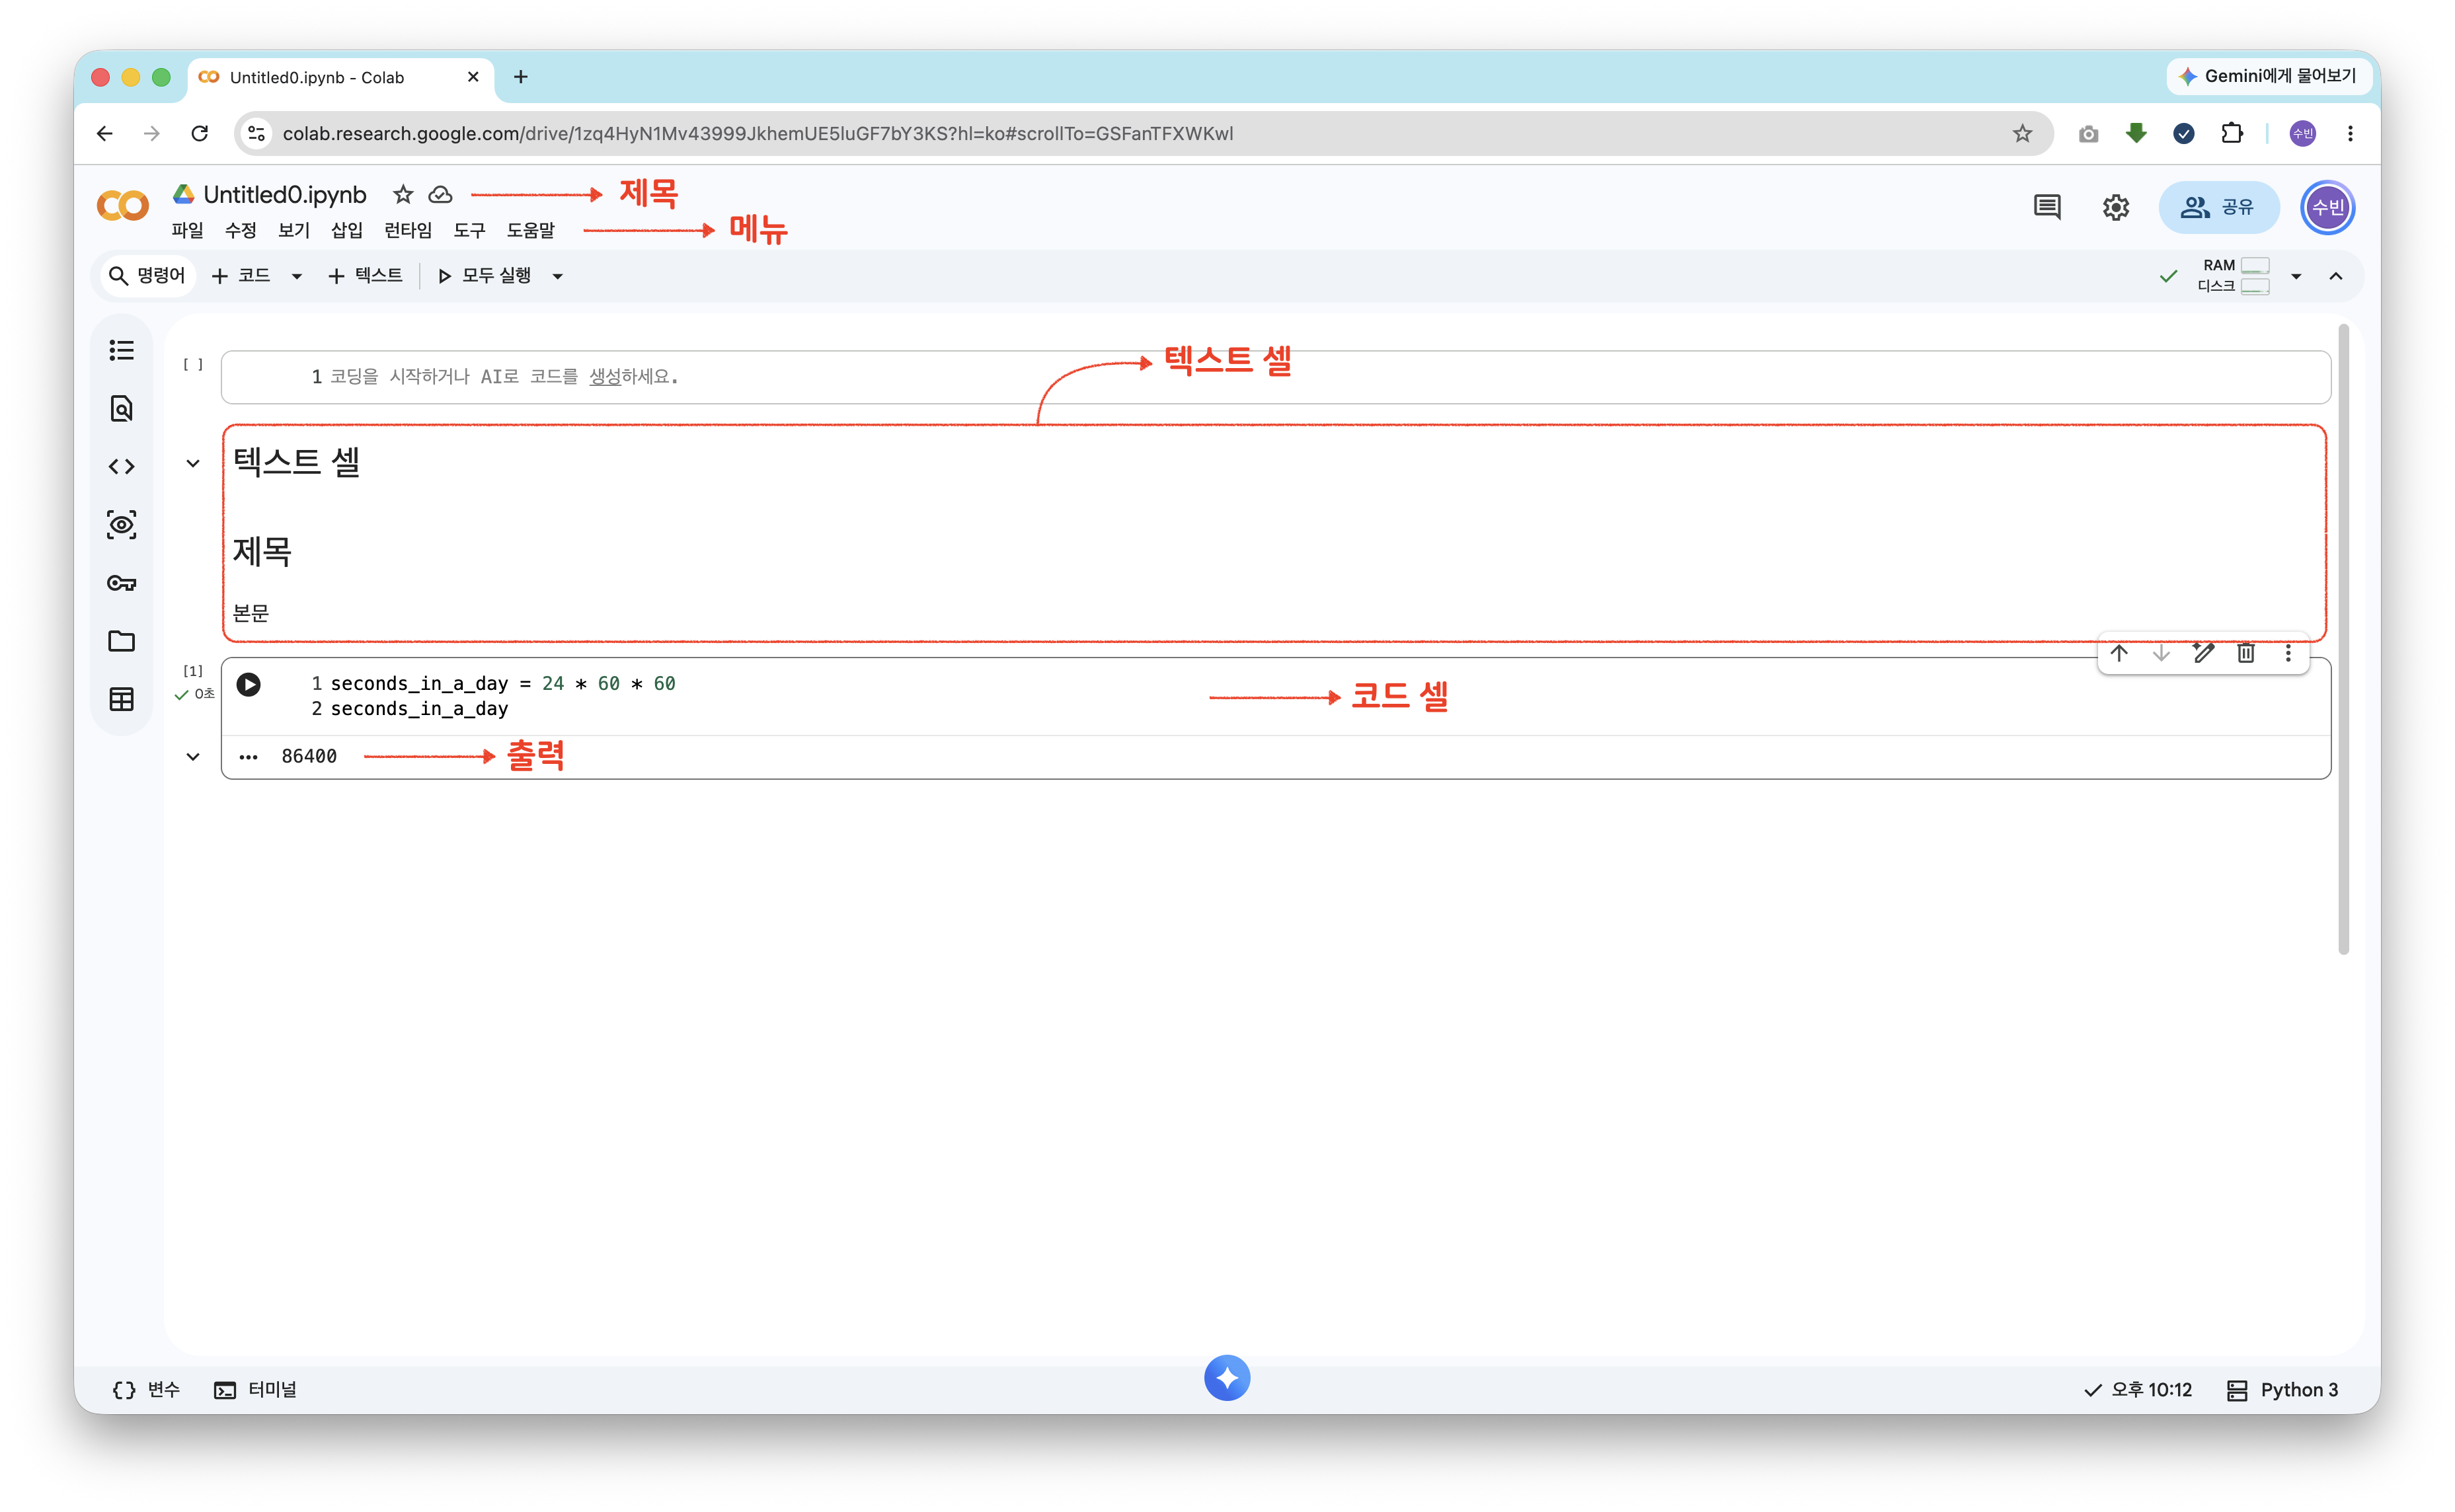
텍스트 셀
: 설명을 적는 셀
- 마크다운과 HTML 태그를 사용할 수 있다
- 제목, 목록, 링크, 이미지, 수식(LaTeX) 등을 넣어 문서처럼 정리할 수 있다
- 편집 중에는 입력한 마크다운과 렌더링 결과가 함께 보인다
코드 셀
: 파이썬 코드를 작성하고 실행하는 셀
- 셀 단위로 실행되며, 실행 결과가 셀 바로 아래에 출력된다
- 실행한 순서대로 번호가 매겨지고, 변수는 세션 전체에서 공유된다
노트북
: 코랩의 기본 단위이자, 코드·텍스트·실행 결과를 하나의 문서에 담는 대화식 프로그래밍 환경
- 구성: 코드 셀 + 텍스트 셀 + 코드 실행 결과
- 작성한 노트북은 구글 드라이브의
Colab Notebooks폴더에 자동 저장된다 - 깃허브에 올려 둔 노트북을 코랩에서 바로 열 수도 있다
01-3. 마켓과 머신러닝
생선 분류 문제
- 상황: 생선 이름을 자동으로 알려 주는 프로그램이 필요하다
- 규칙 기반으로 짜면 “길이가 30cm 이상이면 도미” 같은 조건을 사람이 정해야 하는데, 예외가 계속 생긴다
- → 기준을 사람이 정하지 않고 데이터에서 스스로 찾게 하는 것이 머신러닝
- 사용 데이터: 도미(bream) 35마리 + 빙어(smelt) 14마리, 총 49개의 길이와 무게 데이터
- 특성(feature): 데이터의 성질을 나타내는 값. 여기서는 길이와 무게 두 가지
1
2
3
4
5
6
bream_length = [25.4, 26.3, 26.5, 29.0, 29.0, 29.7, 29.7, 30.0, 30.0, 30.7, 31.0, 31.0,
                31.5, 32.0, 32.0, 32.0, 33.0, 33.0, 33.5, 33.5, 34.0, 34.0, 34.5, 35.0,
                35.0, 35.0, 35.0, 36.0, 36.0, 37.0, 38.5, 38.5, 39.5, 41.0, 41.0]
bream_weight = [242.0, 290.0, 340.0, 363.0, 430.0, 450.0, 500.0, 390.0, 450.0, 500.0, 475.0, 500.0,
                500.0, 340.0, 600.0, 600.0, 700.0, 700.0, 610.0, 650.0, 575.0, 685.0, 620.0, 680.0,
                700.0, 725.0, 720.0, 714.0, 850.0, 1000.0, 920.0, 955.0, 925.0, 975.0, 950.0]
1
2
3
4
5
6
import matplotlib.pyplot as plt

plt.scatter(bream_length, bream_weight)
plt.xlabel('length')
plt.ylabel('weight')
plt.show()
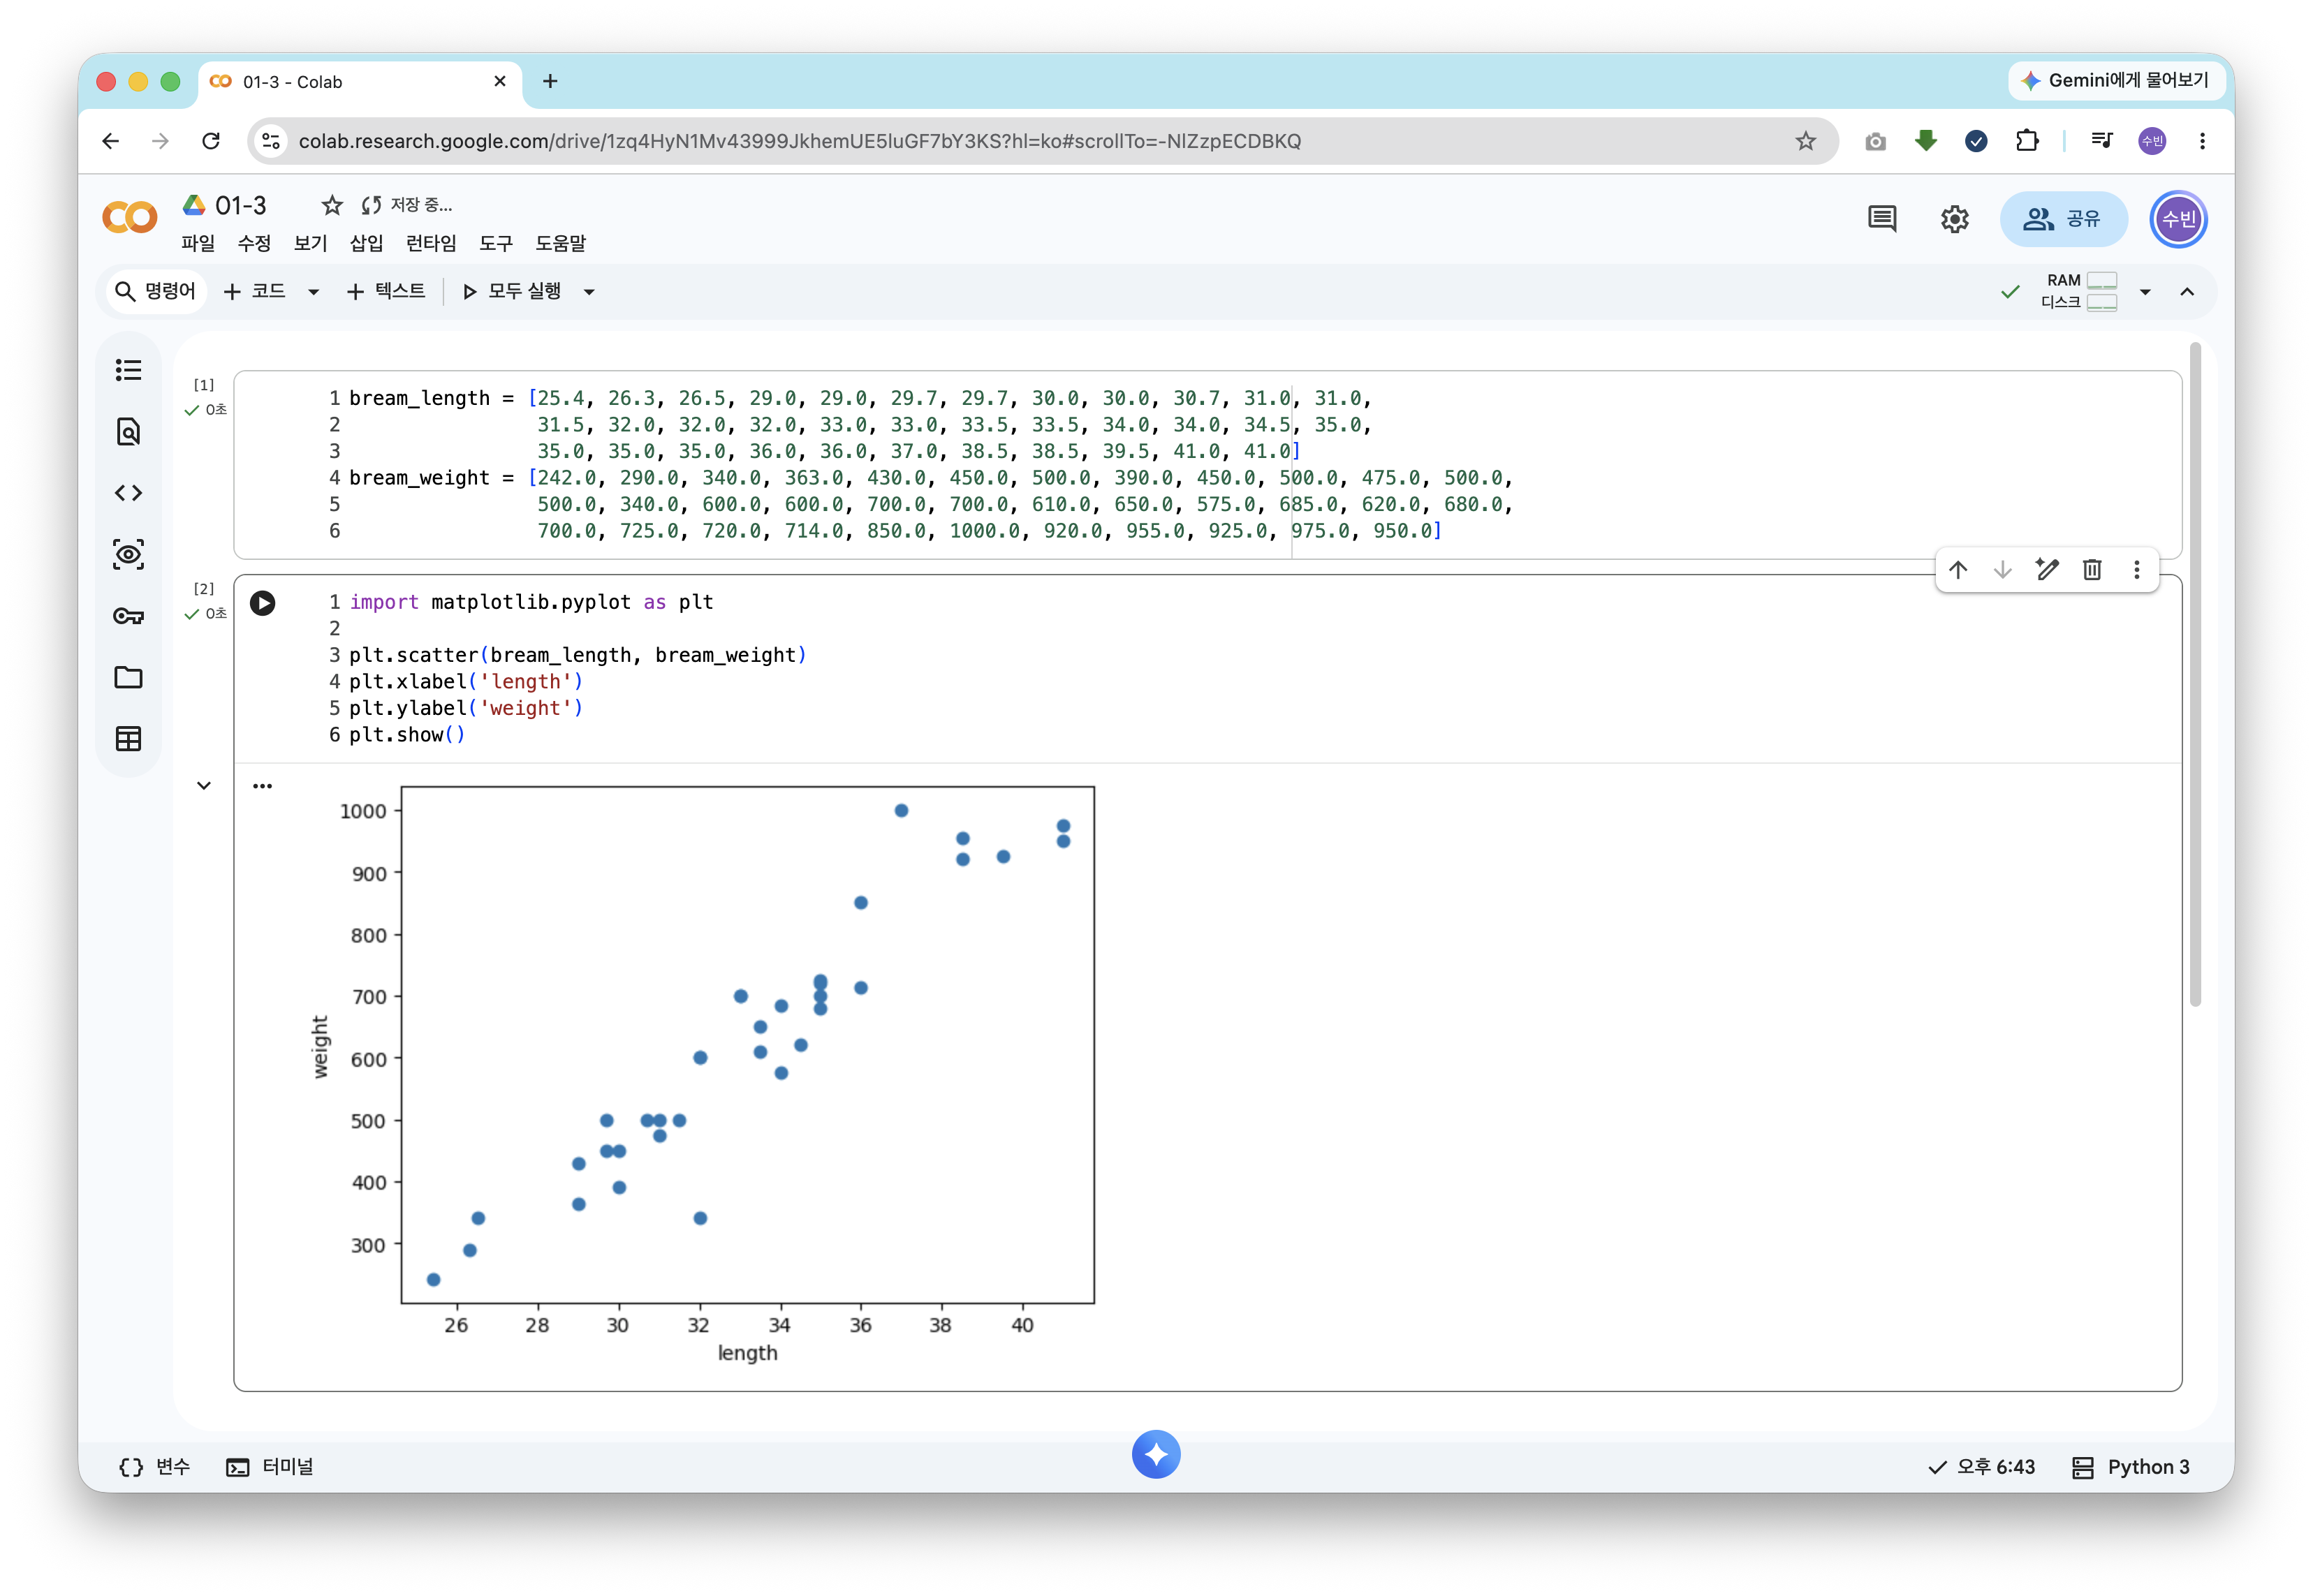
- 산점도(scatter plot): x축과 y축을 두 특성으로 두고 데이터를 점으로 찍어 표현한 그래프
- 도미 데이터는 길이가 길수록 무게가 늘어나는 선형적인 모습을 보인다
1
2
smelt_length = [9.8, 10.5, 10.6, 11.0, 11.2, 11.3, 11.8, 11.8, 12.0, 12.2, 12.4, 13.0, 14.3, 15.0]
smelt_weight = [6.7, 7.5, 7.0, 9.7, 9.8, 8.7, 10.0, 9.9, 9.8, 12.2, 13.4, 12.2, 19.7, 19.9]
1
2
3
4
5
plt.scatter(bream_length, bream_weight)
plt.scatter(smelt_length, smelt_weight)
plt.xlabel('length')
plt.ylabel('weight')
plt.show()
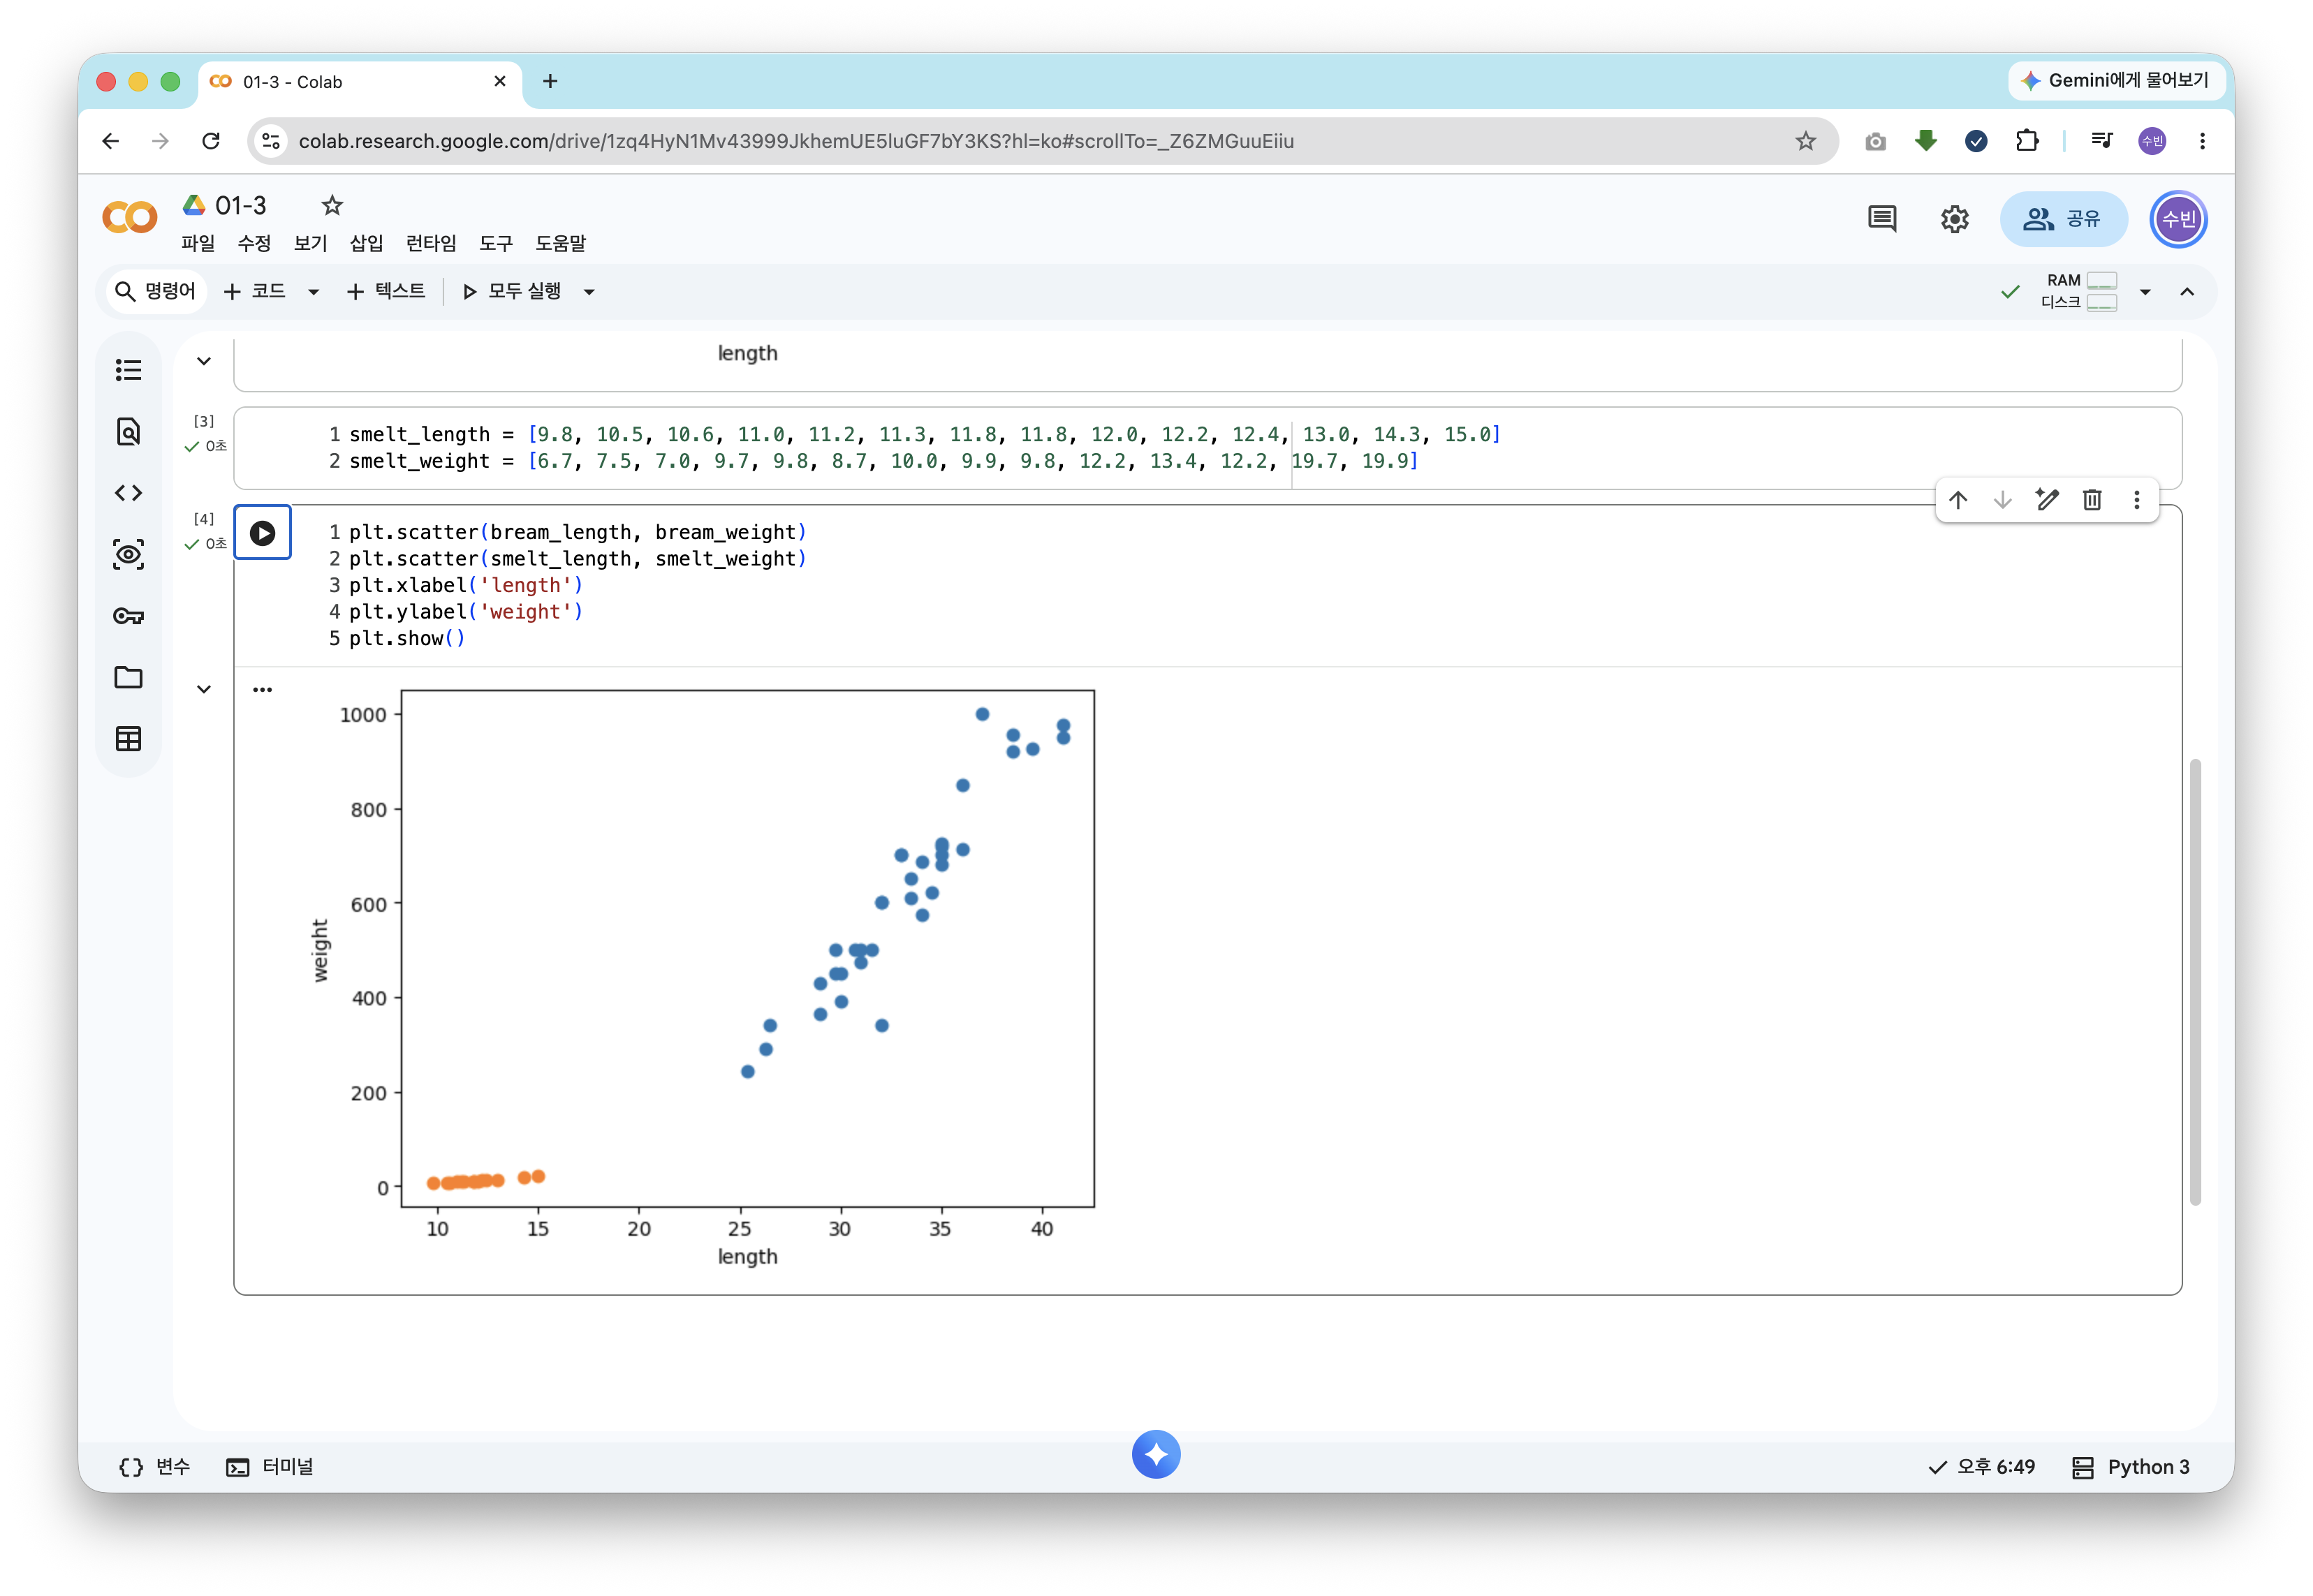
- 두 생선을 함께 그리면 뚜렷하게 다른 영역에 모여 있는 것이 보인다 (주황색이 빙어)
- 빙어도 길이가 늘수록 무게가 늘지만, 도미에 비해 기울기가 완만하다
첫 번째 머신러닝 프로그램
- 사용 알고리즘: k-최근접 이웃(K-Nearest Neighbors, KNN)
- 어떤 데이터를 예측할 때 가장 가까운 이웃 k개를 보고 다수인 쪽으로 판단하는 알고리즘
- 훈련이랄 게 따로 없고 데이터를 전부 가지고 있다가 비교하는 방식이라 데이터가 크면 메모리와 계산량이 많이 든다
- 사이킷런의 기본값은
n_neighbors=5(가까운 5개를 참고)
1
2
3
4
5
length = bream_length + smelt_length
weight = bream_weight + smelt_weight

fish_data = [[l, w] for l, w in zip(length, weight)]
print(fish_data)
1
2
fish_target = [1] * 35 + [0] * 14
print(fish_target)
- 사이킷런은 각 샘플의 특성을 리스트로 묶은 2차원 리스트를 입력으로 기대한다
fish_target: 찾으려는 대상(도미)을 1, 나머지(빙어)를 0으로 둔 정답 데이터
1
2
3
4
5
from sklearn.neighbors import KNeighborsClassifier

kn = KNeighborsClassifier()
kn.fit(fish_data, fish_target)
kn.score(fish_data, fish_target)
1
1.0
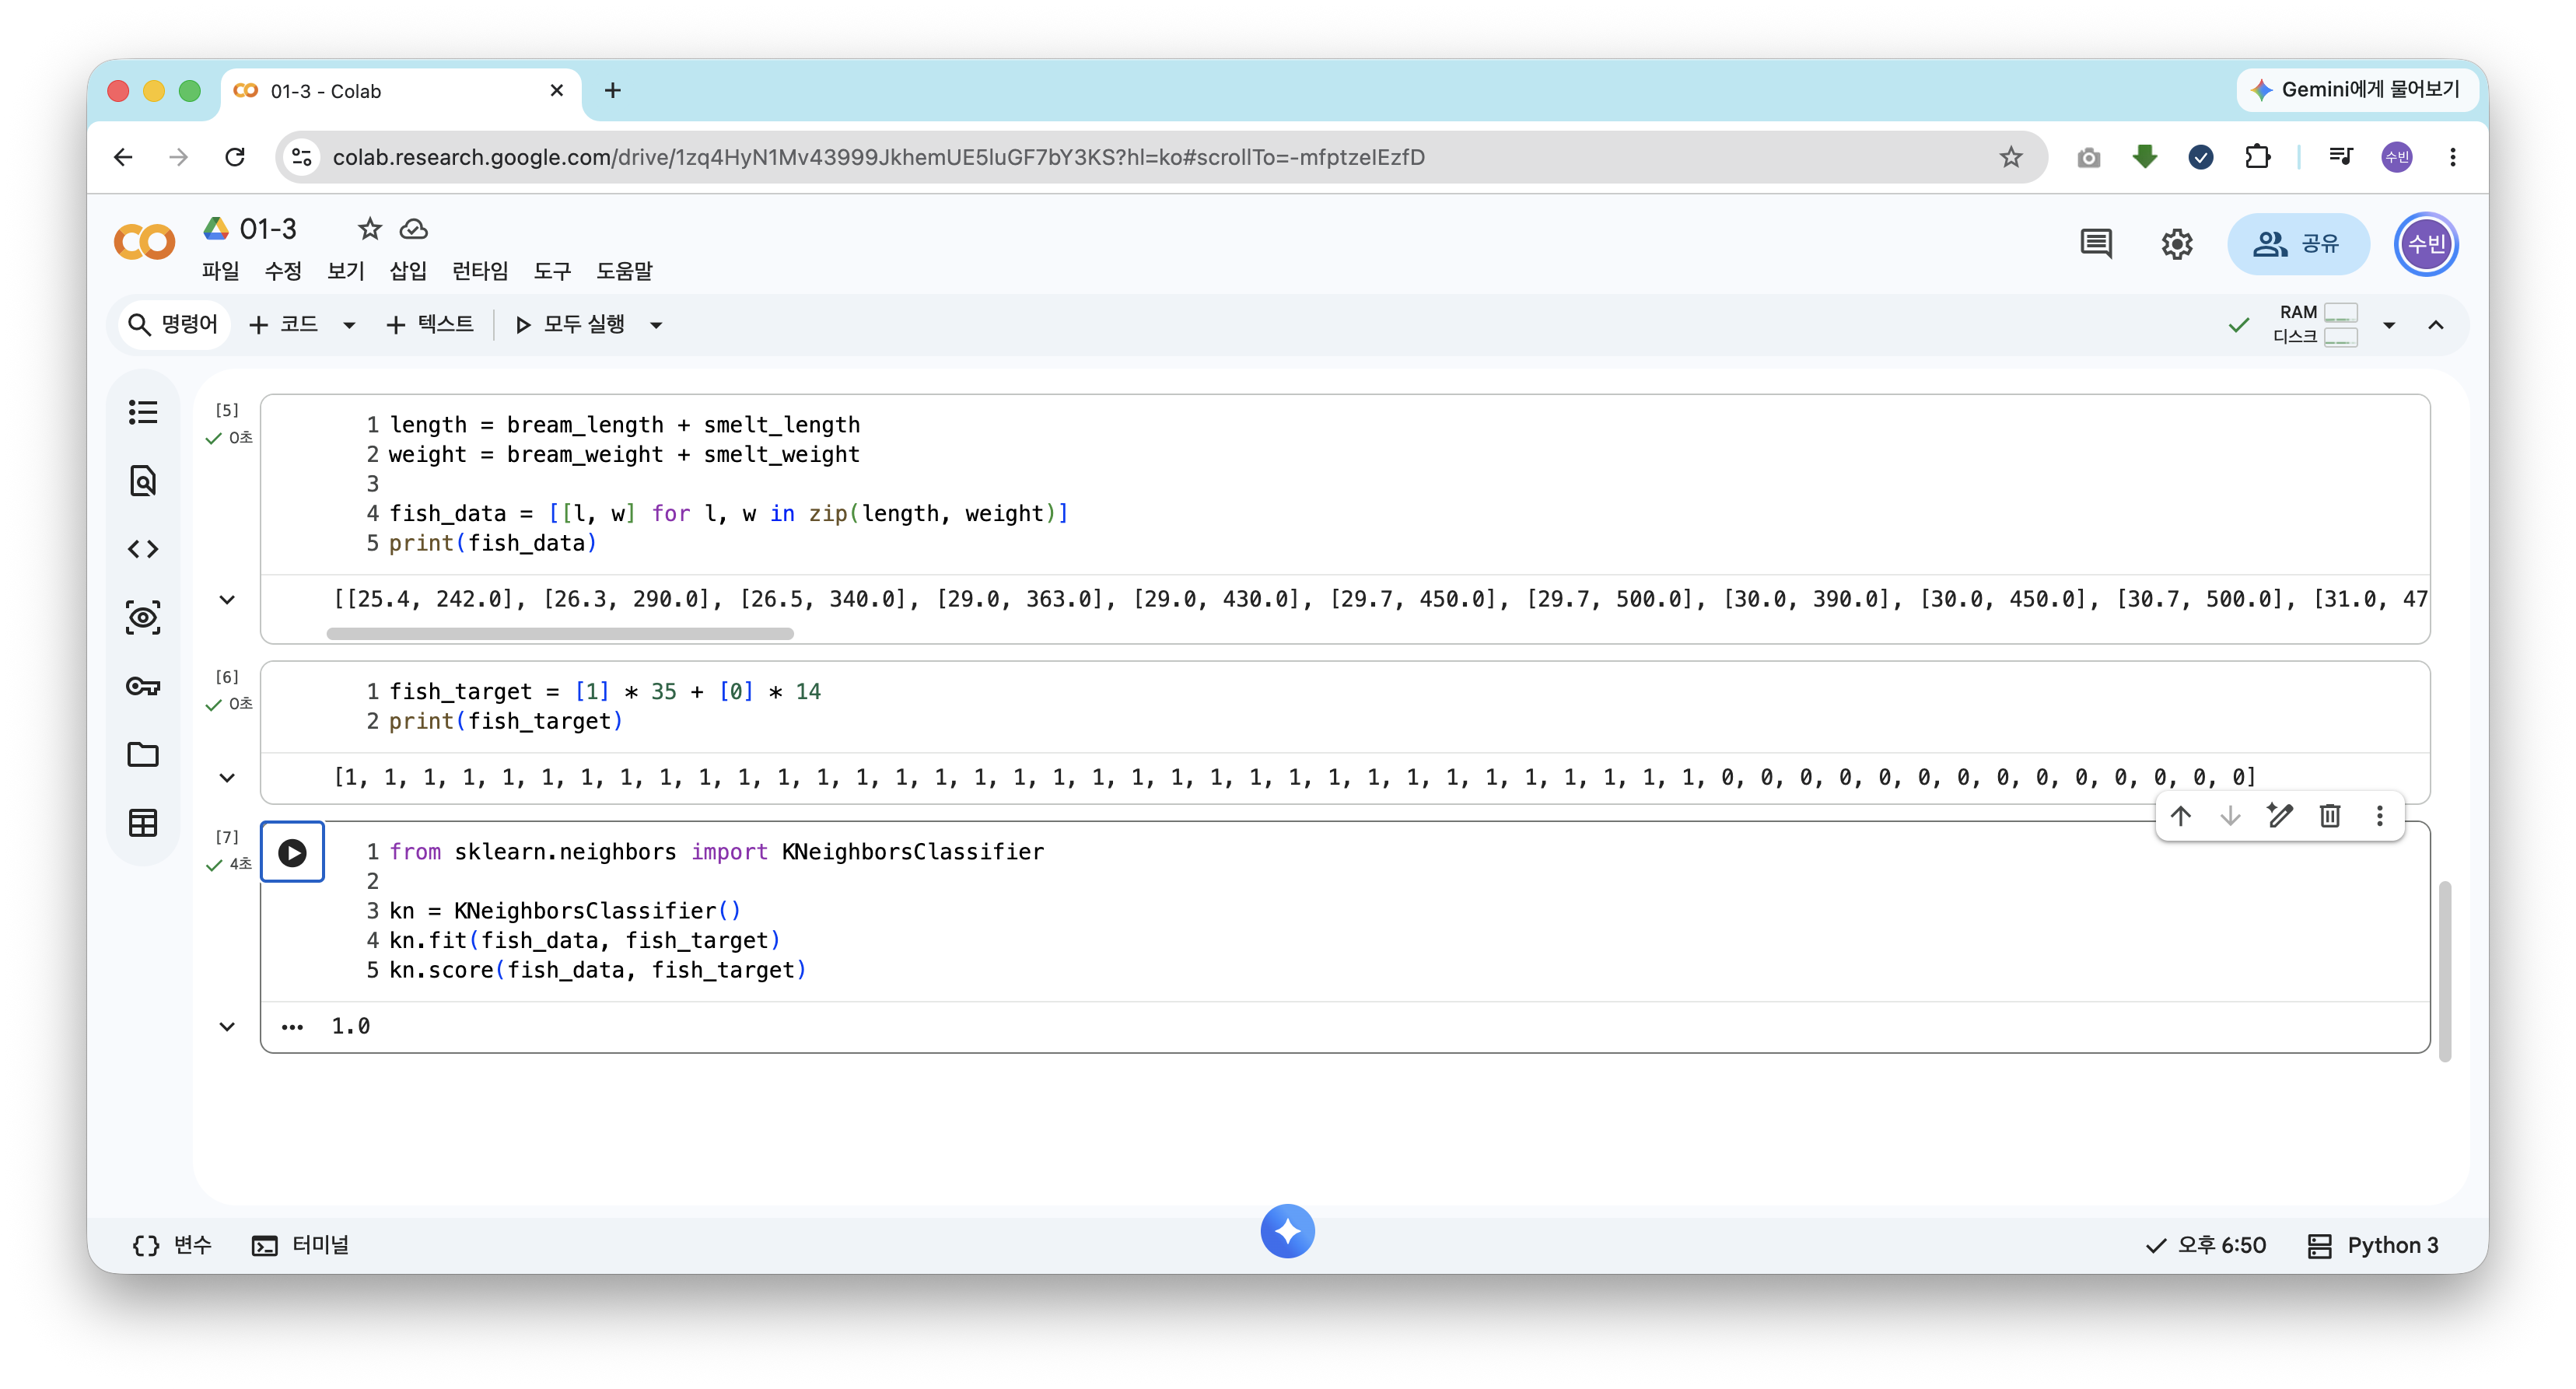
fit(): 주어진 데이터로 알고리즘을 훈련한다score(): 모델을 평가한다. 분류에서는 정확도(accuracy) 를 0~1 사이 값으로 반환- 훈련(training): 알고리즘이 데이터에서 규칙을 찾는 과정
- 모델(model): 훈련이 끝난 알고리즘 객체
1
2
3
4
5
6
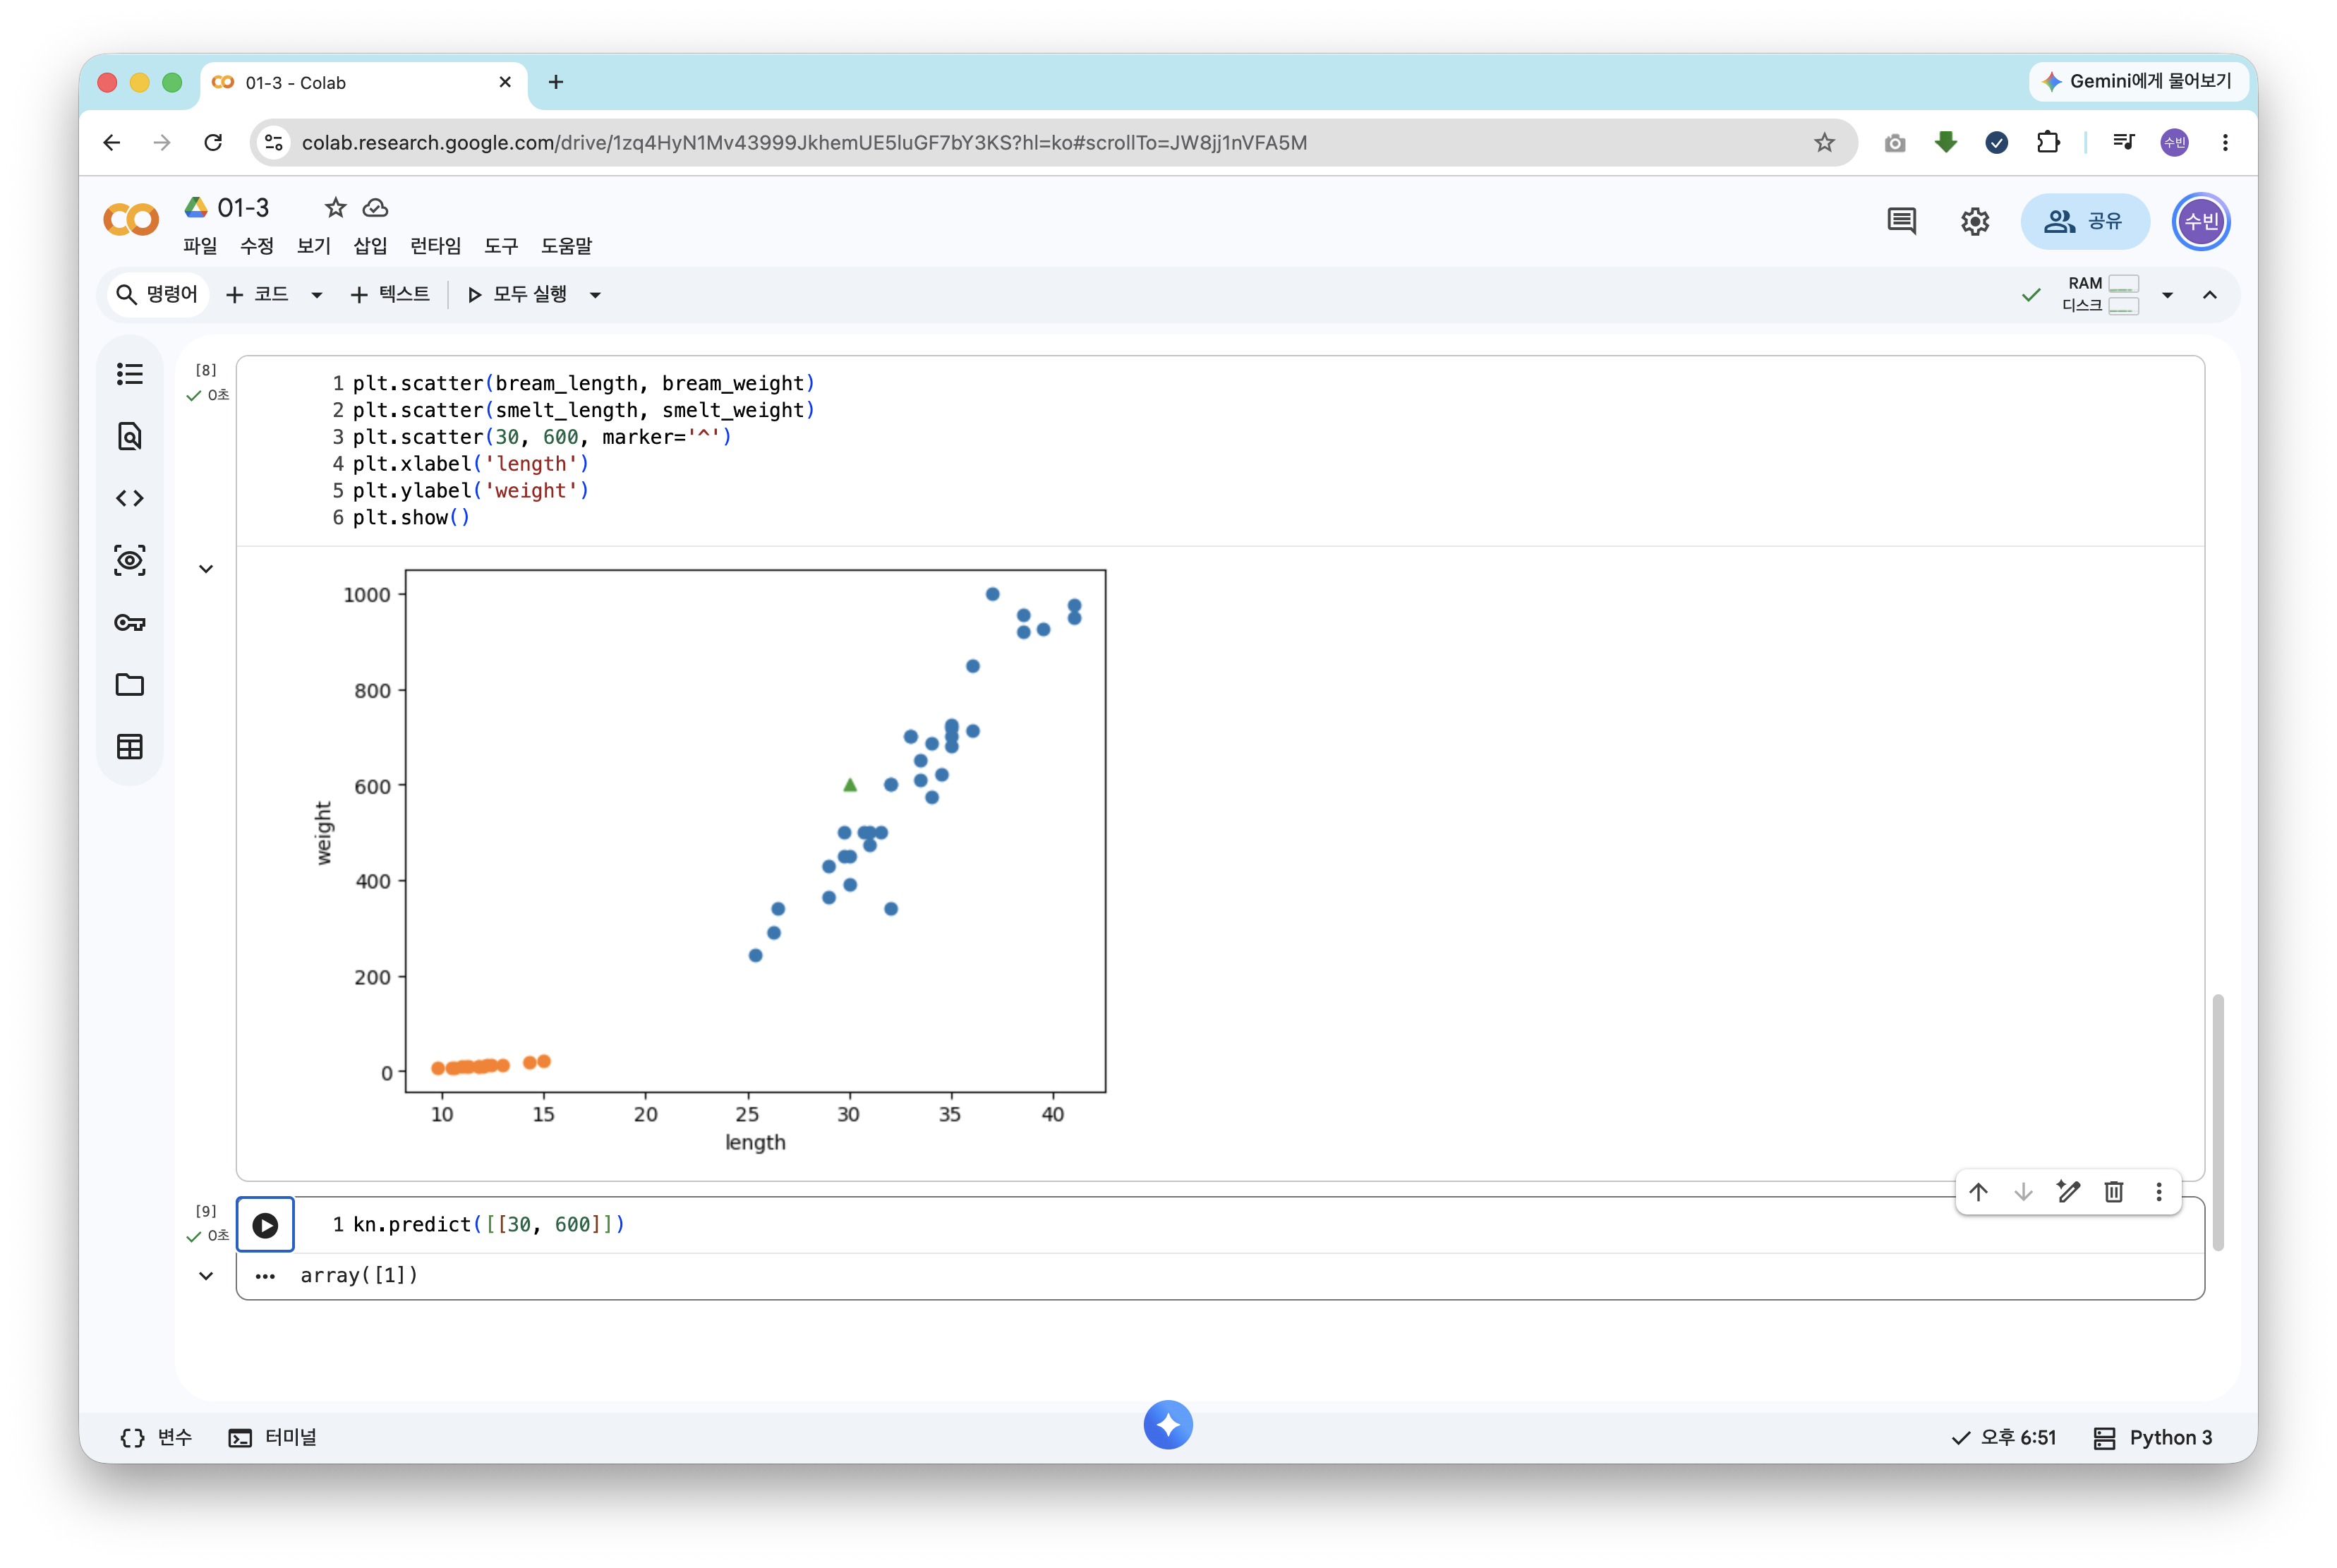
plt.scatter(bream_length, bream_weight)
plt.scatter(smelt_length, smelt_weight)
plt.scatter(30, 600, marker='^')
plt.xlabel('length')
plt.ylabel('weight')
plt.show()
1
kn.predict([[30, 600]])
1
array([1])
- 길이 30cm, 무게 600g인 새로운 생선(삼각형 마커)은 도미 무리 쪽에 가깝다
predict(): 새로운 데이터의 정답을 예측한다. 결과1= 도미
1
2
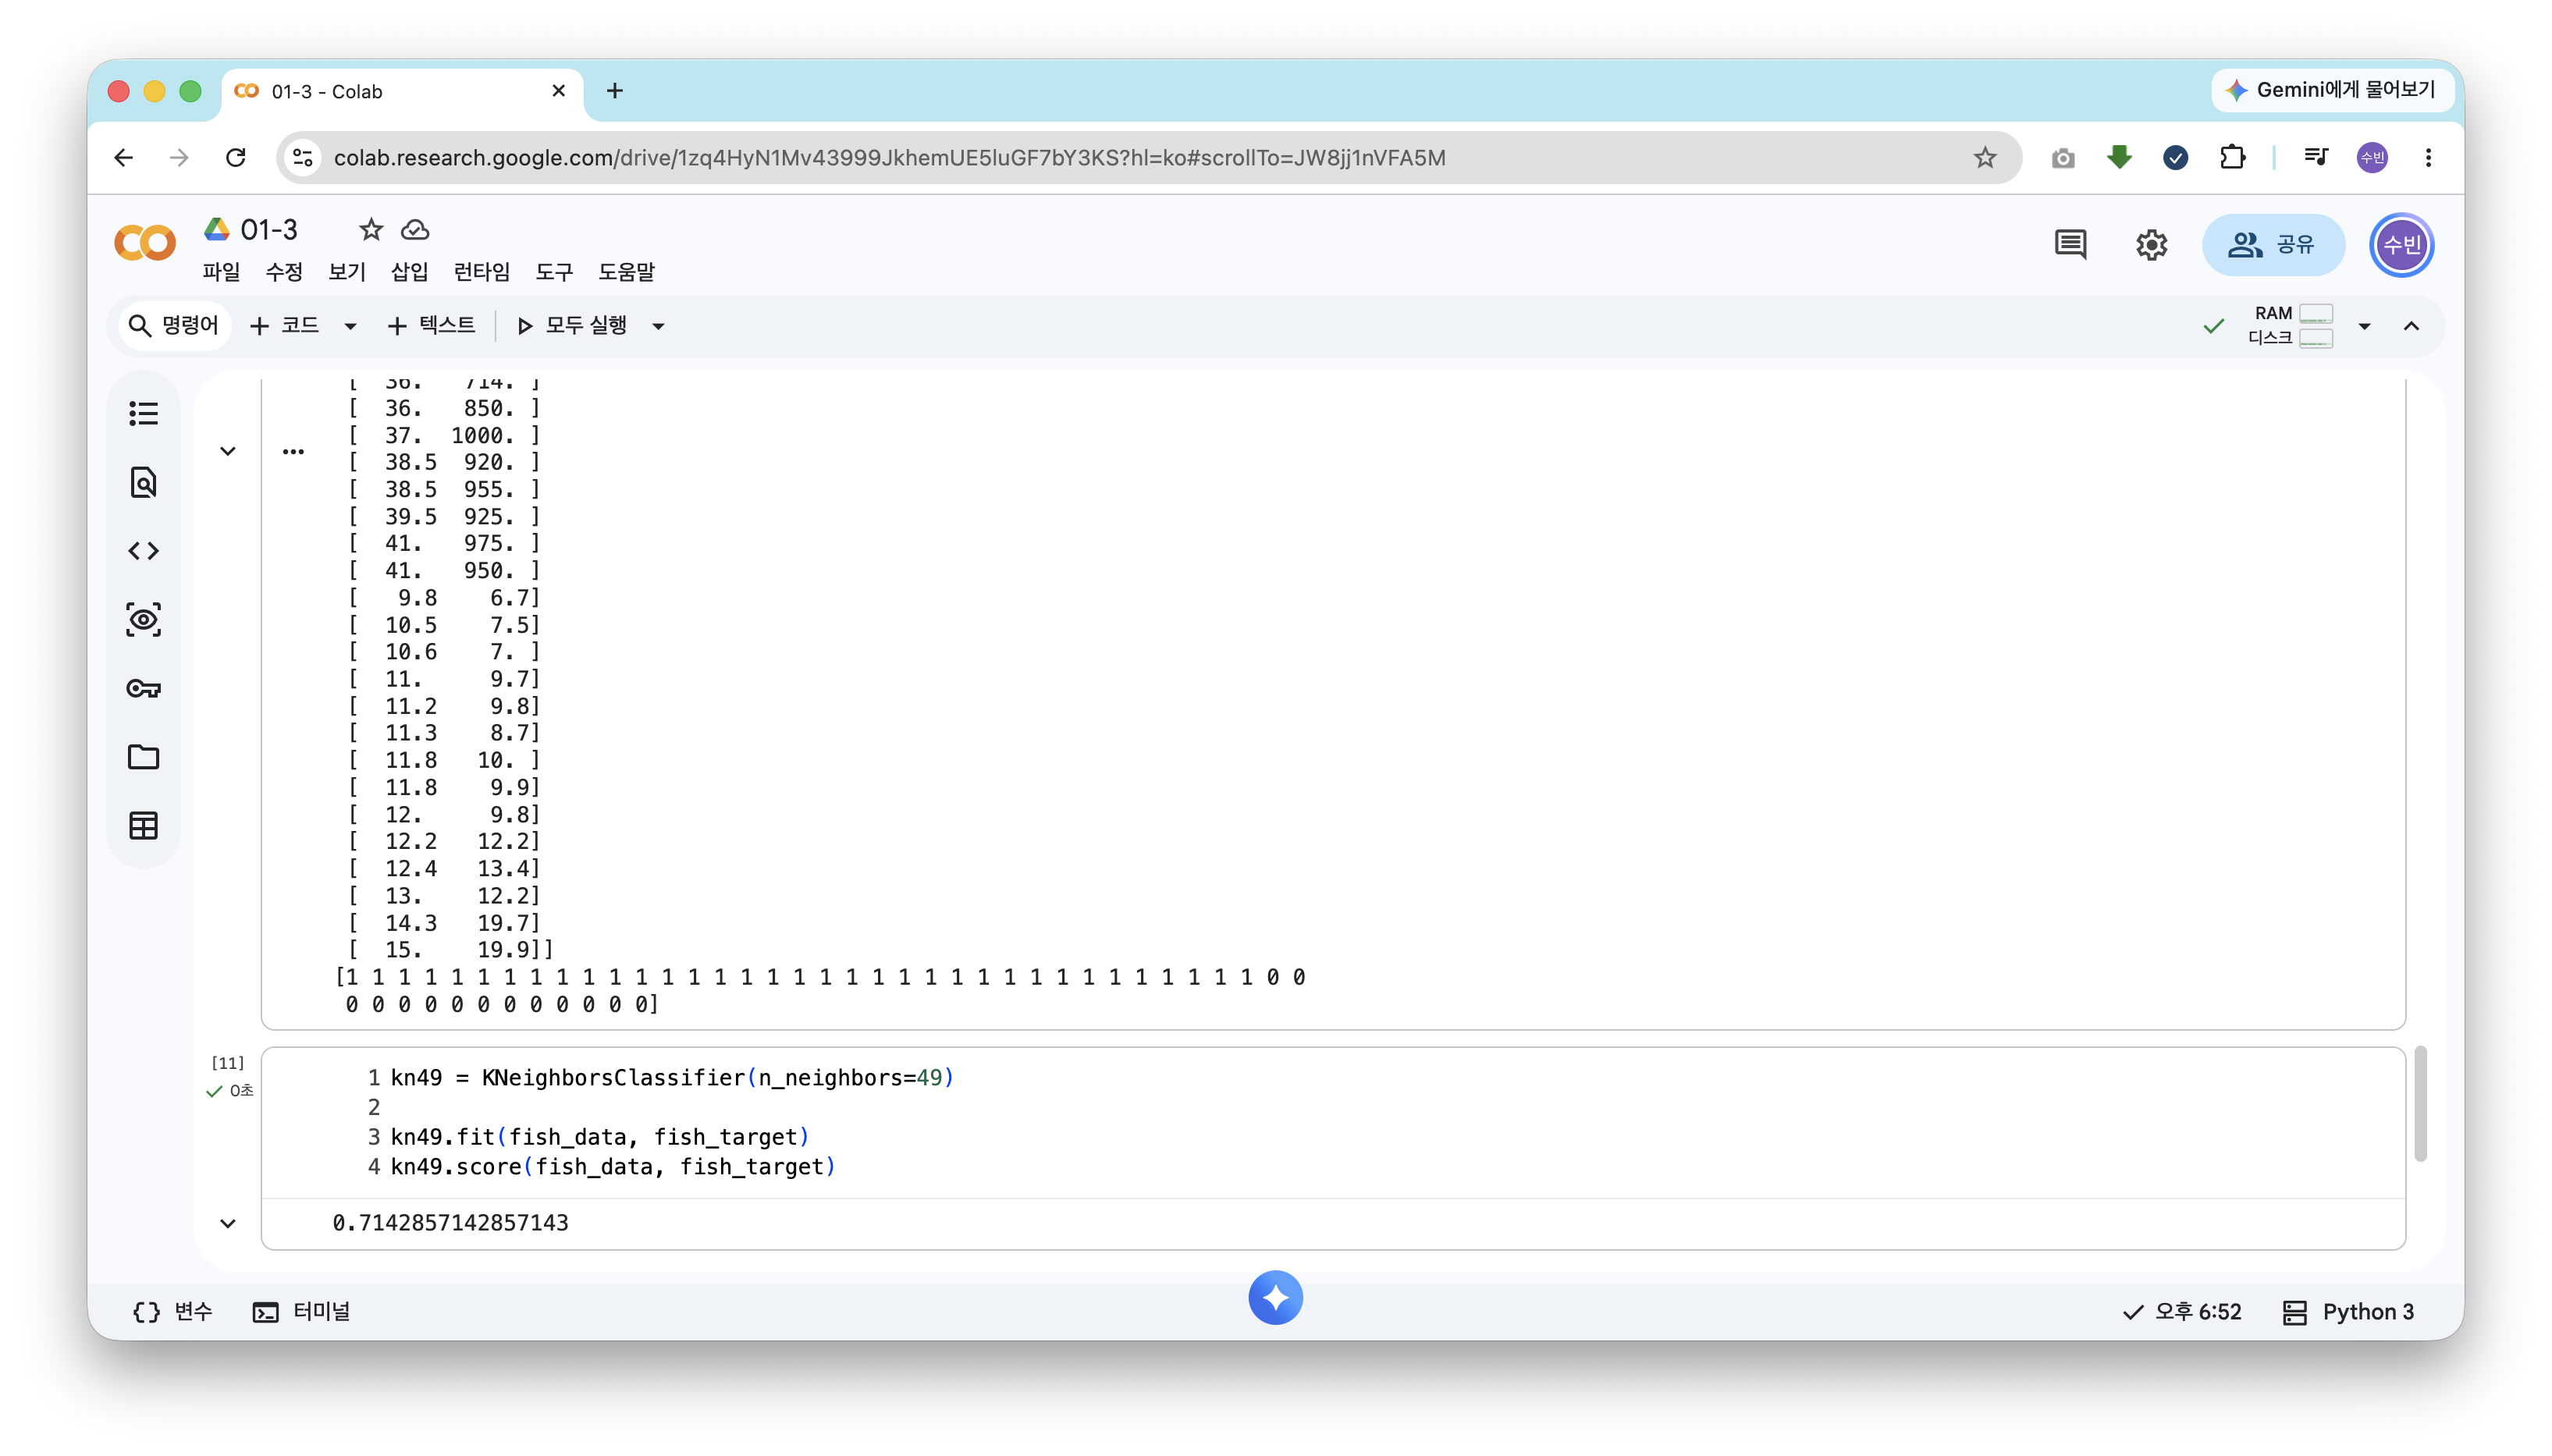
print(kn._fit_X)   # 모델이 가지고 있는 훈련 데이터
print(kn._y)       # 모델이 가지고 있는 정답 데이터
- k-최근접 이웃 모델은 훈련 데이터를 그대로 저장해 두고 있다가, 예측할 때 거리를 계산한다
1
2
3
4
kn49 = KNeighborsClassifier(n_neighbors=49)

kn49.fit(fish_data, fish_target)
kn49.score(fish_data, fish_target)
1
0.7142857142857143
- 이웃을 전체 데이터 개수인 49로 두면, 어떤 값을 넣어도 다수인 도미(35마리) 로만 예측하게 된다
- 정확도가 35/49 ≈ 0.71 로 떨어진다 → k 값(하이퍼파라미터) 선택이 성능에 직접 영향을 준다
도미와 빙어 분류
이번 절의 문제 해결 과정을 순서대로 정리하면 다음과 같다.
- 문제 정의: 길이와 무게만 보고 도미인지 빙어인지 구분하기
- 데이터 준비: 도미 35마리, 빙어 14마리의 길이·무게를 리스트로 모으고, 산점도로 두 생선이 구분되는지 확인
- 입력 형태 맞추기: 두 특성을 2차원 리스트
fish_data로 만들고, 도미 1 / 빙어 0인fish_target을 만듦 - 훈련:
KNeighborsClassifier객체를 만들어fit()으로 훈련 - 평가:
score()로 정확도 확인 → 1.0 - 예측:
predict()로 새로운 샘플(길이 30, 무게 600)을 도미로 예측
- 머신러닝은 이렇게 데이터 준비 → 훈련 → 평가 → 예측의 흐름으로 진행된다
- 이번에는 훈련에 쓴 데이터로 그대로 평가해서 정확도가 1.0이 나왔다. 이 문제를 어떻게 다루는지는 2장에서 이어진다.
📌 정리
- 인공지능 ⊃ 머신러닝 ⊃ 딥러닝의 관계를 정리하고, 구글 코랩으로 실습 환경을 준비했다
- 도미 35마리와 빙어 14마리의 길이·무게 데이터로 첫 머신러닝 프로그램을 만들었다
- k-최근접 이웃은 가까운 이웃 k개를 보고 다수인 쪽으로 판단한다.
fit()→score()→predict()순서로 진행한다 - 이웃 개수를 49로 바꾸니 정확도가 0.71로 떨어졌다 → k 값 선택이 성능을 좌우한다
핵심 용어: 인공지능 / 머신러닝 / 딥러닝 / 코랩 / 노트북 / 특성 / 훈련 / 모델 / k-최근접 이웃 / 정확도
This post is licensed under CC BY 4.0 by the author.