[혼자 공부하는 머신러닝+딥러닝] 2장. 데이터 다루기
[혼자 공부하는 머신러닝+딥러닝] 2장. 데이터 다루기
“혼자 공부하는 머신러닝+딥러닝(개정판)” 도서 바로가기
2장. 데이터 다루기
02-1. 훈련 세트와 테스트 세트
지도 학습과 비지도 학습
- 지도 학습(supervised learning): 입력과 타깃을 함께 주고 훈련하는 방식
- 입력(input): 알고리즘에 넣는 데이터. 1장의 생선 길이·무게
- 타깃(target): 정답. 1장의 도미 1 / 빙어 0
- 입력 + 타깃 = 훈련 데이터(training data)
- 정답이 있으니 알고리즘이 정답을 맞히는 방향으로 학습할 수 있다
- 비지도 학습(unsupervised learning): 타깃 없이 입력 데이터만 사용하는 방식
- 정답을 맞히는 게 아니라 데이터의 구조·특징을 파악하는 데 쓴다 (6장)
- 강화 학습(reinforcement learning): 알고리즘이 행동한 결과로 받은 보상을 사용해 학습하는 방식
훈련 세트와 테스트 세트
- 평가에 사용하는 데이터는 훈련에 사용한 데이터와 달라야 한다
- 1장에서는 훈련에 쓴 49개 데이터를 그대로 평가에 써서 정확도가 1.0이 나왔다. 시험 문제를 미리 알려 주고 시험을 본 셈이다
- 훈련 세트(train set): 훈련에 사용하는 데이터
- 테스트 세트(test set): 평가에 사용하는 데이터
- 샘플(sample): 하나의 생선 데이터처럼, 하나의 데이터를 가리키는 말. 여기서는 생선 49마리 = 샘플 49개
1
2
3
4
5
6
7
8
fish_length = [25.4, 26.3, 26.5, 29.0, 29.0, 29.7, 29.7, 30.0, 30.0, 30.7, 31.0, 31.0,
                31.5, 32.0, 32.0, 32.0, 33.0, 33.0, 33.5, 33.5, 34.0, 34.0, 34.5, 35.0,
                35.0, 35.0, 35.0, 36.0, 36.0, 37.0, 38.5, 38.5, 39.5, 41.0, 41.0, 9.8,
                10.5, 10.6, 11.0, 11.2, 11.3, 11.8, 11.8, 12.0, 12.2, 12.4, 13.0, 14.3, 15.0]
fish_weight = [242.0, 290.0, 340.0, 363.0, 430.0, 450.0, 500.0, 390.0, 450.0, 500.0, 475.0, 500.0,
                500.0, 340.0, 600.0, 600.0, 700.0, 700.0, 610.0, 650.0, 575.0, 685.0, 620.0, 680.0,
                700.0, 725.0, 720.0, 714.0, 850.0, 1000.0, 920.0, 955.0, 925.0, 975.0, 950.0, 6.7,
                7.5, 7.0, 9.7, 9.8, 8.7, 10.0, 9.9, 9.8, 12.2, 13.4, 12.2, 19.7, 19.9]
1
2
fish_data = [[l, w] for l, w in zip(fish_length, fish_weight)]
fish_target = [1]*35 + [0]*14
1
2
3
from sklearn.neighbors import KNeighborsClassifier

kn = KNeighborsClassifier()
- 파이썬 리스트의 인덱싱과 슬라이싱으로 데이터를 나눌 수 있다
1
2
3
4
print(fish_data[4])
print(fish_data[0:5])
print(fish_data[:5])
print(fish_data[44:])
1
2
3
4
5
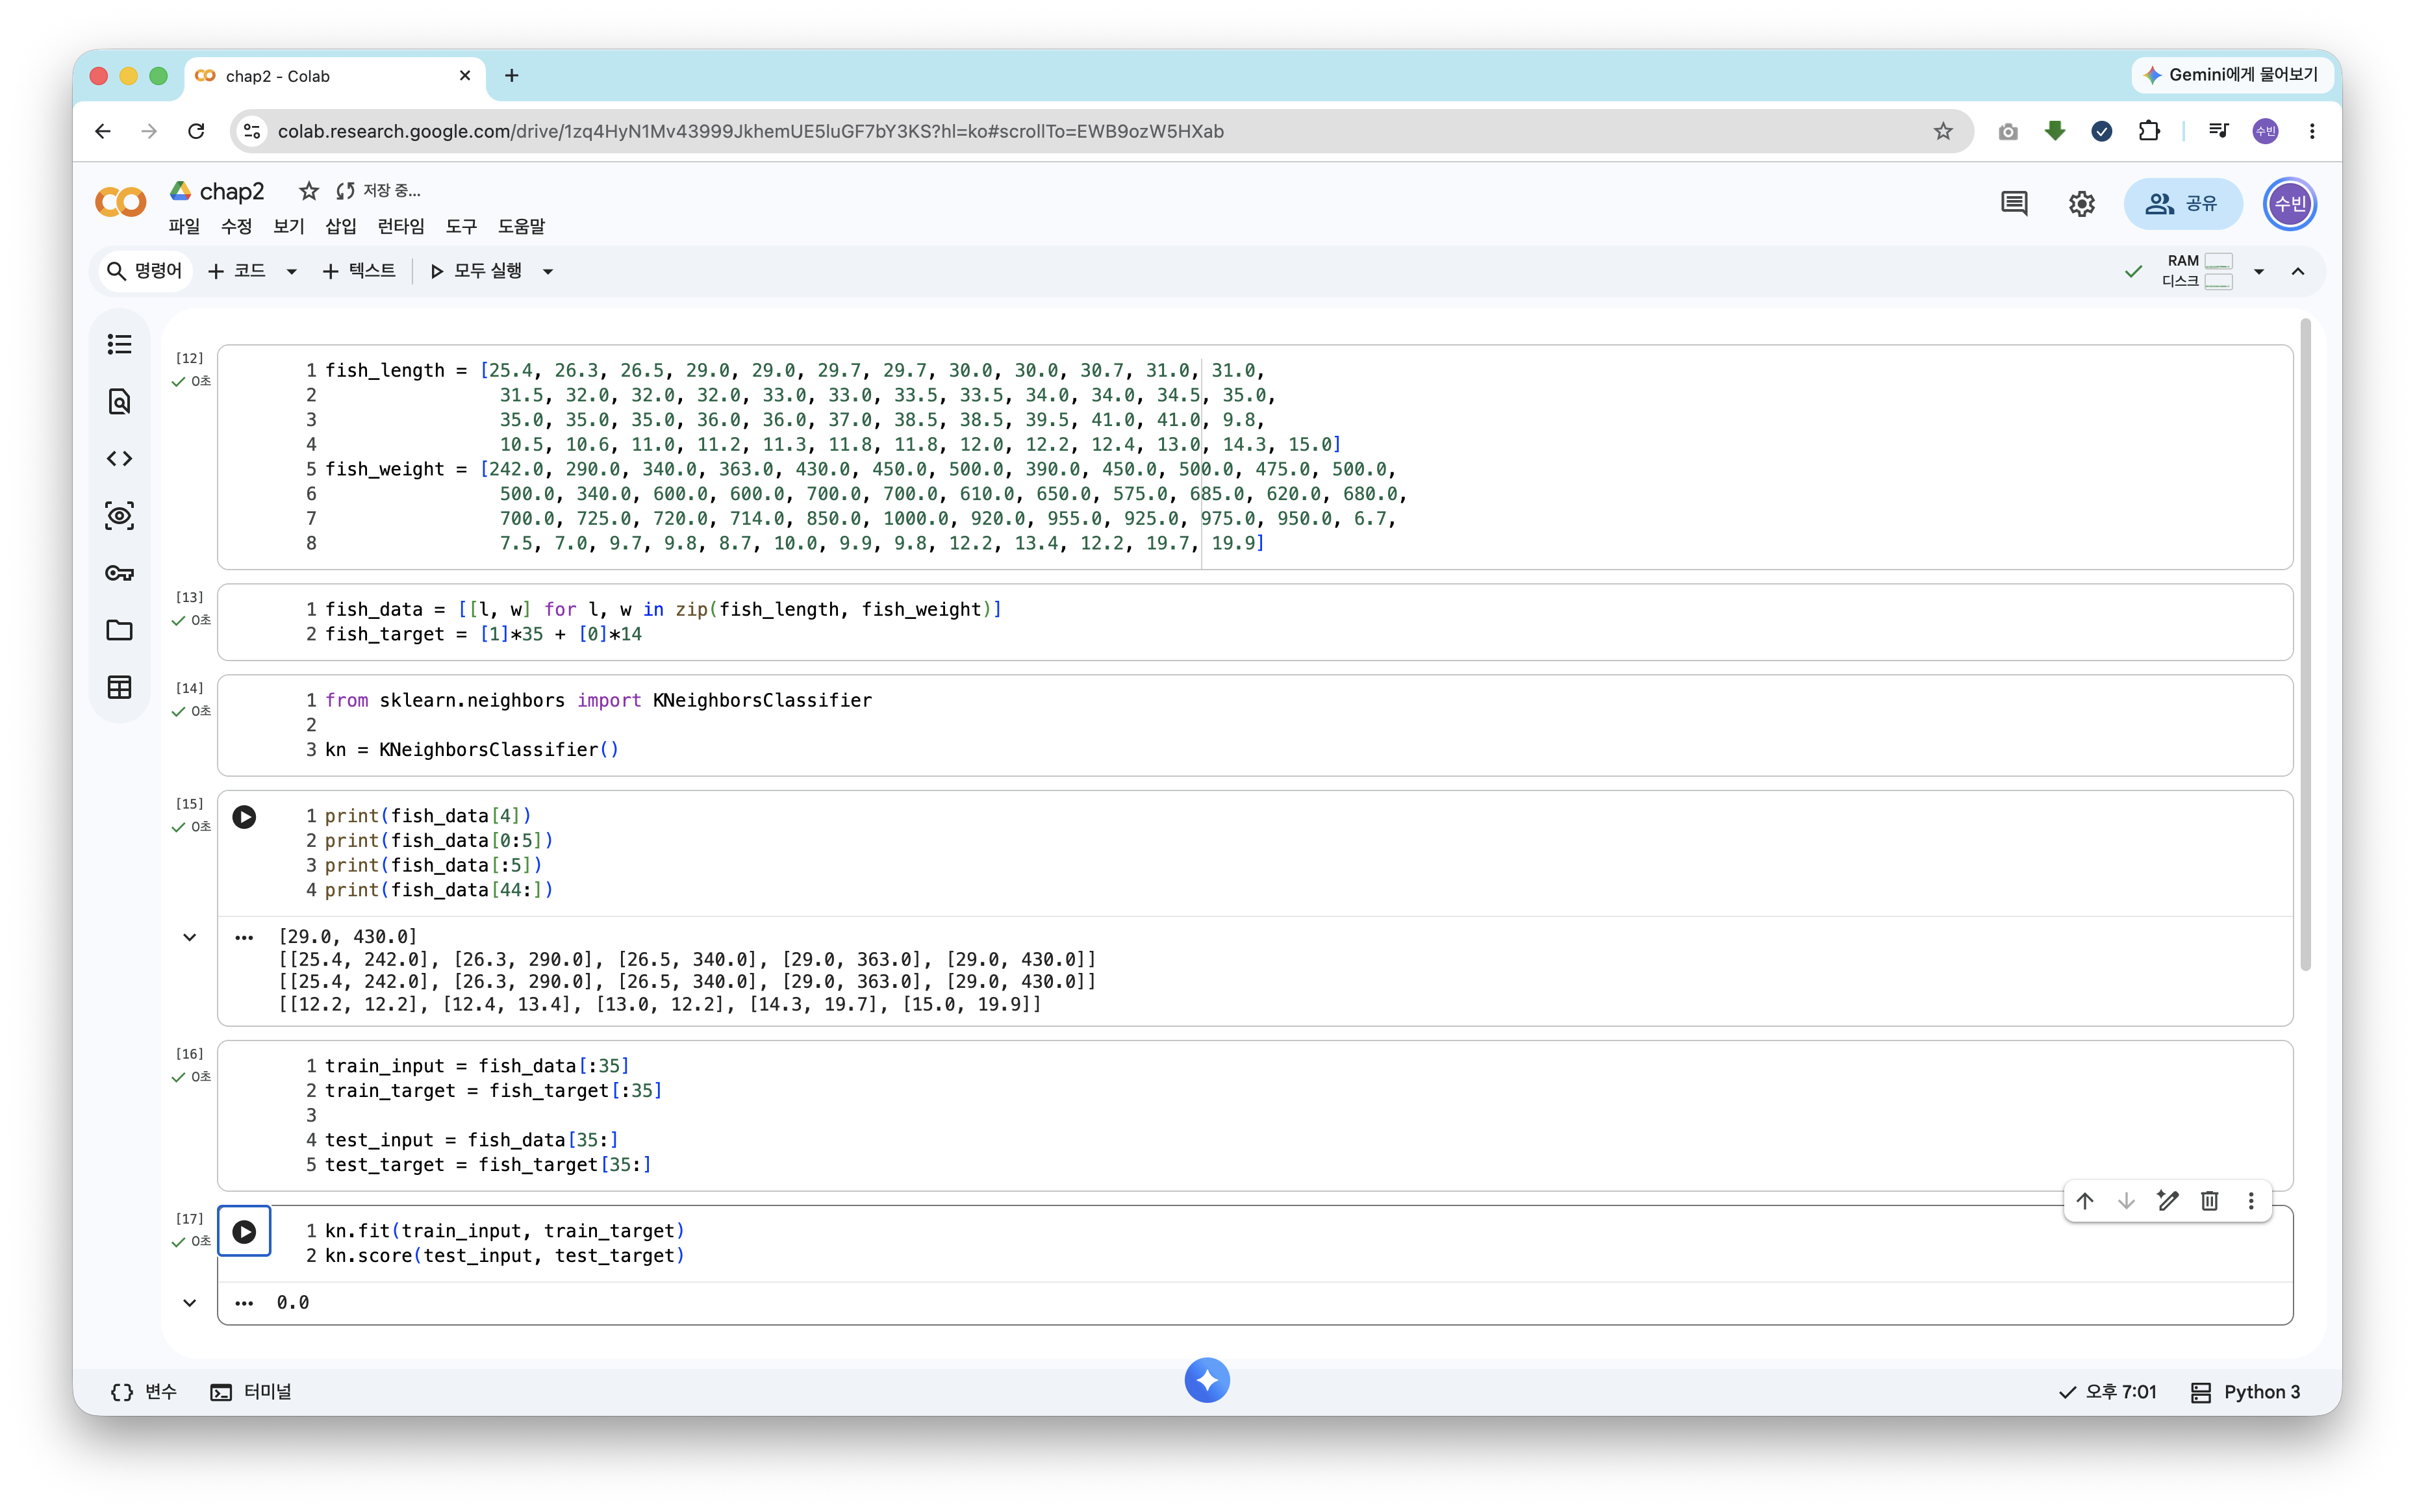
train_input = fish_data[:35]
train_target = fish_target[:35]

test_input = fish_data[35:]
test_target = fish_target[35:]
1
2
kn.fit(train_input, train_target)
kn.score(test_input, test_target)
1
0.0
- 앞 35개(도미)만 훈련하고 뒤 14개(빙어)로 평가했더니 정확도가 0.0 이 나왔다
샘플링 편향
: 훈련 세트와 테스트 세트에 샘플이 골고루 섞이지 않아 한쪽으로 치우친 상태
- 위 결과가 0.0인 이유: 훈련 세트에는 도미만, 테스트 세트에는 빙어만 들어갔다
- 도미만 배운 모델은 무엇을 물어도 도미라고 답하는데, 정답은 전부 빙어이므로 하나도 맞히지 못한다
- 훈련 세트와 테스트 세트에는 샘플이 골고루 섞여 있어야 한다 → 나누기 전에 데이터를 섞어야 한다
넘파이
: 파이썬의 대표적인 배열 라이브러리. 고차원 배열을 손쉽게 만들고 조작할 수 있다
1
import numpy as np
1
2
input_arr = np.array(fish_data)
target_arr = np.array(fish_target)
1
print(input_arr)
1
print(input_arr.shape)
1
(49, 2)
shape: 배열의 크기(샘플 수, 특성 수)를 알려 주는 속성
1
2
3
np.random.seed(42)
index = np.arange(49)
np.random.shuffle(index)
np.arange(49): 0부터 48까지 1씩 증가하는 배열을 만든다np.random.shuffle(): 배열을 무작위로 섞는다np.random.seed(): 난수 생성 순서를 고정해서 실행할 때마다 같은 결과가 나오게 한다- 데이터를 직접 섞는 대신 인덱스를 섞어서 입력과 타깃이 같은 순서로 선택되게 한다
1
print(index)
1
print(input_arr[[1,3]])
- 배열 인덱싱(array indexing): 여러 개의 인덱스를 한 번에 전달해 원소를 한꺼번에 고를 수 있다
1
2
train_input = input_arr[index[:35]]
train_target = target_arr[index[:35]]
1
print(input_arr[13], train_input[0])
1
2
test_input = input_arr[index[35:]]
test_target = target_arr[index[35:]]
1
2
3
4
5
6
7
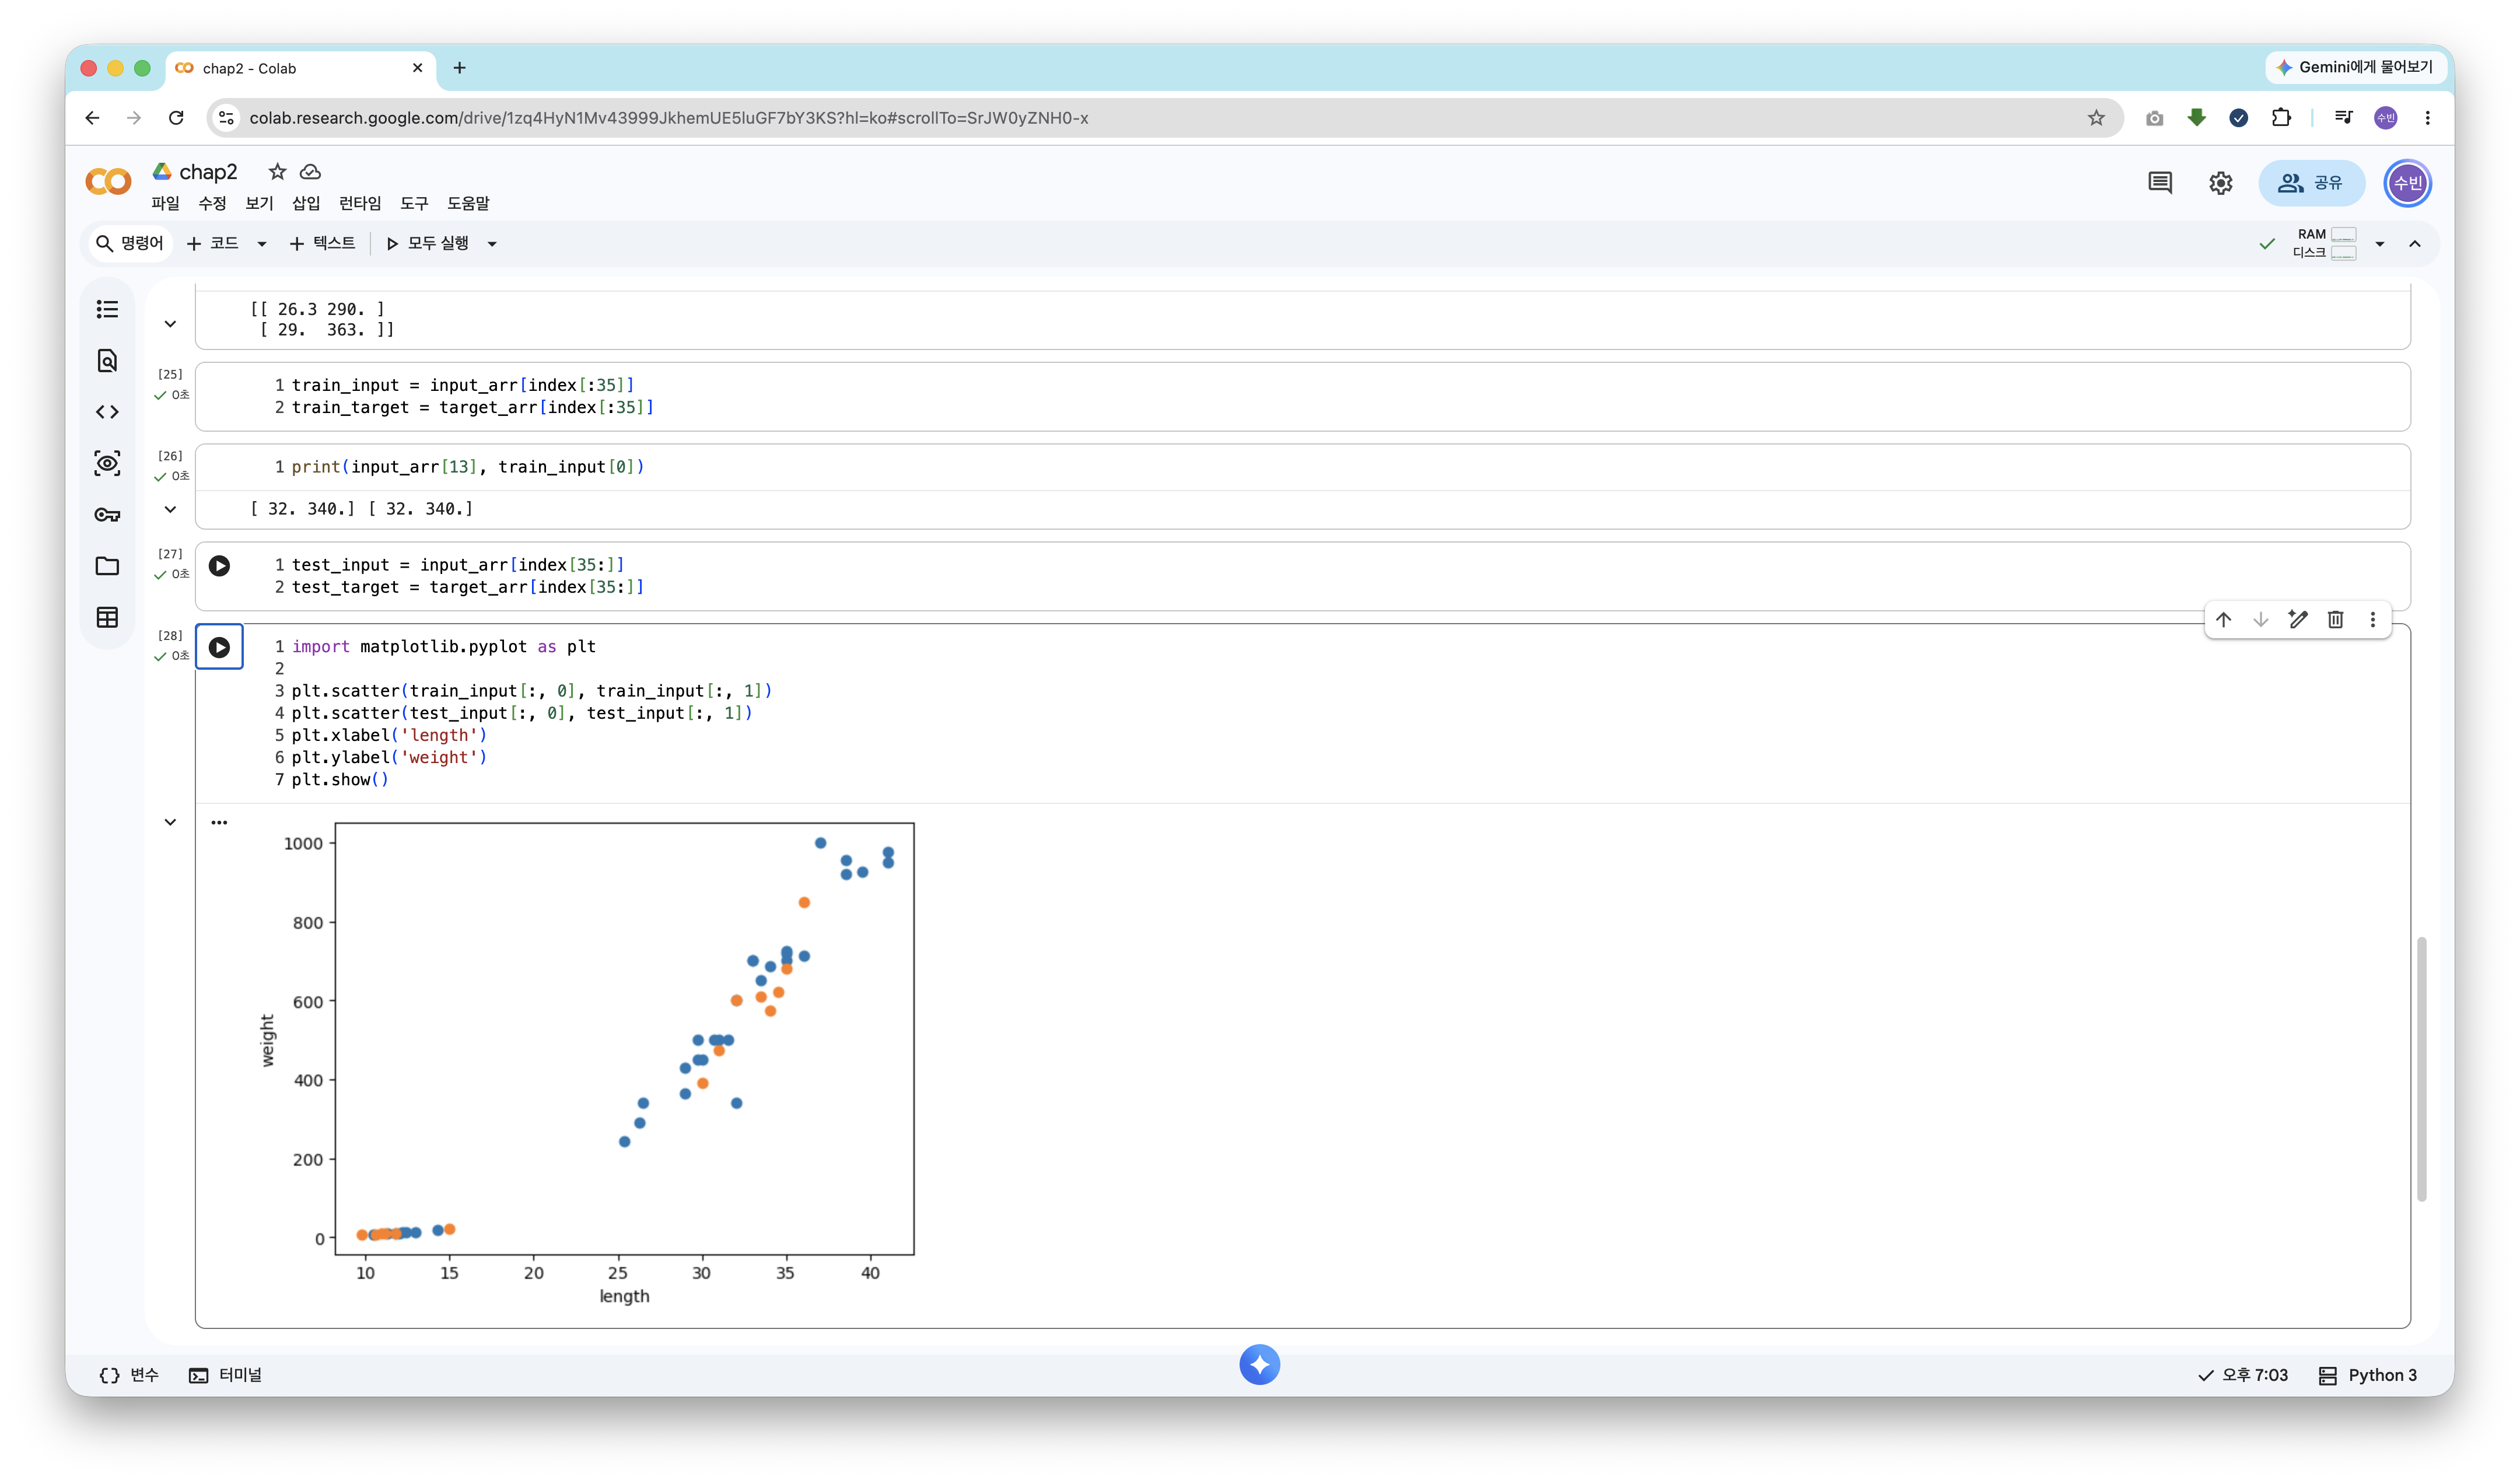
import matplotlib.pyplot as plt

plt.scatter(train_input[:, 0], train_input[:, 1])
plt.scatter(test_input[:, 0], test_input[:, 1])
plt.xlabel('length')
plt.ylabel('weight')
plt.show()
- 산점도를 그려 보면 훈련 세트(파란색)와 테스트 세트(주황색)에 도미와 빙어가 골고루 섞여 있다
두 번째 머신러닝 프로그램
1
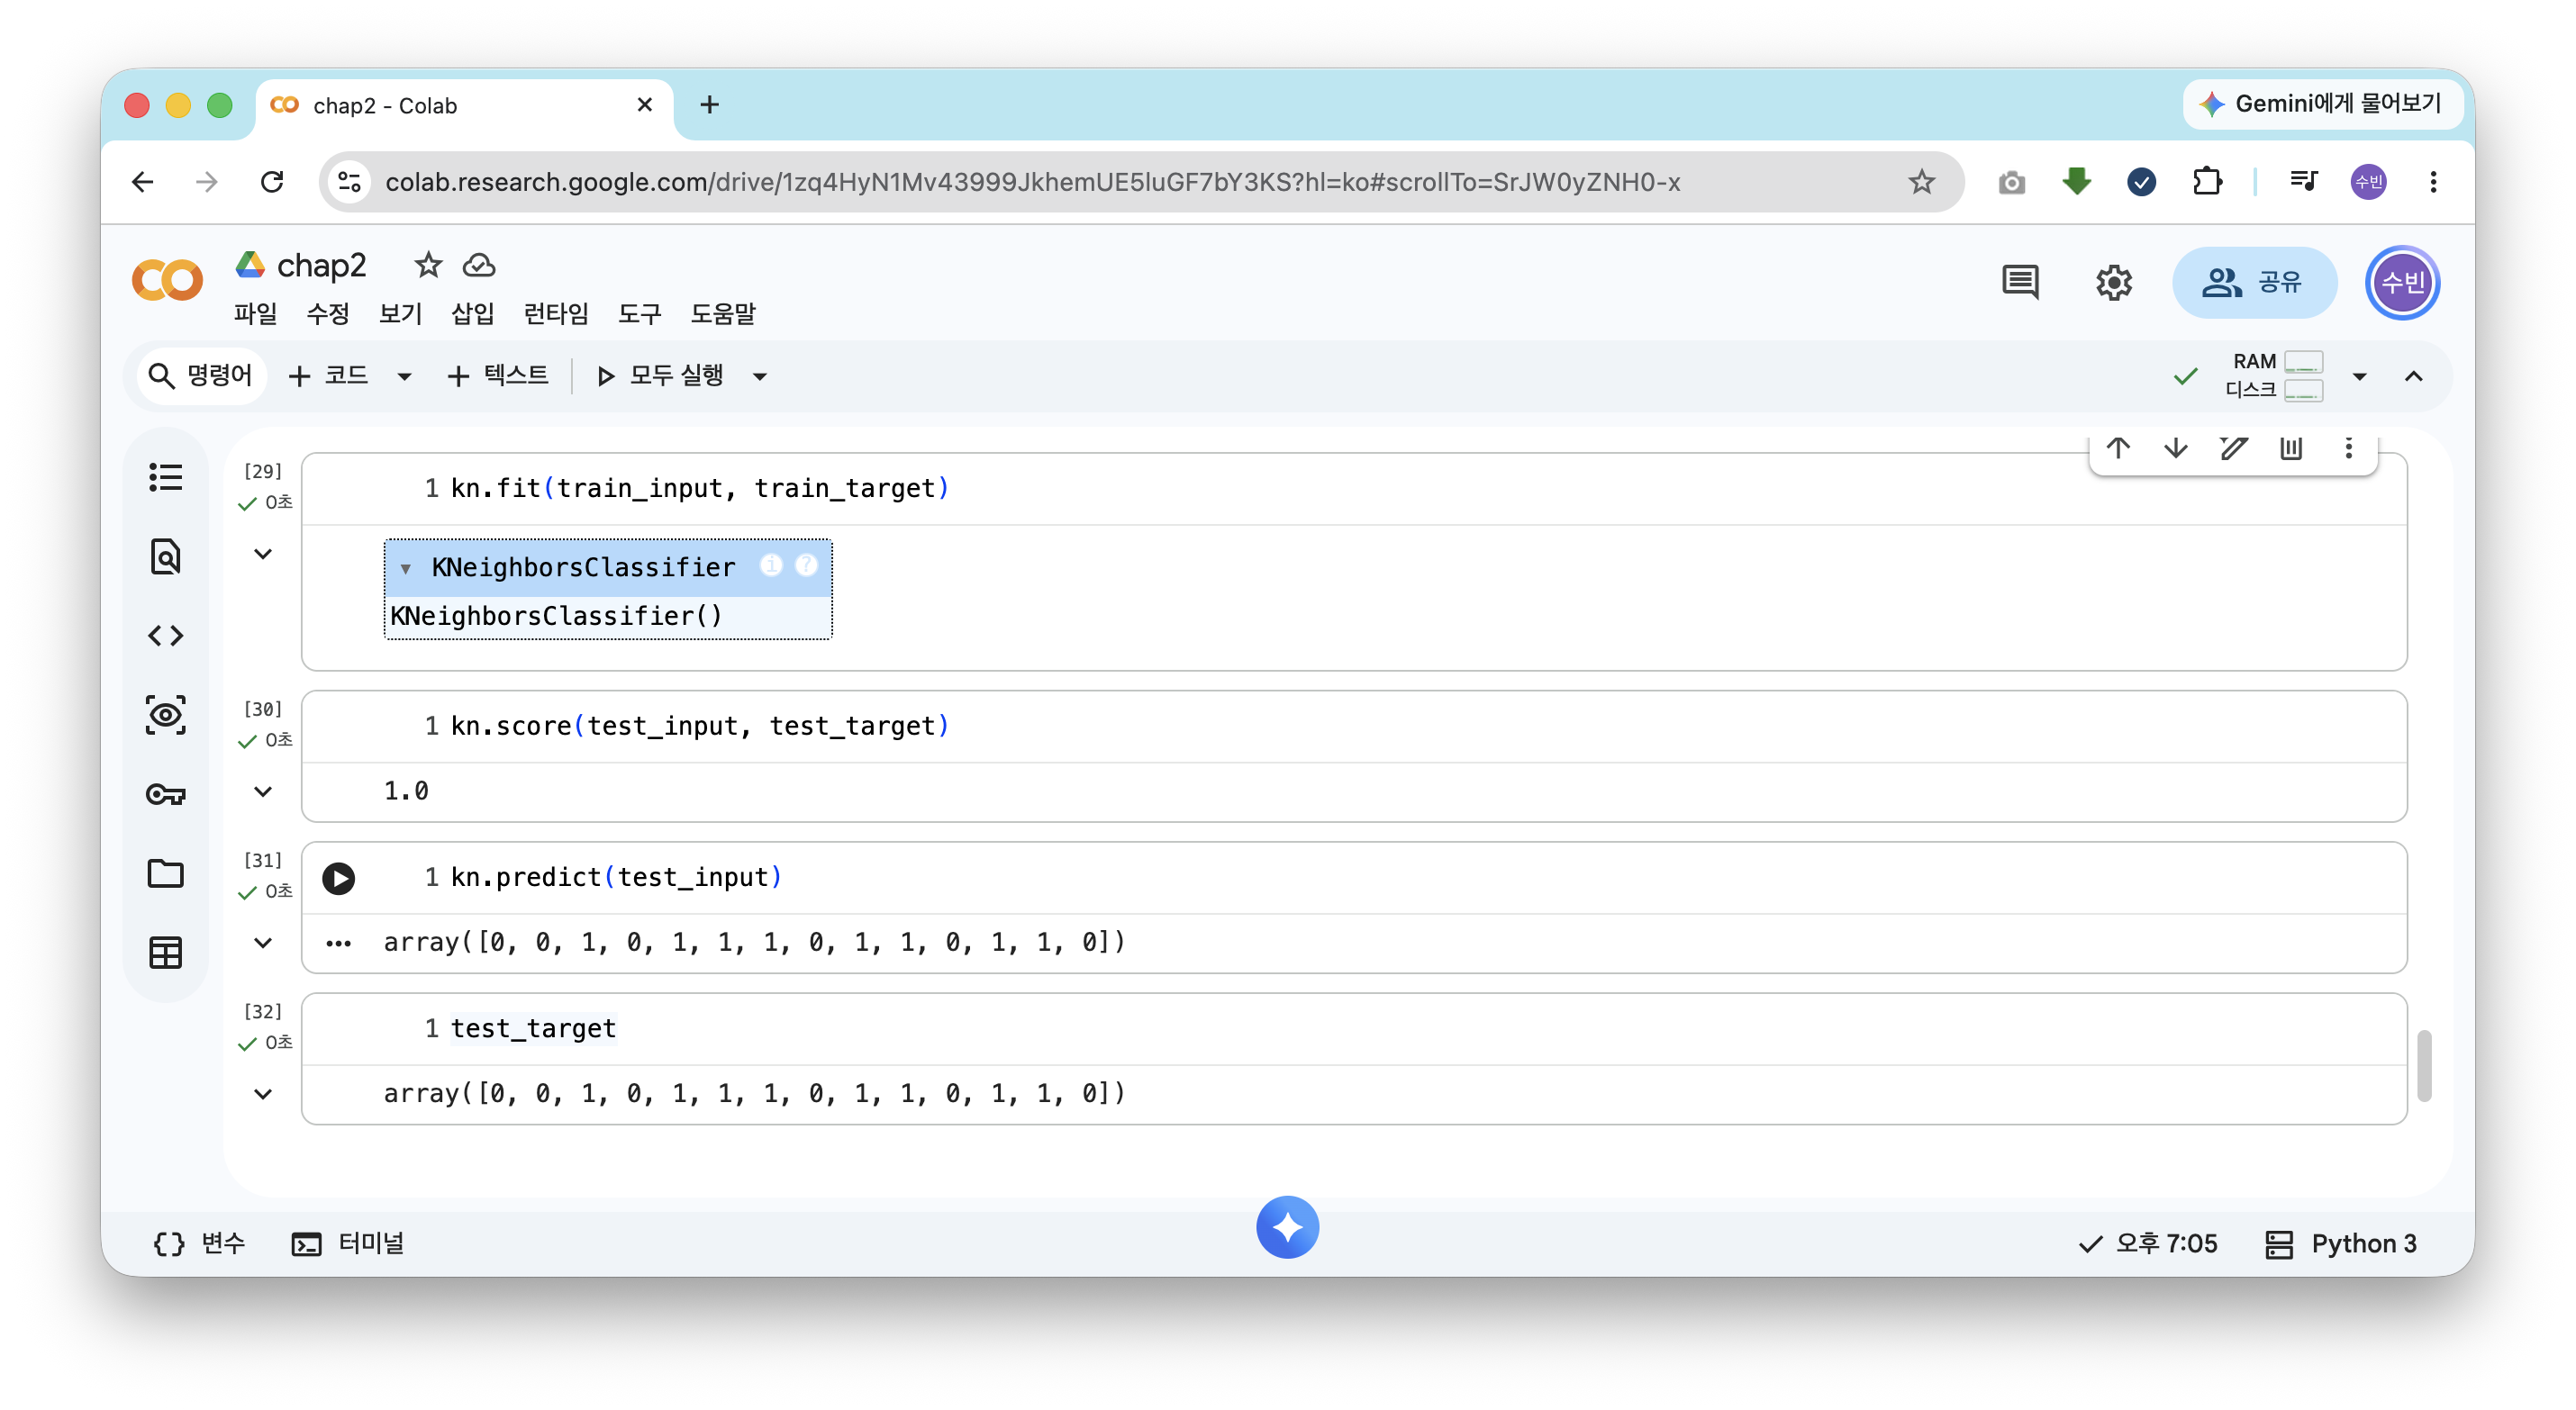
kn.fit(train_input, train_target)
1
kn.score(test_input, test_target)
1
1.0
1
kn.predict(test_input)
1
test_target
- 잘 섞인 훈련 세트로 훈련하고 테스트 세트로 평가했더니 정확도가 1.0 이 나왔다
predict()의 결과와test_target이 같은 것을 보면 모두 정확히 맞혔음을 알 수 있다- 사이킷런 모델의 입력과 출력은 모두 넘파이 배열이다
훈련 모델 평가
이번 절의 문제 해결 과정을 정리하면 다음과 같다.
- 문제 인식: 1장에서는 훈련 데이터로 평가해서 정확도를 믿을 수 없었다
- 훈련 세트와 테스트 세트 분리: 앞에서부터 35개/14개로 잘랐더니 정확도 0.0
- 원인 파악: 샘플링 편향 — 훈련 세트에 도미만, 테스트 세트에 빙어만 들어갔다
- 해결: 넘파이로 인덱스를 섞어 데이터를 무작위로 나눔
- 재평가: 정확도 1.0
- 지도 학습은 훈련 세트로 훈련하고, 테스트 세트로 평가하는 것이 기본이다
- 데이터를 나눌 때는 샘플이 골고루 섞이도록 해야 한다
02-2. 데이터 전처리
넘파이로 데이터 준비하기
1
2
3
4
5
6
7
8
fish_length = [25.4, 26.3, 26.5, 29.0, 29.0, 29.7, 29.7, 30.0, 30.0, 30.7, 31.0, 31.0,
                31.5, 32.0, 32.0, 32.0, 33.0, 33.0, 33.5, 33.5, 34.0, 34.0, 34.5, 35.0,
                35.0, 35.0, 35.0, 36.0, 36.0, 37.0, 38.5, 38.5, 39.5, 41.0, 41.0, 9.8,
                10.5, 10.6, 11.0, 11.2, 11.3, 11.8, 11.8, 12.0, 12.2, 12.4, 13.0, 14.3, 15.0]
fish_weight = [242.0, 290.0, 340.0, 363.0, 430.0, 450.0, 500.0, 390.0, 450.0, 500.0, 475.0, 500.0,
                500.0, 340.0, 600.0, 600.0, 700.0, 700.0, 610.0, 650.0, 575.0, 685.0, 620.0, 680.0,
                700.0, 725.0, 720.0, 714.0, 850.0, 1000.0, 920.0, 955.0, 925.0, 975.0, 950.0, 6.7,
                7.5, 7.0, 9.7, 9.8, 8.7, 10.0, 9.9, 9.8, 12.2, 13.4, 12.2, 19.7, 19.9]
1
import numpy as np
1
np.column_stack(([1,2,3], [4,5,6]))
np.column_stack(): 전달받은 리스트를 일렬로 세운 다음 차례대로 나란히 연결한다
1
fish_data = np.column_stack((fish_length, fish_weight))
1
print(fish_data[:5])
1
print(np.ones(5))
1
fish_target = np.concatenate((np.ones(35), np.zeros(14)))
1
print(fish_target)
np.ones(),np.zeros(): 원하는 개수의 1 또는 0을 채운 배열을 만든다np.concatenate(): 첫 번째 차원을 따라 배열을 연결한다- 데이터가 커질수록 파이썬 리스트로 작업하는 것보다 넘파이를 쓰는 편이 훨씬 효율적이다
사이킷런으로 훈련 세트와 테스트 세트 나누기
1
from sklearn.model_selection import train_test_split
1
2
train_input, test_input, train_target, test_target = train_test_split(
    fish_data, fish_target, random_state=42)
train_test_split(): 전달한 배열을 섞은 뒤 훈련 세트와 테스트 세트로 나눠 준다- 기본적으로 25%를 테스트 세트로 떼어 낸다
random_state: 난수 초깃값을 지정해 실행할 때마다 같은 결과가 나오게 한다
1
print(train_input.shape, test_input.shape)
1
(36, 2) (13, 2)
1
print(train_target.shape, test_target.shape)
1
print(test_target)
- 테스트 세트에 도미와 빙어가 3.3 : 1 로 들어갔다. 원래 비율인 2.5 : 1 과 다르다 → 여전히 샘플링 편향이 조금 남아 있다
1
2
train_input, test_input, train_target, test_target = train_test_split(
    fish_data, fish_target, stratify=fish_target, random_state=42)
1
print(test_target)
stratify: 타깃 데이터를 전달하면 클래스 비율에 맞게 나눠 준다 (층화 샘플링)- 샘플 개수가 적거나 특정 클래스의 샘플이 적을 때 특히 유용하다
수상한 도미 한 마리
1
2
3
4
5
from sklearn.neighbors import KNeighborsClassifier

kn = KNeighborsClassifier()
kn.fit(train_input, train_target)
kn.score(test_input, test_target)
1
1.0
1
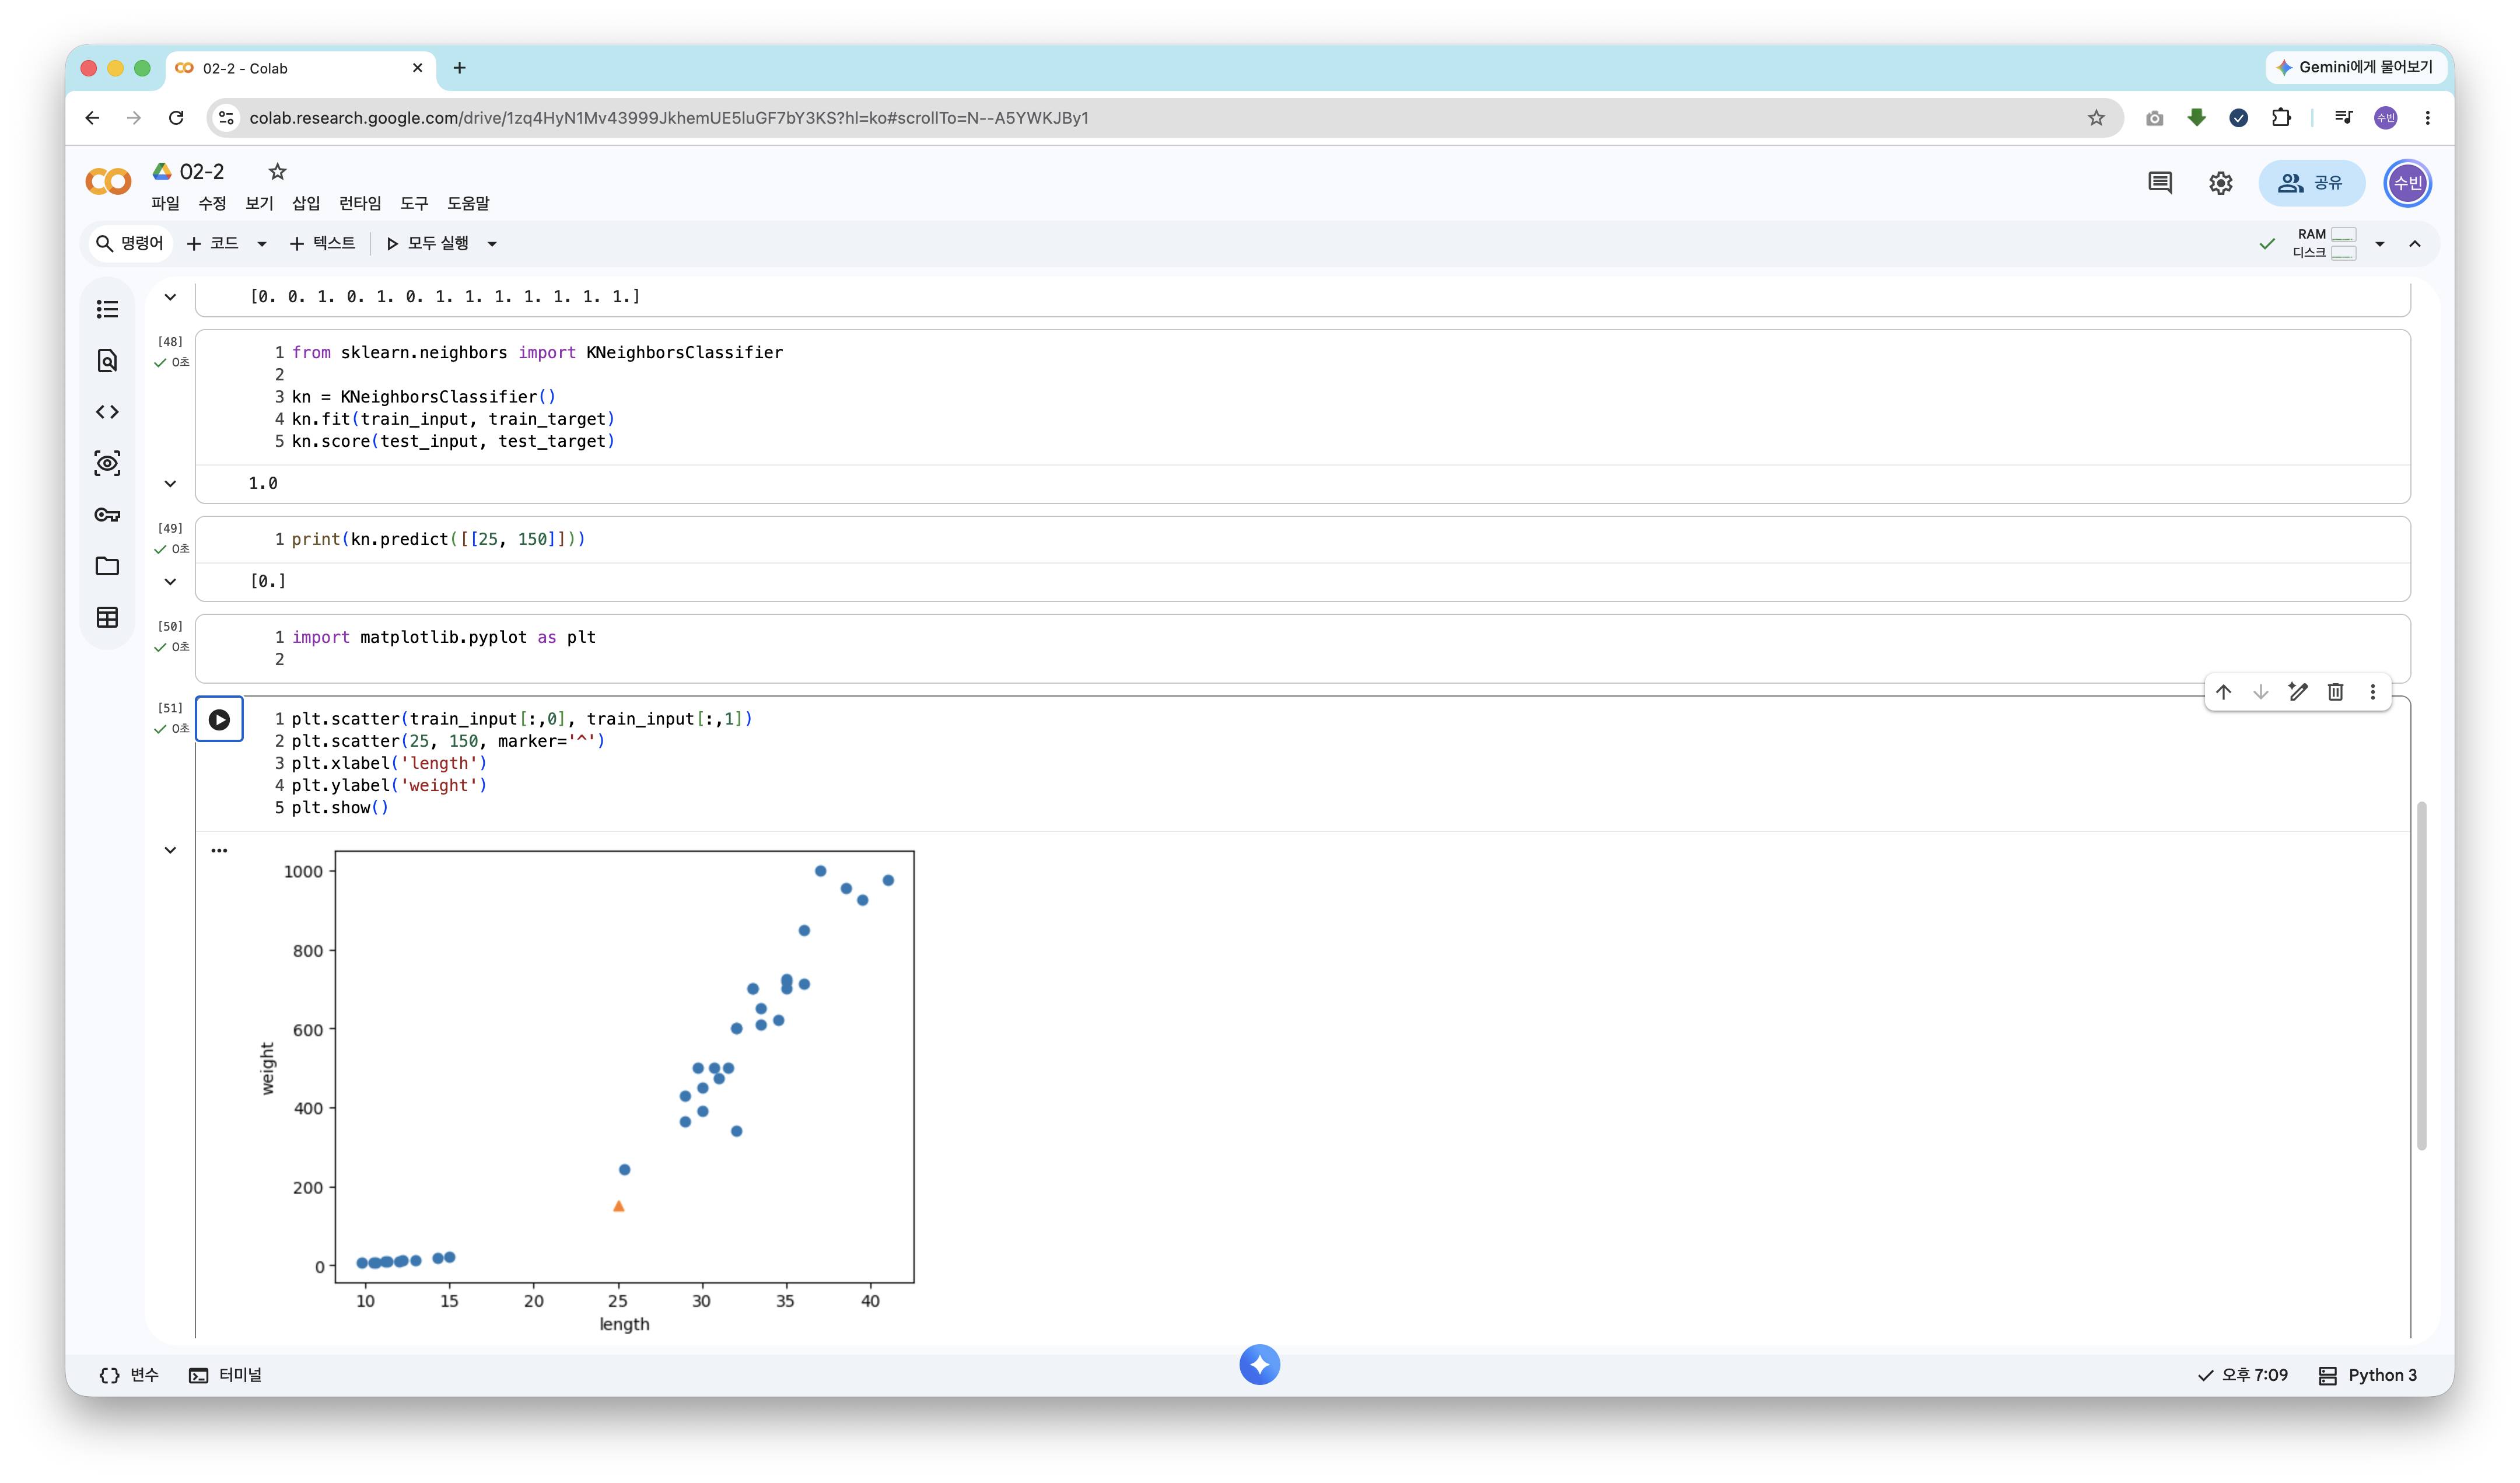
print(kn.predict([[25, 150]]))
1
[0.]
- 길이 25cm, 무게 150g인 생선은 도미인데 모델은 빙어(0) 로 예측했다
1
import matplotlib.pyplot as plt
1
2
3
4
5
plt.scatter(train_input[:,0], train_input[:,1])
plt.scatter(25, 150, marker='^')
plt.xlabel('length')
plt.ylabel('weight')
plt.show()
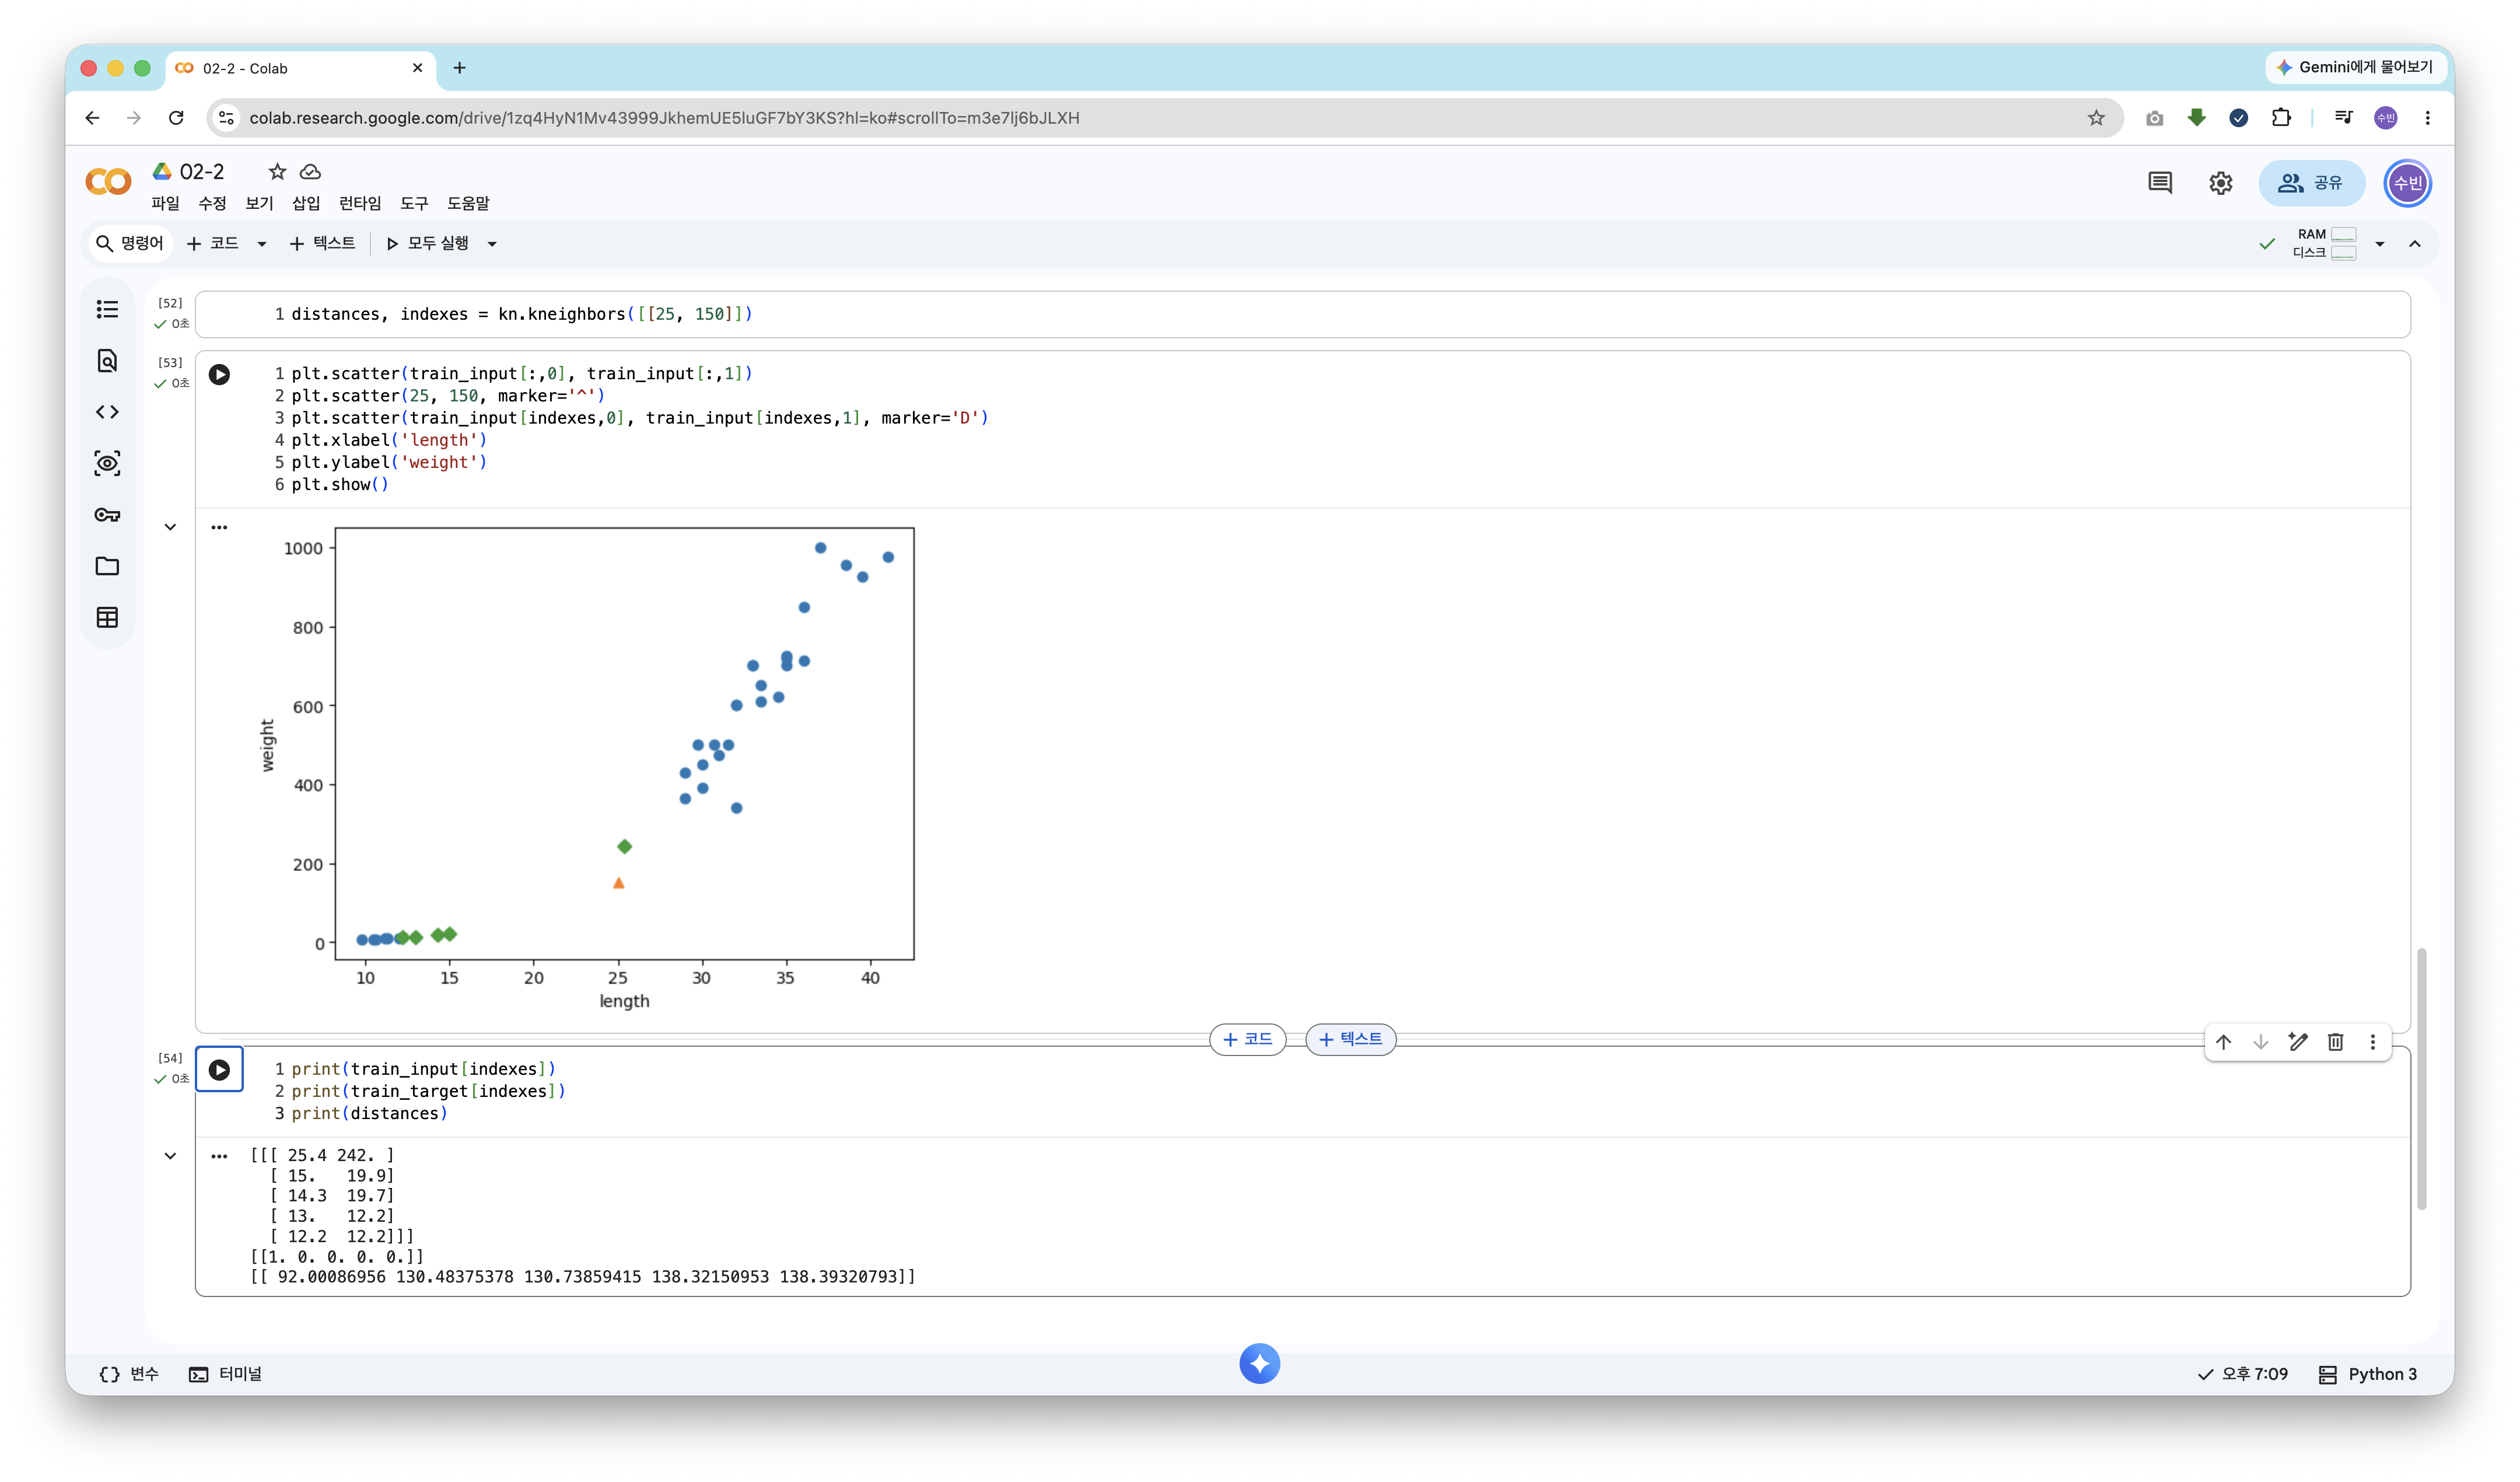
- 산점도로 보면 이 샘플(삼각형)은 분명히 도미 쪽에 가깝다
1
distances, indexes = kn.kneighbors([[25, 150]])
kneighbors(): 가장 가까운 이웃의 거리와 인덱스를 반환한다
1
2
3
4
5
6
plt.scatter(train_input[:,0], train_input[:,1])
plt.scatter(25, 150, marker='^')
plt.scatter(train_input[indexes,0], train_input[indexes,1], marker='D')
plt.xlabel('length')
plt.ylabel('weight')
plt.show()
1
2
3
print(train_input[indexes])
print(train_target[indexes])
print(distances)
- 이웃 5개 중 4개가 빙어였다. 눈으로 보기에는 도미가 더 가까운데도 그렇다
기준을 맞춰라
1
2
3
4
5
6
7
plt.scatter(train_input[:,0], train_input[:,1])
plt.scatter(25, 150, marker='^')
plt.scatter(train_input[indexes,0], train_input[indexes,1], marker='D')
plt.xlim((0, 1000))
plt.xlabel('length')
plt.ylabel('weight')
plt.show()
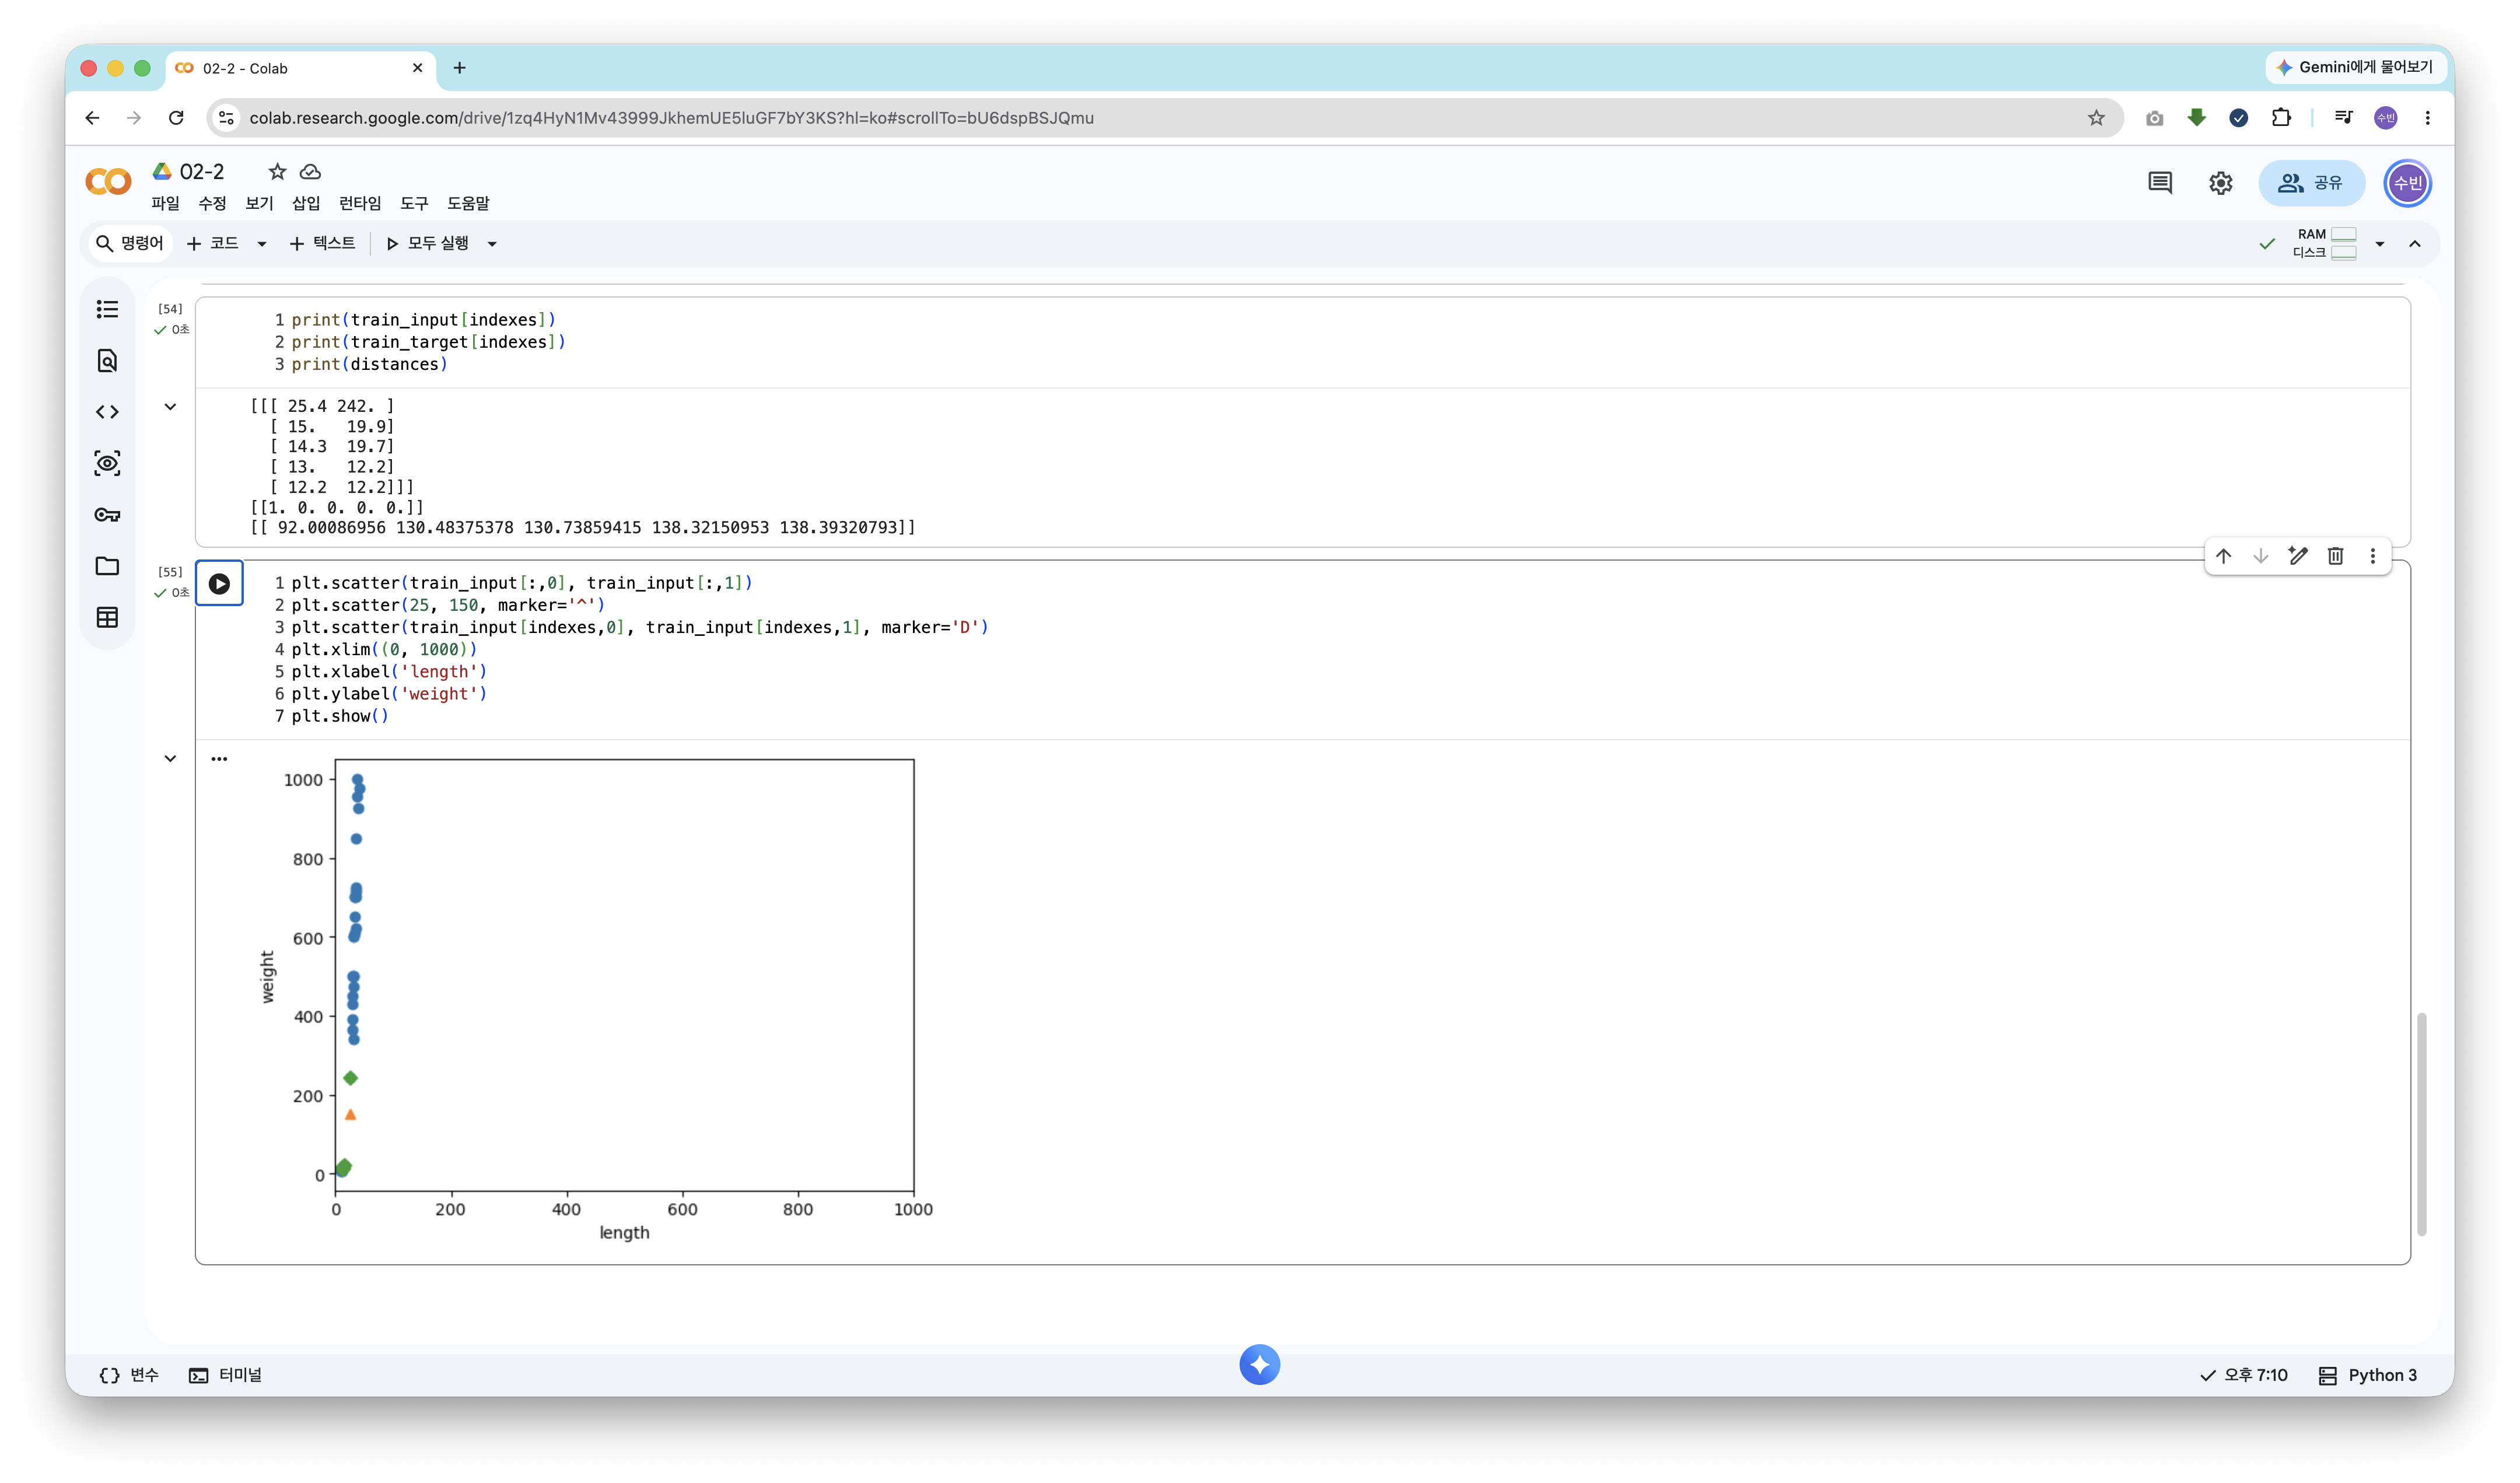
- x축 범위를 y축과 똑같이 0~1000으로 맞춰 보면, 데이터가 y축(무게) 방향으로만 퍼져 있다
- 원인: 길이는 10~40, 무게는 6~1000으로 두 특성의 스케일(범위)이 다르다
- 거리를 계산할 때 값의 범위가 큰 무게가 거리 계산을 독차지하게 된다
- k-최근접 이웃처럼 거리를 사용하는 알고리즘은 특성의 스케일을 맞춰야 한다
- 데이터 전처리(data preprocessing): 특성값을 일정한 기준으로 맞추는 작업
- 표준점수(z 점수): 각 특성값이 평균에서 표준편차의 몇 배만큼 떨어져 있는지 나타내는 값
1
2
mean = np.mean(train_input, axis=0)
std = np.std(train_input, axis=0)
1
print(mean, std)
np.mean(): 평균,np.std(): 표준편차axis=0: 행을 따라 각 열의 통계를 계산한다 (특성별로 계산)
1
train_scaled = (train_input - mean) / std
- 브로드캐스팅(broadcasting): 크기가 다른 배열끼리 연산할 때 넘파이가 자동으로 크기를 맞춰 계산해 주는 기능
전처리 데이터로 모델 훈련하기
1
2
3
4
5
plt.scatter(train_scaled[:,0], train_scaled[:,1])
plt.scatter(25, 150, marker='^')
plt.xlabel('length')
plt.ylabel('weight')
plt.show()
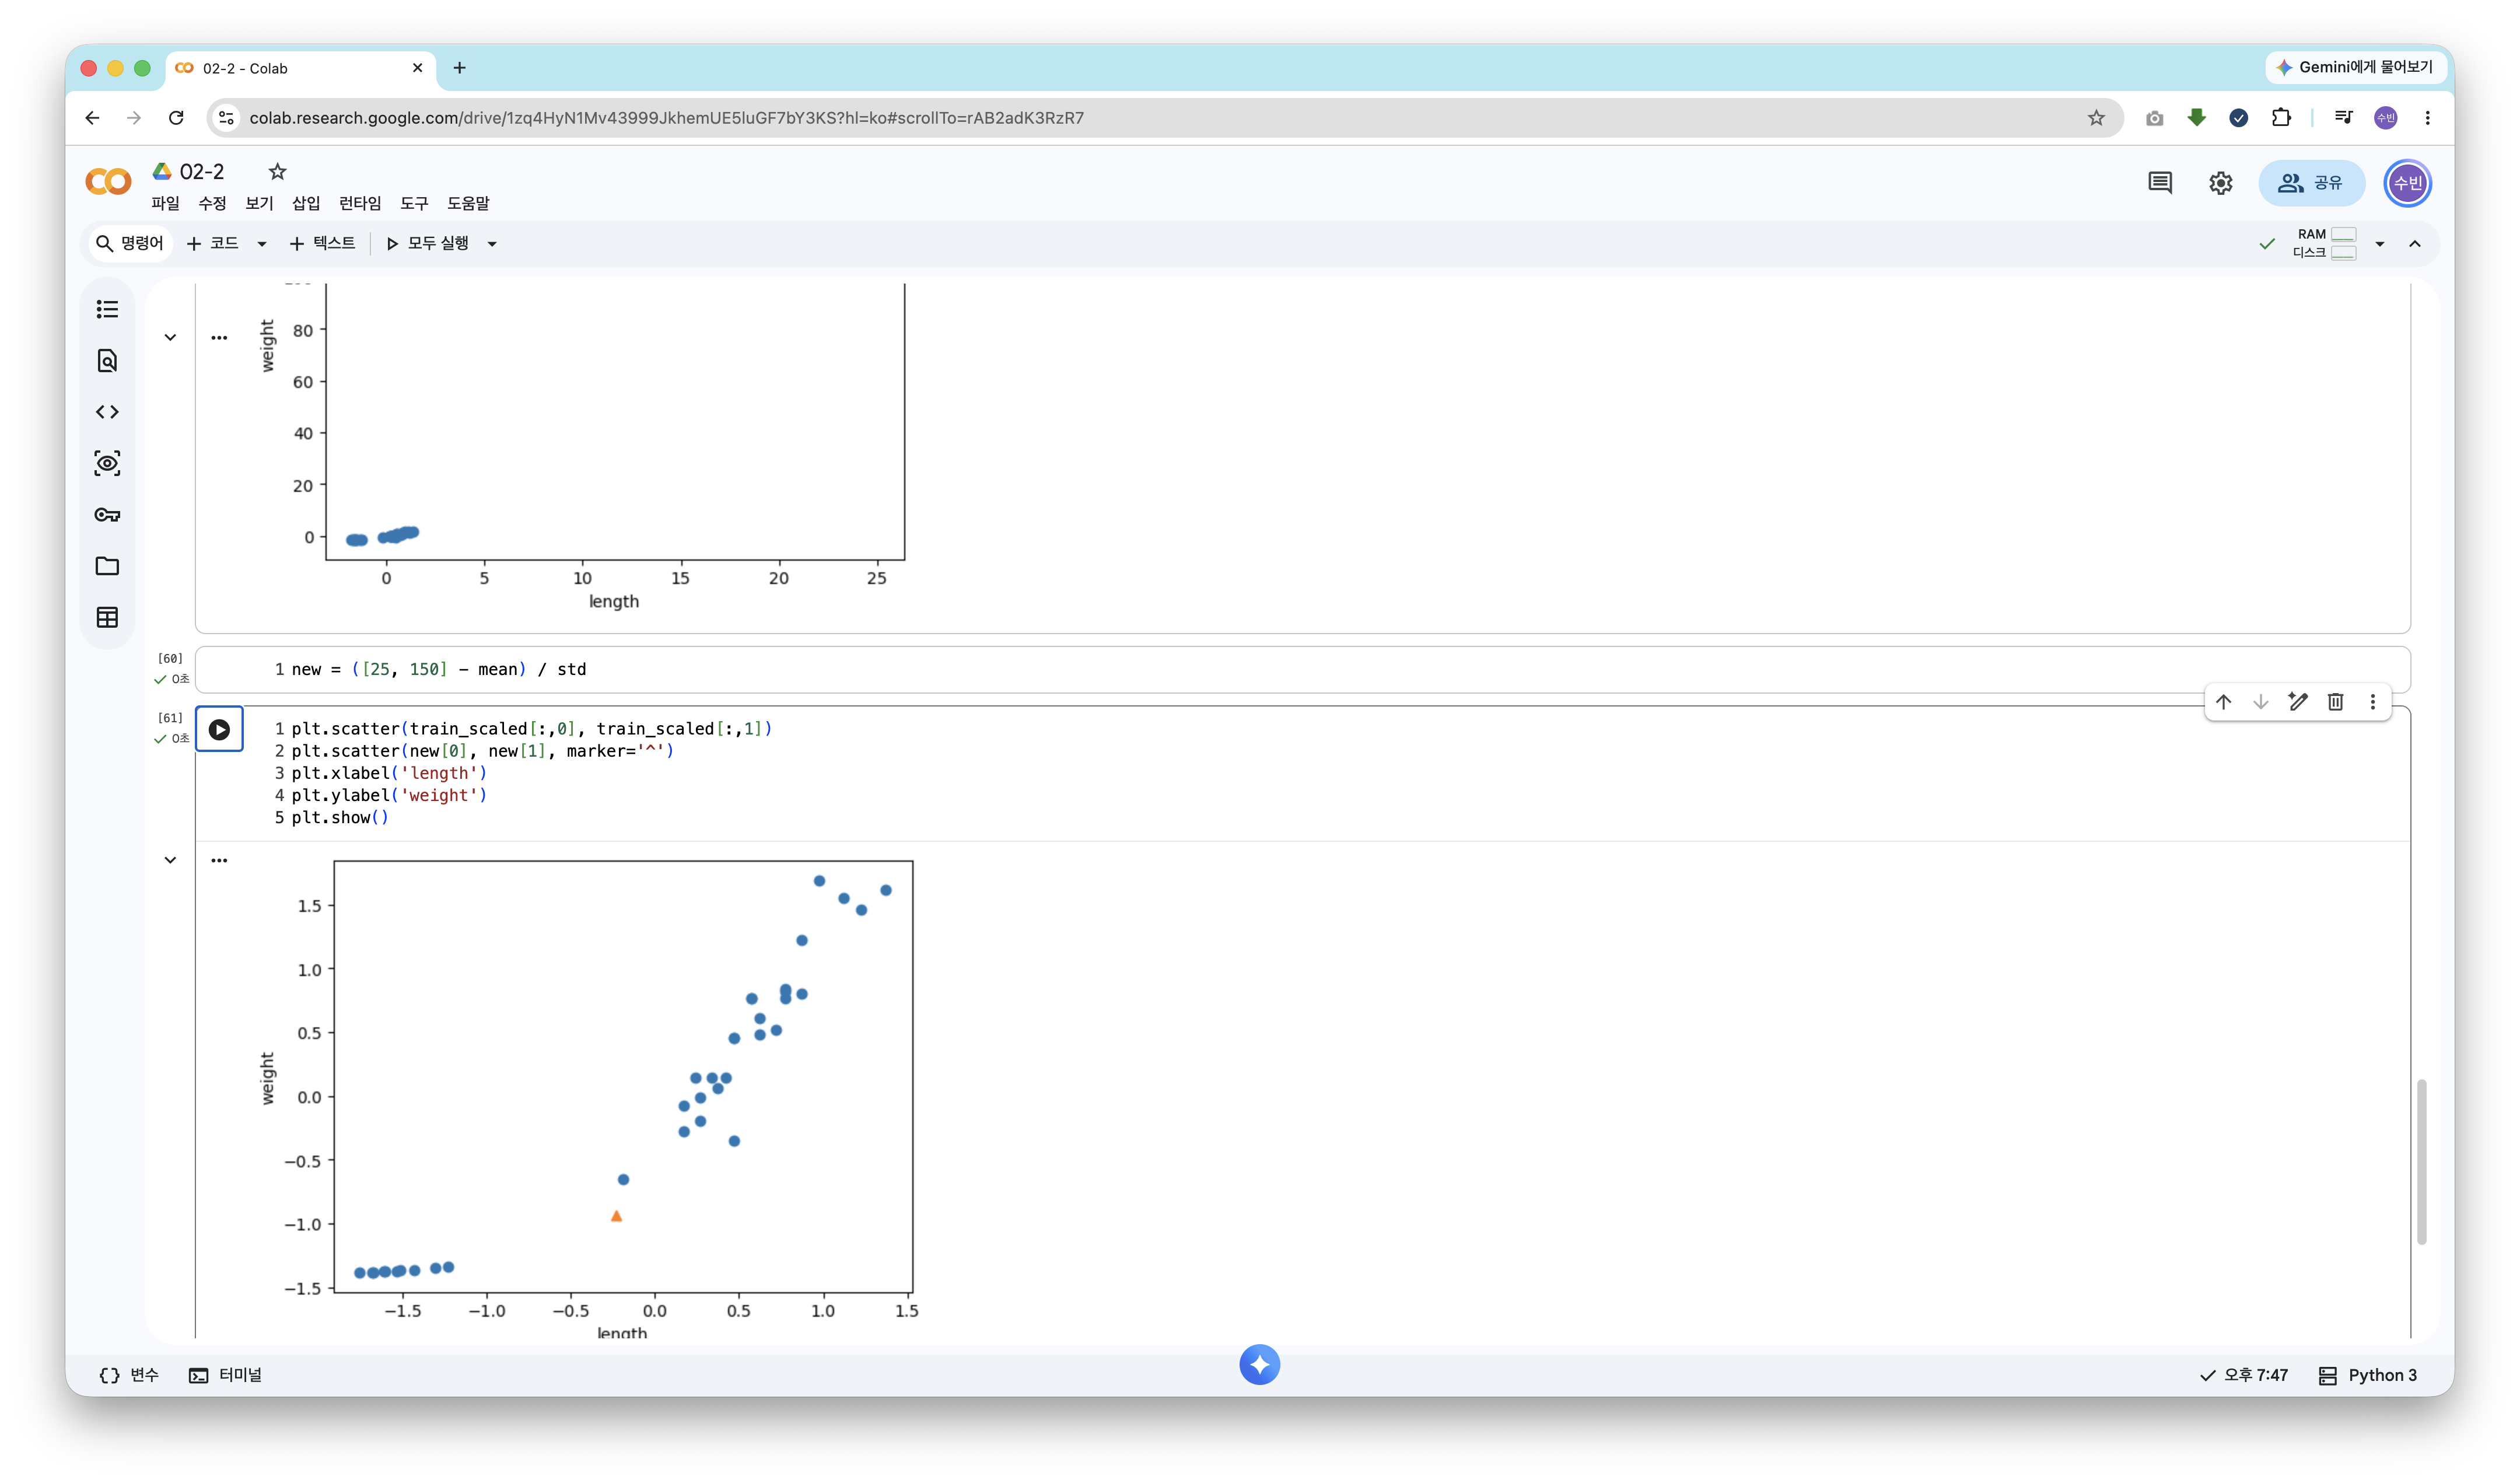
- 훈련 세트만 변환하고 샘플은 그대로 두면 샘플이 그래프 밖으로 나가 버린다
- 테스트할 샘플도 훈련 세트의 평균과 표준편차로 똑같이 변환해야 한다
1
new = ([25, 150] - mean) / std
1
2
3
4
5
plt.scatter(train_scaled[:,0], train_scaled[:,1])
plt.scatter(new[0], new[1], marker='^')
plt.xlabel('length')
plt.ylabel('weight')
plt.show()
1
kn.fit(train_scaled, train_target)
1
test_scaled = (test_input - mean) / std
1
kn.score(test_scaled, test_target)
1
1.0
1
print(kn.predict([new]))
1
[1.]
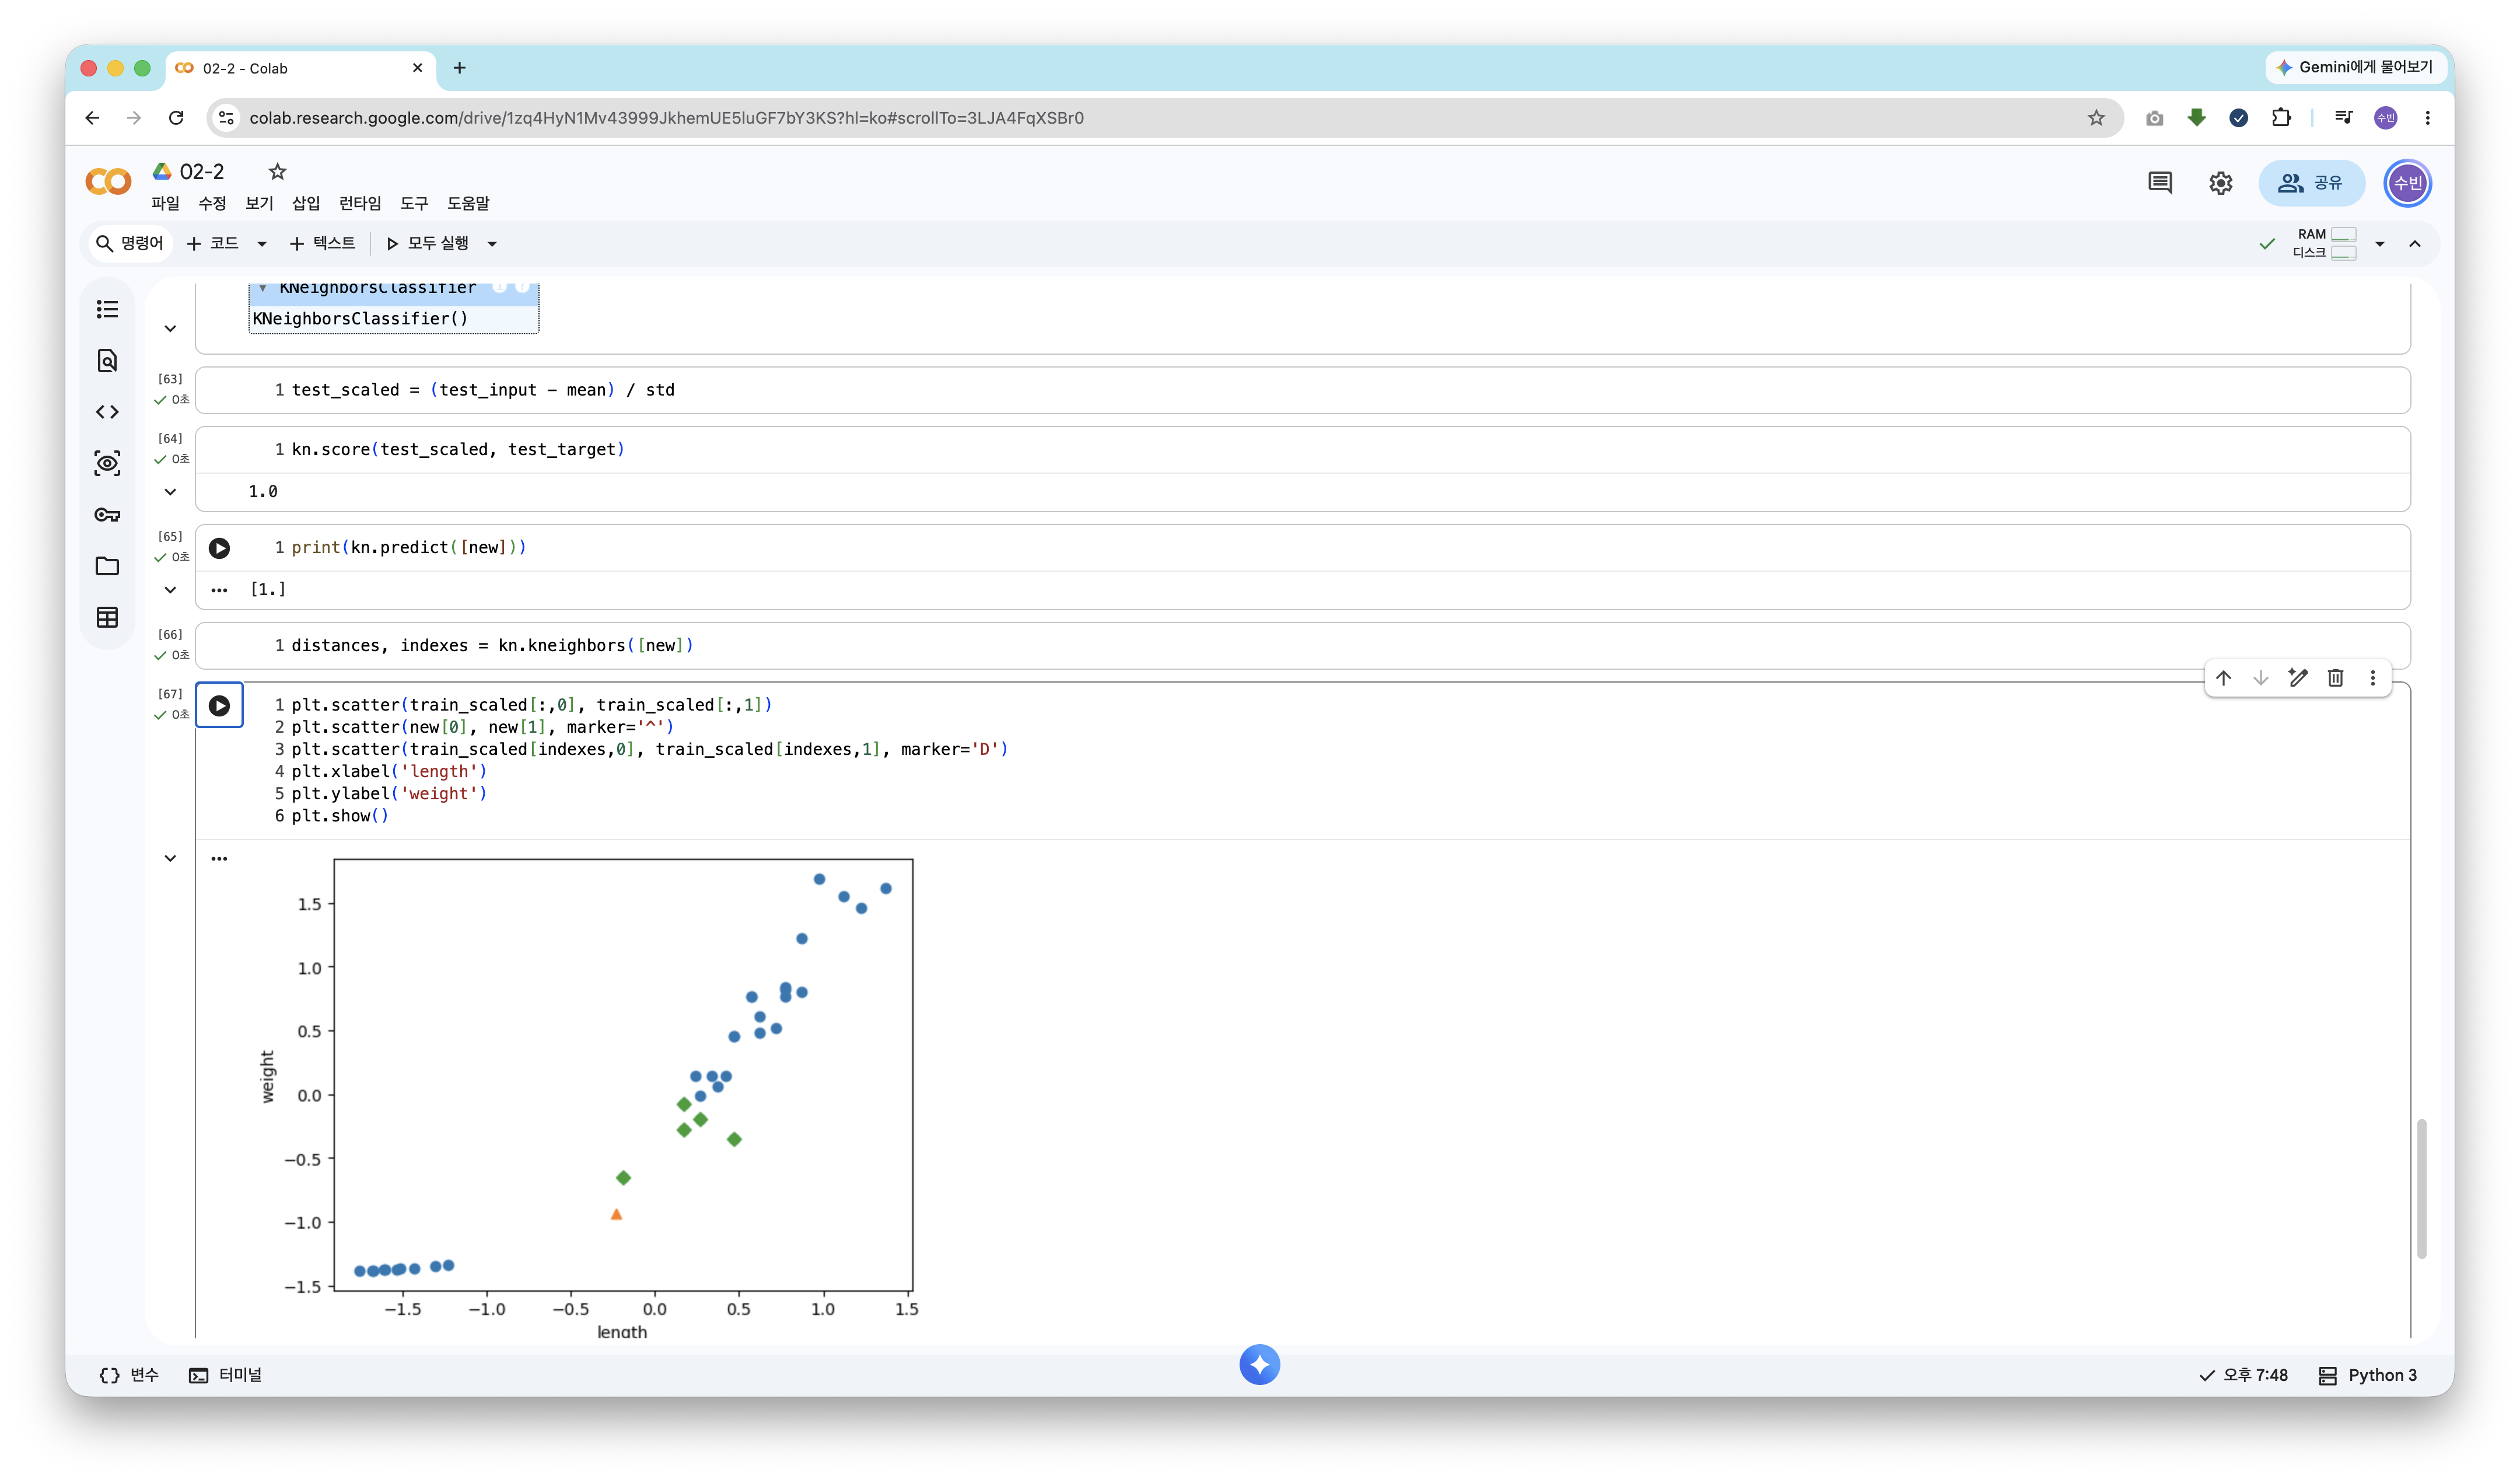
- 전처리 후에는 같은 샘플을 도미(1) 로 정확히 예측한다
1
distances, indexes = kn.kneighbors([new])
1
2
3
4
5
6
plt.scatter(train_scaled[:,0], train_scaled[:,1])
plt.scatter(new[0], new[1], marker='^')
plt.scatter(train_scaled[indexes,0], train_scaled[indexes,1], marker='D')
plt.xlabel('length')
plt.ylabel('weight')
plt.show()
- 이웃 5개가 모두 도미로 바뀌었다
스케일이 다른 특성 처리
이번 절의 문제 해결 과정을 정리하면 다음과 같다.
- 문제 인식: 정확도 1.0인 모델이 길이 25cm, 무게 150g인 도미를 빙어로 예측
- 원인 파악:
kneighbors()로 이웃을 확인 → 이웃 5개 중 4개가 빙어 - 근본 원인: 길이(10~40)와 무게(6~1000)의 스케일 차이 때문에 거리 계산이 무게에 좌우됨
- 해결: 표준점수로 두 특성을 같은 기준으로 변환 (데이터 전처리)
- 재평가: 테스트 세트 정확도 1.0, 문제의 샘플도 도미로 정확히 예측
- 훈련 세트를 변환한 평균과 표준편차를 그대로 사용해 테스트 세트와 새로운 샘플도 변환해야 한다
📌 정리
- 지도 학습은 입력과 타깃으로 훈련하고, 훈련 세트와 테스트 세트를 나눠 평가해야 한다
- 데이터를 섞지 않고 나누면 샘플링 편향이 생긴다 → 넘파이로 인덱스를 섞거나
train_test_split(stratify=...)을 쓴다 - 길이와 무게처럼 스케일이 다르면 거리 기반 알고리즘이 한쪽 특성에 좌우된다 → 표준점수로 전처리한다
- 테스트 세트와 새로운 샘플도 훈련 세트의 평균·표준편차로 똑같이 변환해야 한다
핵심 용어: 지도 학습 / 비지도 학습 / 훈련 세트 / 테스트 세트 / 샘플링 편향 / 넘파이 / 브로드캐스팅 / 데이터 전처리 / 표준점수
This post is licensed under CC BY 4.0 by the author.