“혼자 공부하는 머신러닝+딥러닝(개정판)” 도서 바로가기
예제 코드 (저자 제공): 04-1, 04-2
4장. 다양한 분류 알고리즘
04-1. 로지스틱 회귀
럭키백의 확률
- 상황: 럭키백에 들어 있는 생선이 어떤 종류일지 확률로 알려 줘야 한다
- 지금까지는 클래스를 하나로 딱 정해 주는 분류만 했다. 이번에는 클래스별 확률을 구한다
- 다중 분류(multi-class classification): 타깃 클래스가 3개 이상인 분류 문제
1
2
3
4
| import pandas as pd
fish = pd.read_csv('https://bit.ly/fish_csv_data')
fish.head()
|
read_csv()로 인터넷에 있는 CSV 파일을 바로 읽어 데이터프레임으로 만든다head()는 처음 5개 행만 보여 준다. 열은 생선 종류(Species)와 무게·길이·대각선·높이·두께 5개 특성으로 이루어져 있다
1
2
3
4
5
6
| Species Weight Length Diagonal Height Width
0 Bream 242.0 25.4 30.0 11.5200 4.0200
1 Bream 290.0 26.3 31.2 12.4800 4.3056
2 Bream 340.0 26.5 31.1 12.3778 4.6961
3 Bream 363.0 29.0 33.5 12.7300 4.4555
4 Bream 430.0 29.0 34.0 12.4440 5.1340
|
1
| print(pd.unique(fish['Species']))
|
1
| ['Bream' 'Roach' 'Whitefish' 'Parkki' 'Perch' 'Pike' 'Smelt']
|
pd.unique(): 열에서 중복을 제외한 고유값을 뽑는다. 생선은 7종류다
1
| fish_input = fish[['Weight','Length','Diagonal','Height','Width']]
|
- 데이터프레임에 열 이름 리스트를 넣으면 그 열들만 골라 새 데이터프레임을 만든다
Species를 뺀 5개 열이 입력 데이터가 된다
1
| fish_target = fish['Species']
|
- 맞혀야 할 정답인 생선 종류(
Species) 열은 따로 떼어 타깃 데이터로 만든다
1
2
3
4
| from sklearn.model_selection import train_test_split
train_input, test_input, train_target, test_target = train_test_split(
fish_input, fish_target, random_state=42)
|
- 2장에서 했던 것처럼 훈련 세트와 테스트 세트로 나눈다.
random_state=42로 고정해 실행할 때마다 같은 결과가 나오게 한다
1
2
3
4
5
6
| from sklearn.preprocessing import StandardScaler
ss = StandardScaler()
ss.fit(train_input)
train_scaled = ss.transform(train_input)
test_scaled = ss.transform(test_input)
|
- 무게(수백 g)와 길이(수십 cm)처럼 특성마다 범위가 다르므로 표준화한다
fit()은 훈련 세트로만 하고, 같은 기준으로 테스트 세트도 변환한다
1
2
3
4
5
6
7
| from sklearn.neighbors import KNeighborsClassifier
kn = KNeighborsClassifier(n_neighbors=3)
kn.fit(train_scaled, train_target)
print(kn.score(train_scaled, train_target))
print(kn.score(test_scaled, test_target))
|
1
2
| 0.8907563025210085
0.85
|
- 먼저 익숙한 k-최근접 이웃 분류기로 7개 클래스를 분류해 본다. 점수 자체보다 확률을 어떻게 내는지가 이번 절의 관심사다
1
| ['Bream' 'Parkki' 'Perch' 'Pike' 'Roach' 'Smelt' 'Whitefish']
|
classes_: 사이킷런이 정렬한 타깃값. 문자열 타깃도 그대로 사용할 수 있다
1
| print(kn.predict(test_scaled[:5]))
|
1
| ['Perch' 'Smelt' 'Pike' 'Perch' 'Perch']
|
- 테스트 세트의 처음 5개 샘플을 예측했다. 결과는 클래스 하나로만 나온다
- 이번에는 각 클래스일 확률이 얼마인지도 알아보자
1
2
3
4
| import numpy as np
proba = kn.predict_proba(test_scaled[:5])
print(np.round(proba, decimals=4))
|
1
2
3
4
5
| [[0. 0. 1. 0. 0. 0. 0. ]
[0. 0. 0. 0. 0. 1. 0. ]
[0. 0. 0. 1. 0. 0. 0. ]
[0. 0. 0.6667 0. 0.3333 0. 0. ]
[0. 0. 0.6667 0. 0.3333 0. 0. ]]
|
predict_proba(): 클래스별 확률을 반환한다. 열의 순서는 classes_와 같다
1
2
| distances, indexes = kn.kneighbors(test_scaled[3:4])
print(train_target.iloc[indexes[0]])
|
로지스틱 회귀
: 이름은 회귀지만 분류 모델. 선형 방정식을 학습한 뒤 그 결과를 확률로 바꿔 예측한다
- z = a × (Weight) + b × (Length) + c × (Diagonal) + d × (Height) + e × (Width) + f
- a~e는 각 특성의 가중치(계수), f는 절편이다. 3장의 다중 회귀와 같은 모양이다
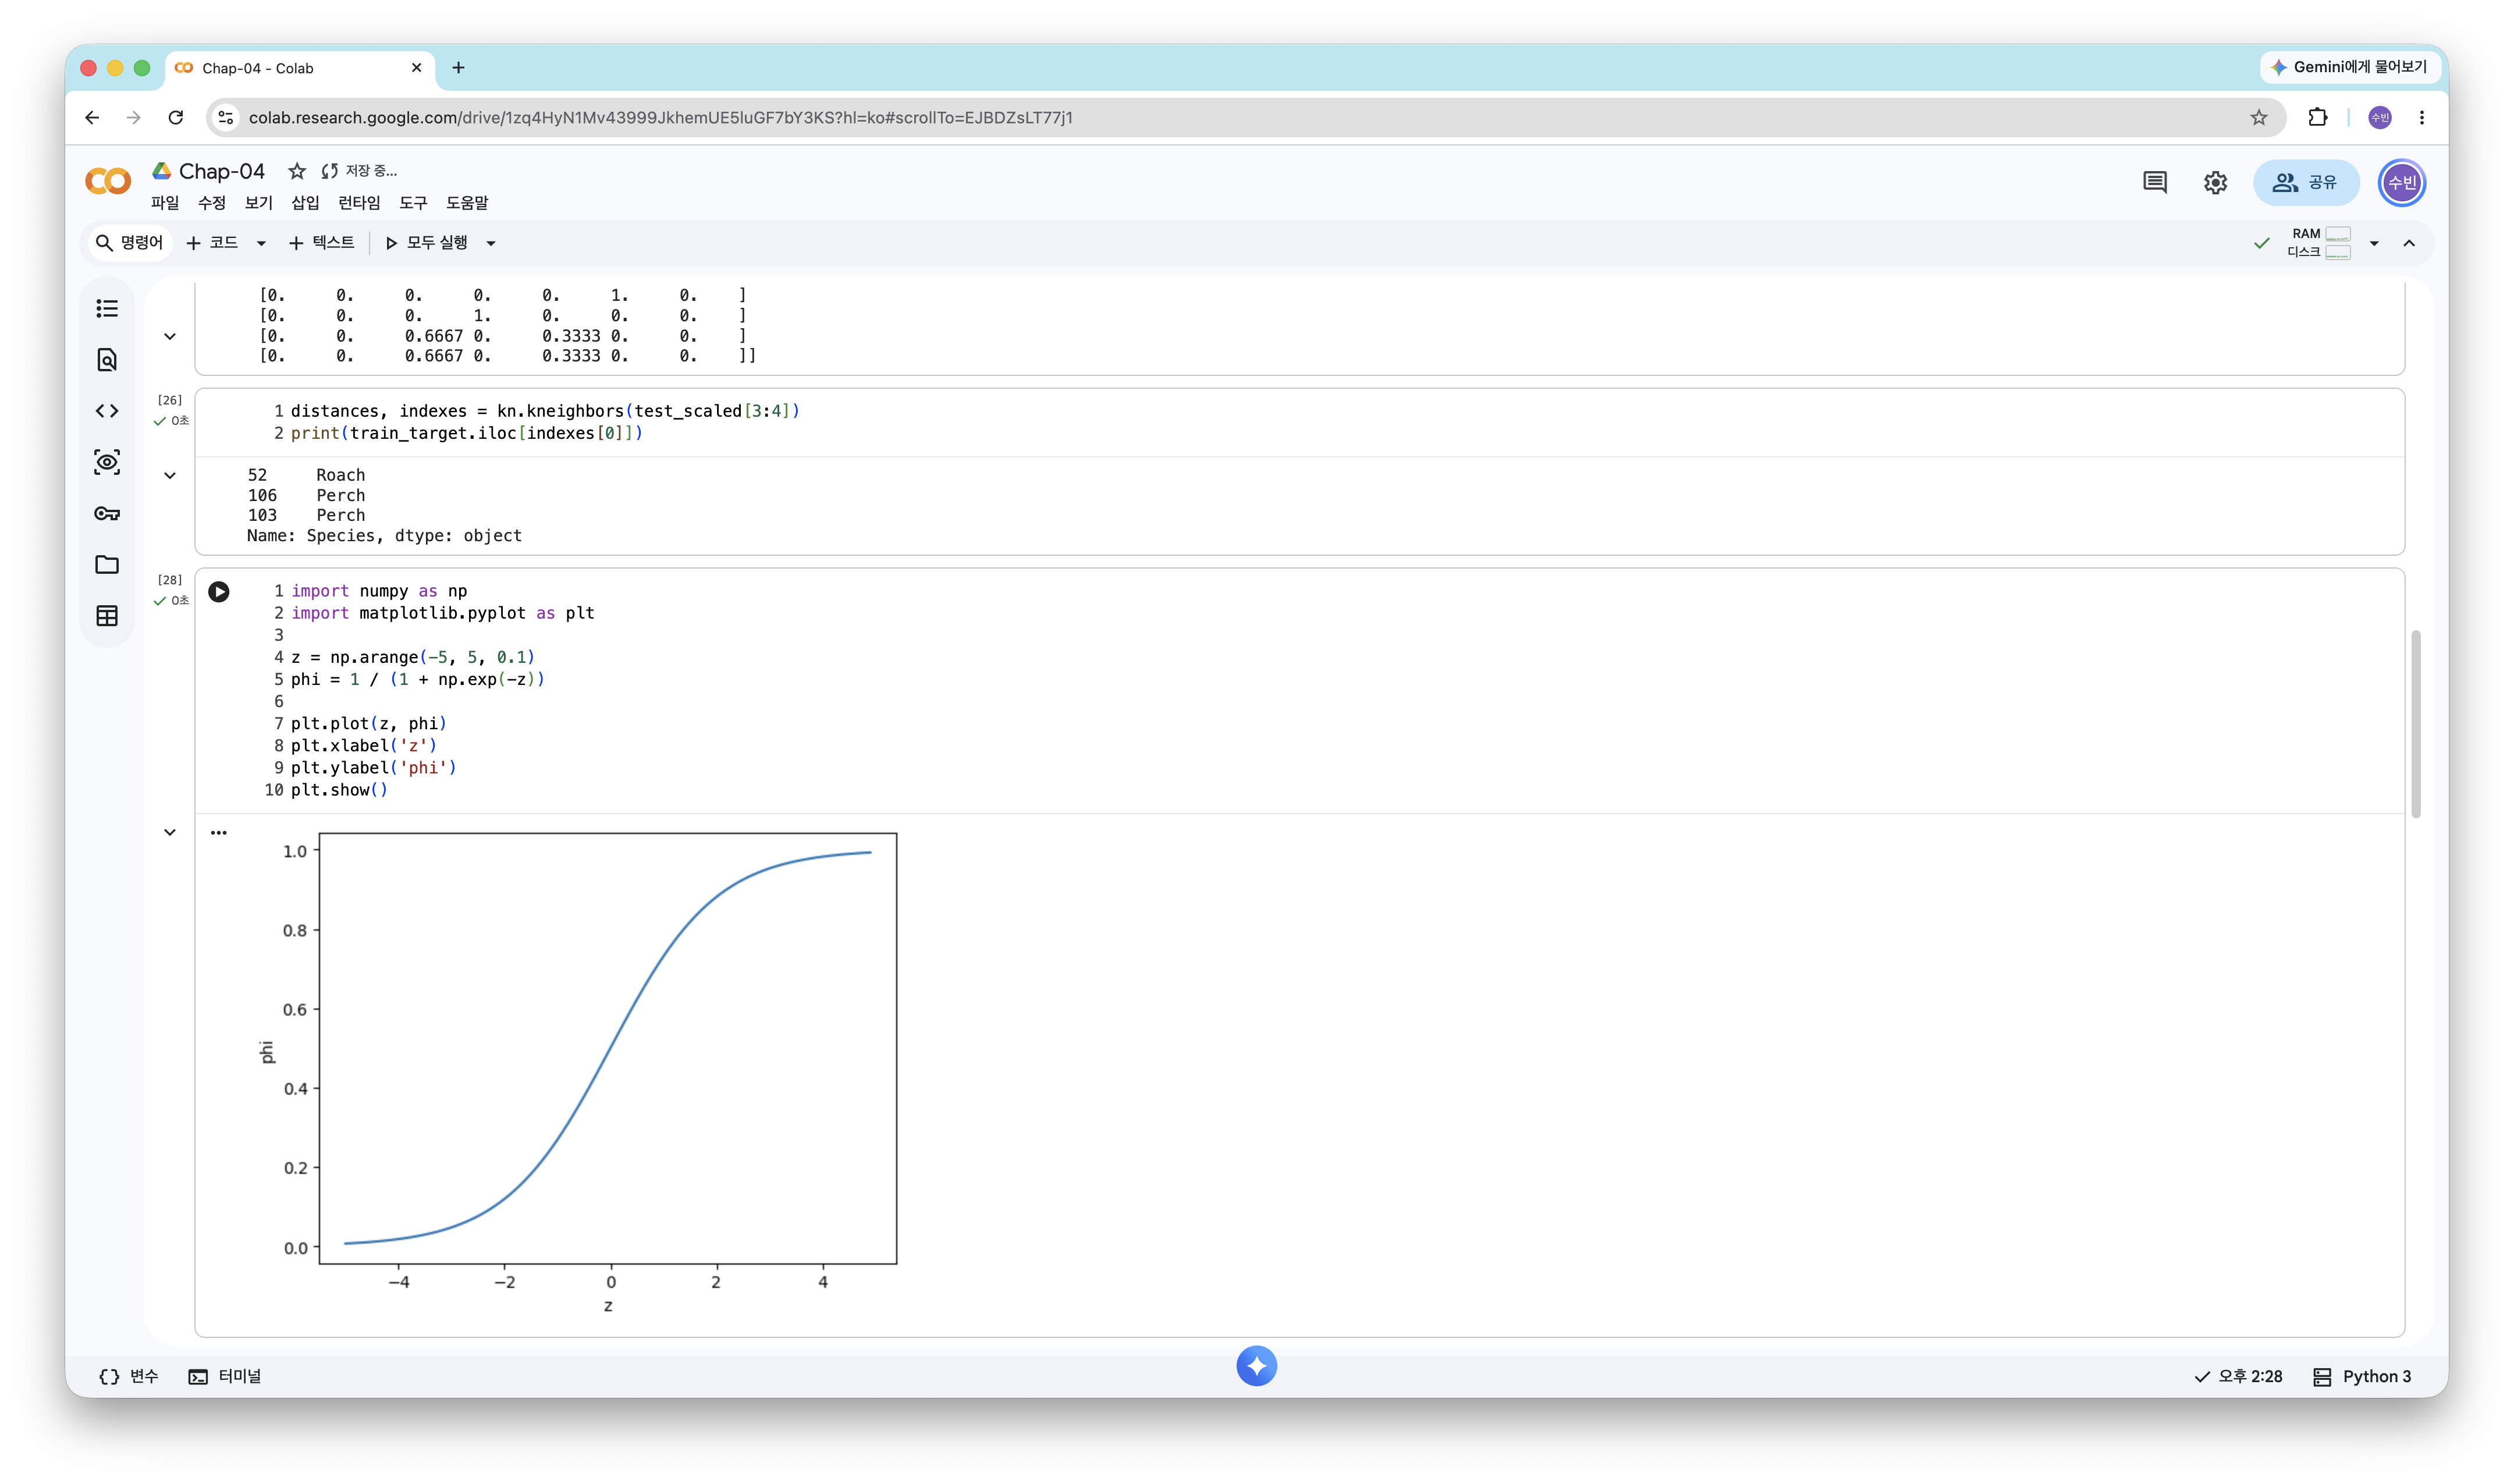
- z는 어떤 값도 될 수 있으므로, 시그모이드 함수(로지스틱 함수) 로 0~1 사이 확률로 바꾼다
1
2
3
4
5
6
7
8
9
10
| import numpy as np
import matplotlib.pyplot as plt
z = np.arange(-5, 5, 0.1)
phi = 1 / (1 + np.exp(-z))
plt.plot(z, phi)
plt.xlabel('z')
plt.ylabel('phi')
plt.show()
|
np.arange(-5, 5, 0.1)로 −5부터 5까지 0.1 간격의 z 값을 만들고, 시그모이드 식 1 / (1 + e^(−z))에 넣어 그렸다- z가 아주 큰 음수면 0에, 아주 큰 양수면 1에 가까워진다
- z가 0일 때 정확히 0.5가 된다. 그래서 이진 분류에서는 0.5보다 크면 양성 클래스, 작으면 음성 클래스로 판단한다
1
2
| char_arr = np.array(['A', 'B', 'C', 'D', 'E'])
print(char_arr[[True, False, True, False, False]])
|
- 불리언 인덱싱(boolean indexing): True/False 값을 전달해 원하는 원소만 고른다
1
2
3
| bream_smelt_indexes = (train_target == 'Bream') | (train_target == 'Smelt')
train_bream_smelt = train_scaled[bream_smelt_indexes]
target_bream_smelt = train_target[bream_smelt_indexes]
|
- 먼저 도미와 빙어 2개 클래스만 골라 이진 분류를 해 본다
== 비교로 도미인 행, 빙어인 행이 각각 True가 되고, |(OR)로 합치면 도미이거나 빙어인 행만 True가 된다- 이 불리언 배열로 훈련 세트에서 도미와 빙어 데이터만 골라낸다
1
2
3
4
| from sklearn.linear_model import LogisticRegression
lr = LogisticRegression()
lr.fit(train_bream_smelt, target_bream_smelt)
|
- 로지스틱 회귀는 선형 모델이므로
sklearn.linear_model 패키지에 있다. 사용법은 다른 모델과 똑같이 fit()으로 훈련한다
1
| print(lr.predict(train_bream_smelt[:5]))
|
1
| ['Bream' 'Smelt' 'Bream' 'Bream' 'Bream']
|
- 처음 5개 샘플 중 두 번째만 빙어로, 나머지는 도미로 예측했다
1
| print(lr.predict_proba(train_bream_smelt[:5]))
|
1
2
3
4
5
| [[0.99760007 0.00239993]
[0.02737325 0.97262675]
[0.99486386 0.00513614]
[0.98585047 0.01414953]
[0.99767419 0.00232581]]
|
- 샘플마다 2개의 확률이 나온다. 첫 번째 열은 음성 클래스(0), 두 번째 열은 양성 클래스(1)의 확률이다
- 예측 결과와 비교해 보면, 두 번째 샘플만 두 번째 열의 확률이 0.5보다 크다
- 이진 분류에서는 알파벳 순으로 뒤에 오는 쪽(Smelt)이 양성 클래스가 된다. 두 번째 열이 양성 클래스의 확률이다
1
| print(lr.coef_, lr.intercept_)
|
1
| [[-0.40451732 -0.57582787 -0.66248158 -1.01329614 -0.73123131]] [-2.16172774]
|
- 로지스틱 회귀가 학습한 방정식은 다음과 같다
- z = −0.405 × (Weight) − 0.576 × (Length) − 0.662 × (Diagonal) − 1.013 × (Height) − 0.731 × (Width) − 2.162
- 계수가 모두 음수이므로, 생선이 무겁고 클수록 z가 작아져 빙어(양성)일 확률이 낮아진다
1
2
| decisions = lr.decision_function(train_bream_smelt[:5])
print(decisions)
|
1
| [-6.02991358 3.57043428 -5.26630496 -4.24382314 -6.06135688]
|
decision_function(): 시그모이드를 거치기 전의 z 값을 반환한다- 이진 분류에서는 양성 클래스(Smelt)에 대한 z 값이다. 양수인 두 번째 샘플만 빙어로 예측된 것과 일치한다
1
2
3
| from scipy.special import expit
print(expit(decisions))
|
1
| [0.00239993 0.97262675 0.00513614 0.01414953 0.00232581]
|
expit(): 사이파이(SciPy)의 시그모이드 함수. z를 넣으면 predict_proba()의 두 번째 열과 같은 값이 나온다- 즉
decision_function()으로 z를 구하고 시그모이드에 넣으면 확률이 된다는 것을 직접 확인한 셈이다 - 이제 도미·빙어만이 아니라 7개 생선 전체로 다중 분류를 해 보자
1
2
3
4
5
| lr = LogisticRegression(C=20, max_iter=1000)
lr.fit(train_scaled, train_target)
print(lr.score(train_scaled, train_target))
print(lr.score(test_scaled, test_target))
|
1
2
| 0.9327731092436975
0.925
|
- 이번에는 7개 클래스 전체로 다중 분류를 한다
C: 규제를 제어하는 매개변수. 작을수록 규제가 강해진다 (릿지의 alpha와 반대)max_iter: 반복 횟수. 기본값 100으로는 부족해 경고가 뜨므로 1000으로 늘린다
1
| print(lr.predict(test_scaled[:5]))
|
1
| ['Perch' 'Smelt' 'Pike' 'Roach' 'Perch']
|
- 테스트 세트 처음 5개 샘플의 예측 결과다. k-최근접 이웃과 달리 네 번째 샘플을 Roach로 예측했다
1
2
| proba = lr.predict_proba(test_scaled[:5])
print(np.round(proba, decimals=3))
|
1
2
3
4
5
| [[0. 0.014 0.842 0. 0.135 0.007 0.003]
[0. 0.003 0.044 0. 0.007 0.946 0. ]
[0. 0. 0.034 0.934 0.015 0.016 0. ]
[0.011 0.034 0.305 0.006 0.567 0. 0.076]
[0. 0. 0.904 0.002 0.089 0.002 0.001]]
|
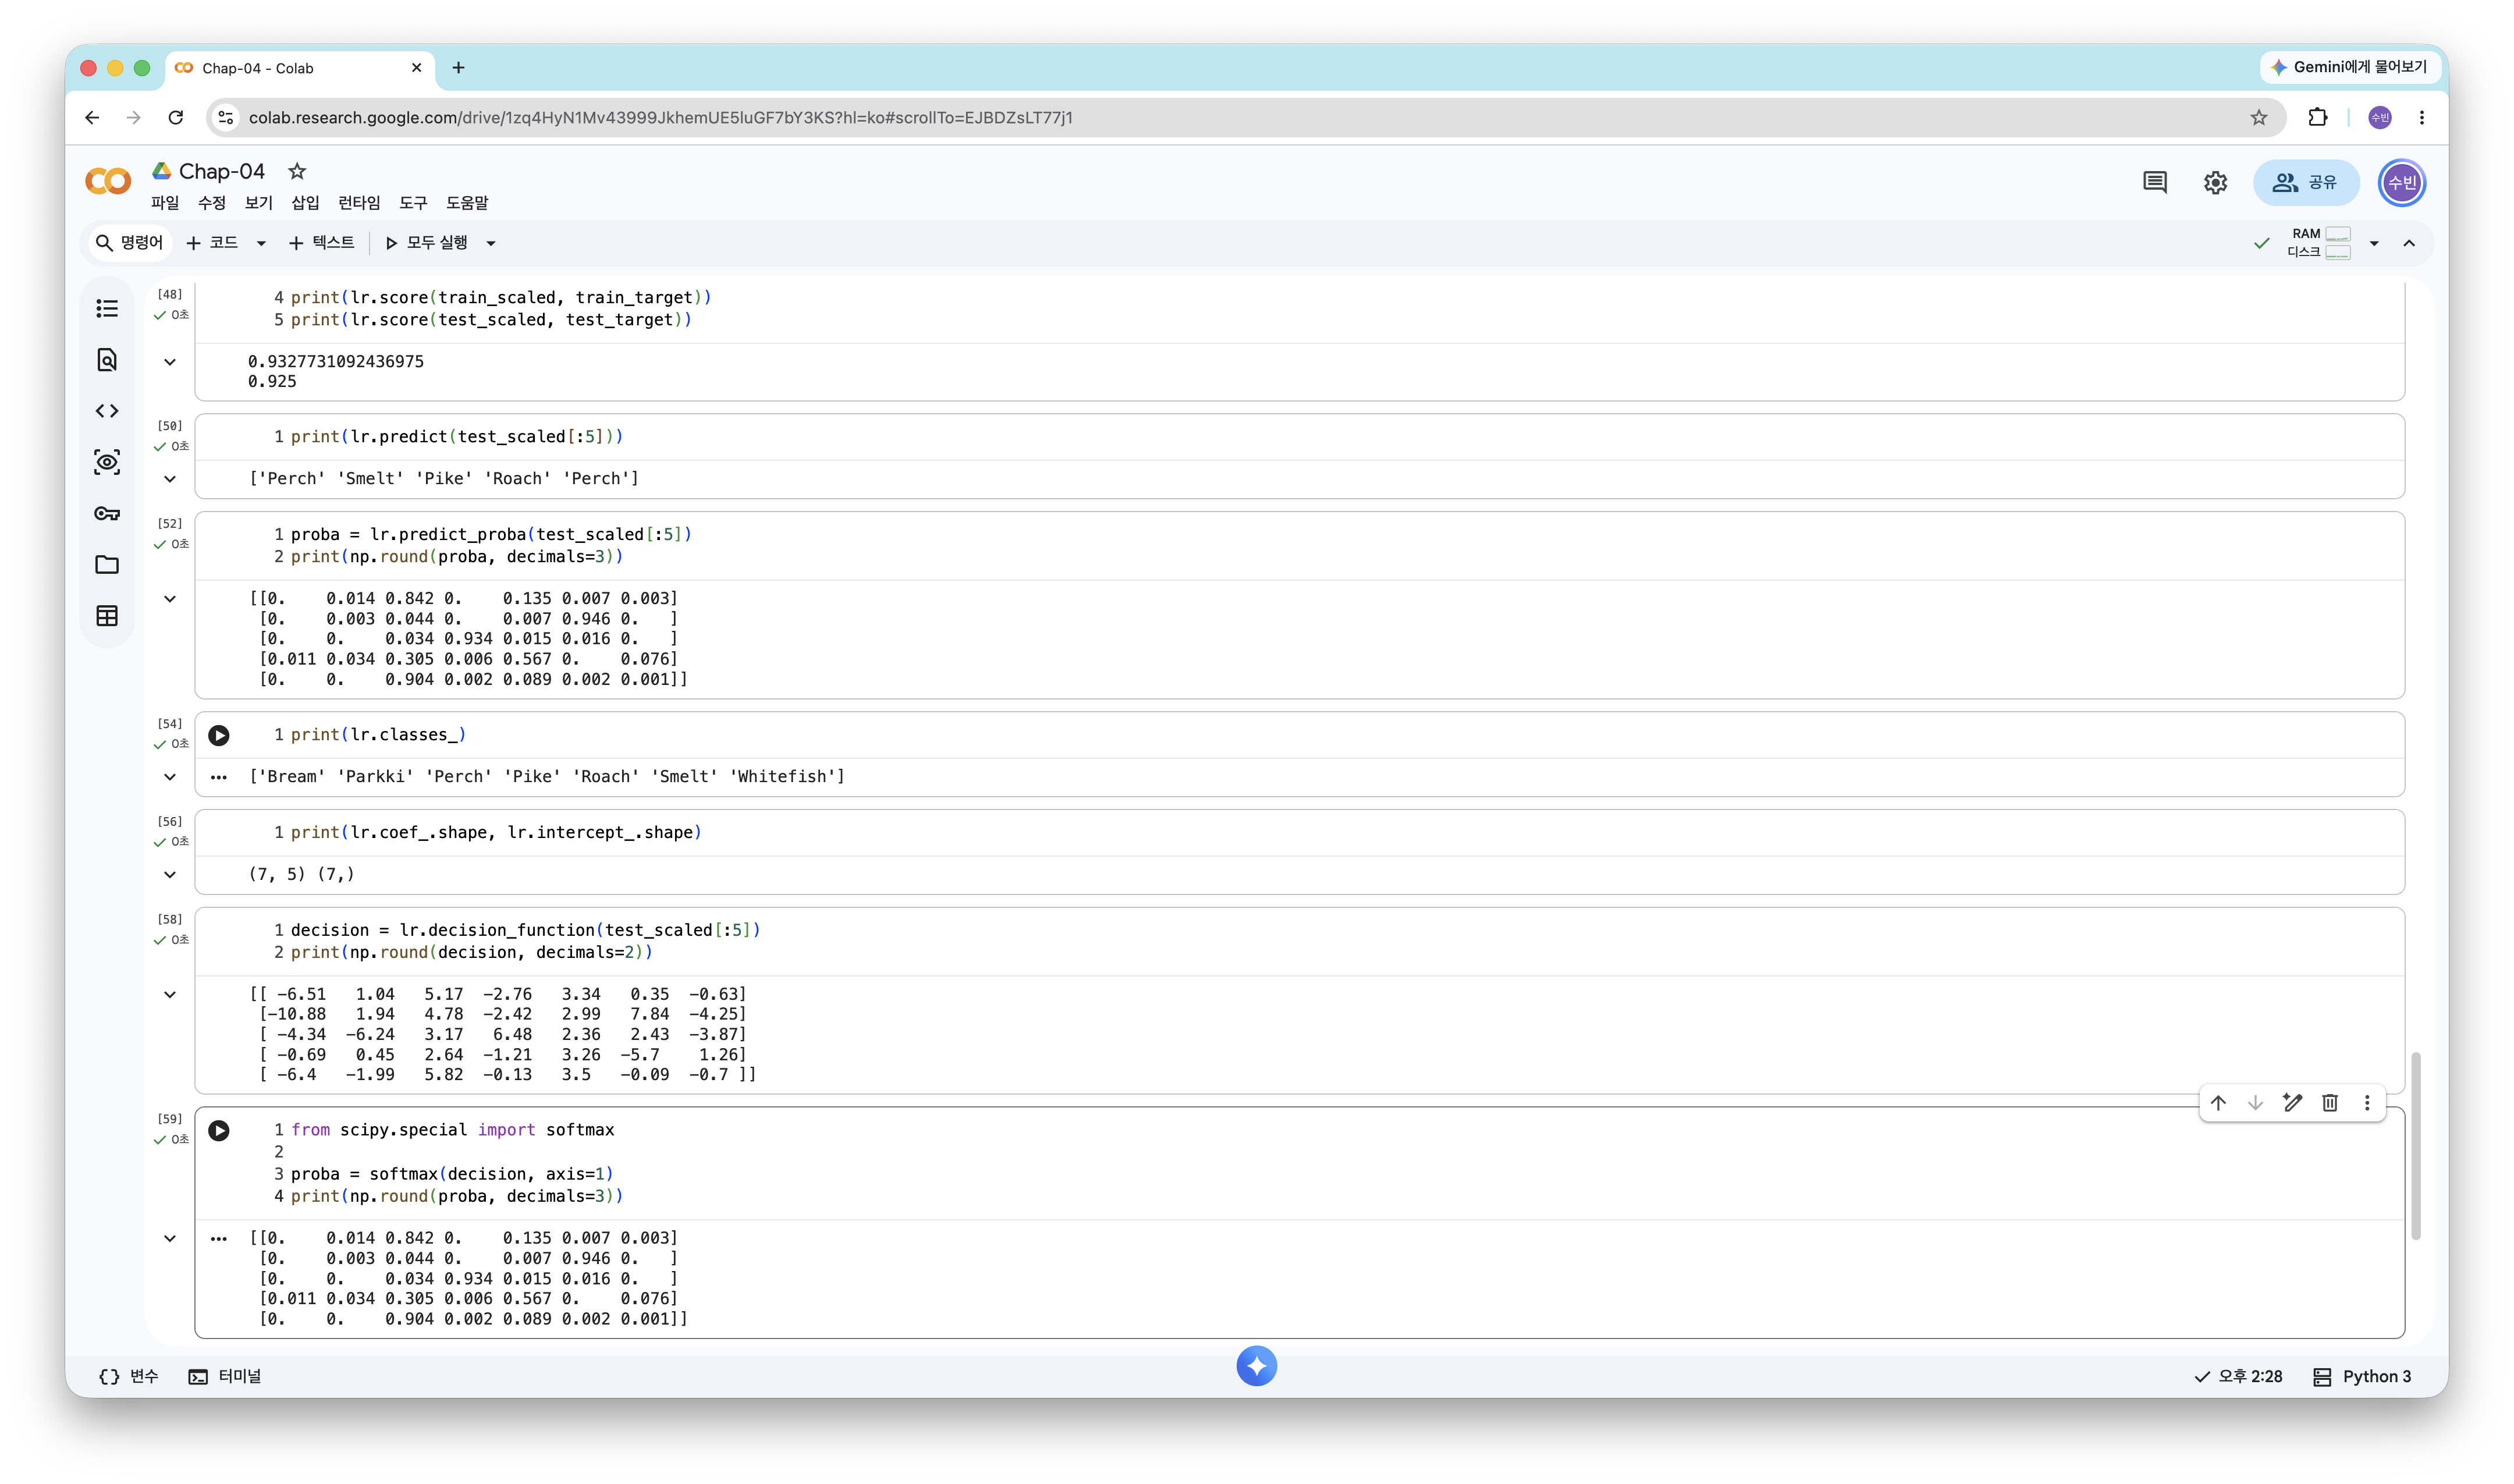
- 7개 클래스이므로 샘플마다 7개의 확률이 나온다. 각 행의 확률을 모두 더하면 1이다
- 각 행에서 가장 높은 확률의 클래스가 예측 결과가 된다. 예를 들어 첫 번째 샘플은 세 번째 열(Perch)이 0.842로 가장 높다
- k-최근접 이웃과 달리 확률이 0.014, 0.135처럼 세밀한 값으로 나온다
- 확률 배열의 열 순서를 알기 위해
classes_를 확인한다. 알파벳 순서인 Bream, Parkki, Perch, Pike, Roach, Smelt, Whitefish 순서다
1
| print(lr.coef_.shape, lr.intercept_.shape)
|
- 다중 분류는 클래스마다 z 값을 하나씩 계산한다. 그래서 계수와 절편도 클래스 개수만큼 있다
1
2
| decision = lr.decision_function(test_scaled[:5])
print(np.round(decision, decimals=2))
|
- 다중 분류에서
decision_function()은 샘플마다 7개 클래스 각각의 z 값(z1~z7)을 반환한다 - 이 z 값들을 확률로 바꾸려면 시그모이드가 아니라 소프트맥스 함수를 사용한다
1
2
3
4
| from scipy.special import softmax
proba = softmax(decision, axis=1)
print(np.round(proba, decimals=3))
|
- 소프트맥스(softmax) 함수: 여러 개의 z 값을 합이 1이 되는 확률로 바꾼다
- 각 z 값에 지수 함수를 적용한 e^z1, e^z2, …, e^z7을 모두 더한 값(e_sum)으로 각각을 나눈다
- 예: 첫 번째 클래스의 확률 = e^z1 / e_sum
axis=1로 지정해 각 행(샘플)마다 소프트맥스를 계산한다- 이진 분류는 시그모이드, 다중 분류는 소프트맥스를 사용한다
softmax()의 결과가 predict_proba()의 결과와 정확히 같다
로지스틱 회귀로 확률 예측
이번 절의 문제 해결 과정을 정리하면 다음과 같다.
- 문제 정의: 럭키백에 든 생선이 어떤 종류인지 확률로 알려 주기 (다중 분류)
- 첫 시도: k-최근접 이웃의
predict_proba() → 이웃이 3개라 확률이 네 가지밖에 안 나옴 - 해결: 로지스틱 회귀로 선형 방정식(z)을 학습하고 시그모이드/소프트맥스로 확률 변환
- 이진 분류 확인: 도미·빙어만 골라
decision_function() + expit()으로 확률이 맞는지 검증 - 다중 분류:
C=20, max_iter=1000으로 7개 클래스 훈련 → 훈련 0.933 / 테스트 0.925
04-2. 확률적 경사 하강법
점진적인 학습
- 상황: 새로운 생선 데이터가 매일 조금씩 추가된다. 그때마다 전체 데이터로 다시 훈련하면 시간이 너무 오래 걸린다
- 점진적 학습(온라인 학습): 앞서 훈련한 모델을 버리지 않고 새로운 데이터로 조금씩 더 훈련하는 방식
- 확률적 경사 하강법(Stochastic Gradient Descent, SGD)
- 훈련 세트에서 샘플 하나씩 꺼내 손실 함수의 경사를 따라 조금씩 내려가는 방법
- 에포크(epoch): 훈련 세트를 한 번 모두 사용하는 과정
- 미니배치 경사 하강법: 샘플을 여러 개씩 묶어 사용
- 배치 경사 하강법: 전체 샘플을 한 번에 사용. 가장 안정적이지만 자원을 많이 쓴다
- 손실 함수(loss function): 모델이 얼마나 엉터리인지 측정하는 함수. 값이 작을수록 좋다
- 경사 하강법으로 내려가려면 손실 함수가 연속적(미분 가능) 이어야 한다
- 정확도는 듬성듬성한 값이라 손실 함수로 쓸 수 없다
- 로지스틱 손실 함수(이진 크로스엔트로피 손실): 예측 확률에 로그를 취해 만든 손실 함수
- 양성 클래스일 때 −log(예측 확률), 음성 클래스일 때 −log(1 − 예측 확률)
- 다중 분류에서는 크로스엔트로피 손실 함수를 사용한다
- 회귀에서는 평균 절댓값 오차나 평균 제곱 오차를 손실 함수로 사용한다
SGDClassifier
1
2
3
| import pandas as pd
fish = pd.read_csv('https://bit.ly/fish_csv_data')
|
1
2
| fish_input = fish[['Weight','Length','Diagonal','Height','Width']]
fish_target = fish['Species']
|
Species는 타깃, 나머지 5개 열은 입력 데이터로 나눈다
1
2
3
4
| from sklearn.model_selection import train_test_split
train_input, test_input, train_target, test_target = train_test_split(
fish_input, fish_target, random_state=42)
|
1
2
3
4
5
6
| from sklearn.preprocessing import StandardScaler
ss = StandardScaler()
ss.fit(train_input)
train_scaled = ss.transform(train_input)
test_scaled = ss.transform(test_input)
|
- 확률적 경사 하강법도 거리 기반은 아니지만, 특성 스케일이 다르면 학습이 잘 되지 않으므로 표준화한다
1
| from sklearn.linear_model import SGDClassifier
|
- SGDClassifier: 사이킷런에서 확률적 경사 하강법을 사용하는 분류 모델
- 확률적 경사 하강법 자체는 모델이 아니라 최적화 방법이다. 어떤 손실 함수를 최소화할지를
loss 매개변수로 지정한다
1
2
3
4
5
| sc = SGDClassifier(loss='log_loss', max_iter=10, random_state=42)
sc.fit(train_scaled, train_target)
print(sc.score(train_scaled, train_target))
print(sc.score(test_scaled, test_target))
|
1
2
| 0.773109243697479
0.775
|
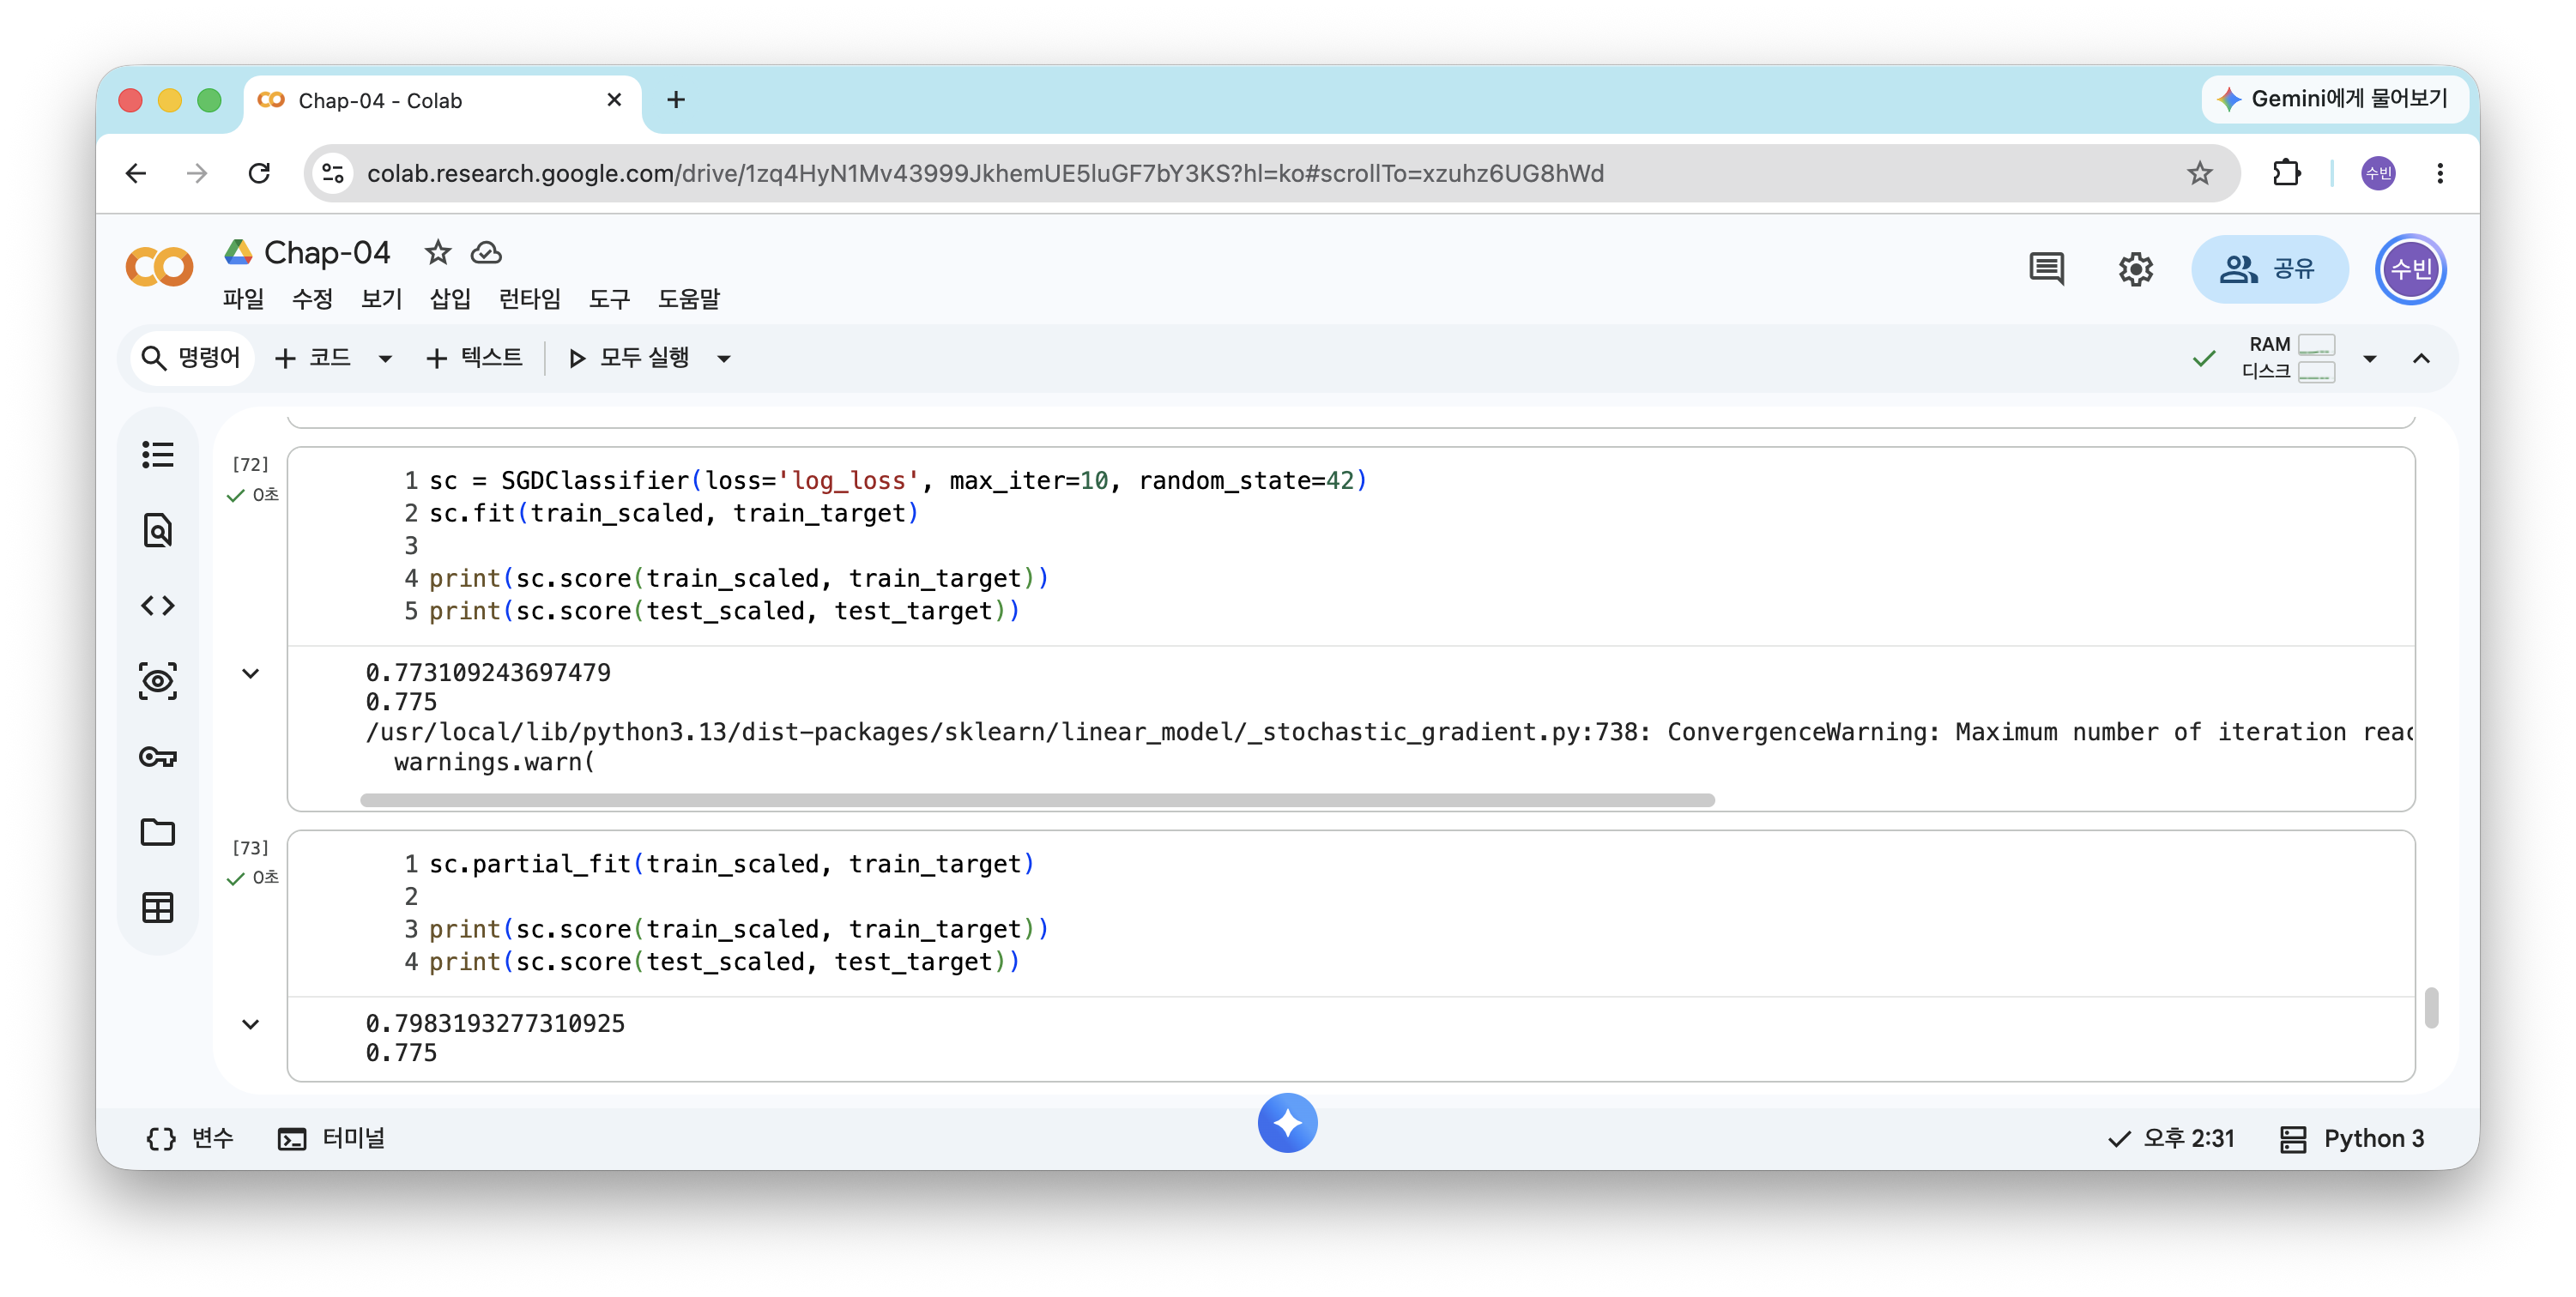
loss='log_loss': 로지스틱 손실 함수를 지정max_iter: 수행할 에포크 횟수. 10번으로는 부족해 점수가 낮고 경고도 뜬다- 훈련 세트 0.773, 테스트 세트 0.775로 둘 다 낮다 → 훈련이 덜 된 과소적합 상태
- 다중 분류일 때
SGDClassifier는 클래스마다 이진 분류 모델을 만든다. 한 클래스를 양성, 나머지를 모두 음성으로 두는 OvR(One versus Rest) 방식이다
1
2
3
4
| sc.partial_fit(train_scaled, train_target)
print(sc.score(train_scaled, train_target))
print(sc.score(test_scaled, test_target))
|
1
2
| 0.7983193277310925
0.775
|
partial_fit(): 모델을 초기화하지 않고 이어서 1 에포크만 더 훈련한다. 점진적 학습에 쓰는 메서드fit()을 다시 호출하면 이전에 학습한 것을 버리고 처음부터 다시 훈련하지만, partial_fit()은 기존 가중치에서 이어서 학습한다- 1 에포크만 더 했을 뿐인데 훈련 세트 점수가 0.773 → 0.798로 올랐다. 그렇다면 몇 번을 더 훈련해야 할까?
에포크와 과대/과소적합
- 에포크를 적게 반복하면 훈련이 덜 되어 과소적합
- 에포크를 많이 반복하면 훈련 세트에만 맞춰져 과대적합
- 조기 종료(early stopping): 테스트 점수가 떨어지기 시작하는 지점에서 훈련을 멈추는 것
1
2
3
4
5
6
7
8
| import numpy as np
sc = SGDClassifier(loss='log_loss', random_state=42)
train_score = []
test_score = []
classes = np.unique(train_target)
|
- 에포크마다 훈련 세트와 테스트 세트의 점수를 기록할 빈 리스트
train_score, test_score를 만든다 np.unique()로 훈련 세트에 있는 7개 생선 이름을 뽑아 classes에 저장한다
1
2
3
4
5
| for _ in range(0, 300):
sc.partial_fit(train_scaled, train_target, classes=classes)
train_score.append(sc.score(train_scaled, train_target))
test_score.append(sc.score(test_scaled, test_target))
|
partial_fit()만 사용할 때는 전체 클래스 목록을 classes로 전달해야 한다fit() 없이 처음부터 partial_fit()을 쓰면, 일부 데이터만 들어올 수도 있어 모델이 전체 클래스를 알 수 없기 때문이다
_는 사용하지 않는 변수를 나타내는 관례다. 반복 횟수만 필요하고 반복 변수는 쓰지 않는다- 300번 반복하면서 매 에포크마다 점수를 리스트에 추가한다
1
2
3
4
5
6
7
| import matplotlib.pyplot as plt
plt.plot(train_score)
plt.plot(test_score)
plt.xlabel('epoch')
plt.ylabel('accuracy')
plt.show()
|
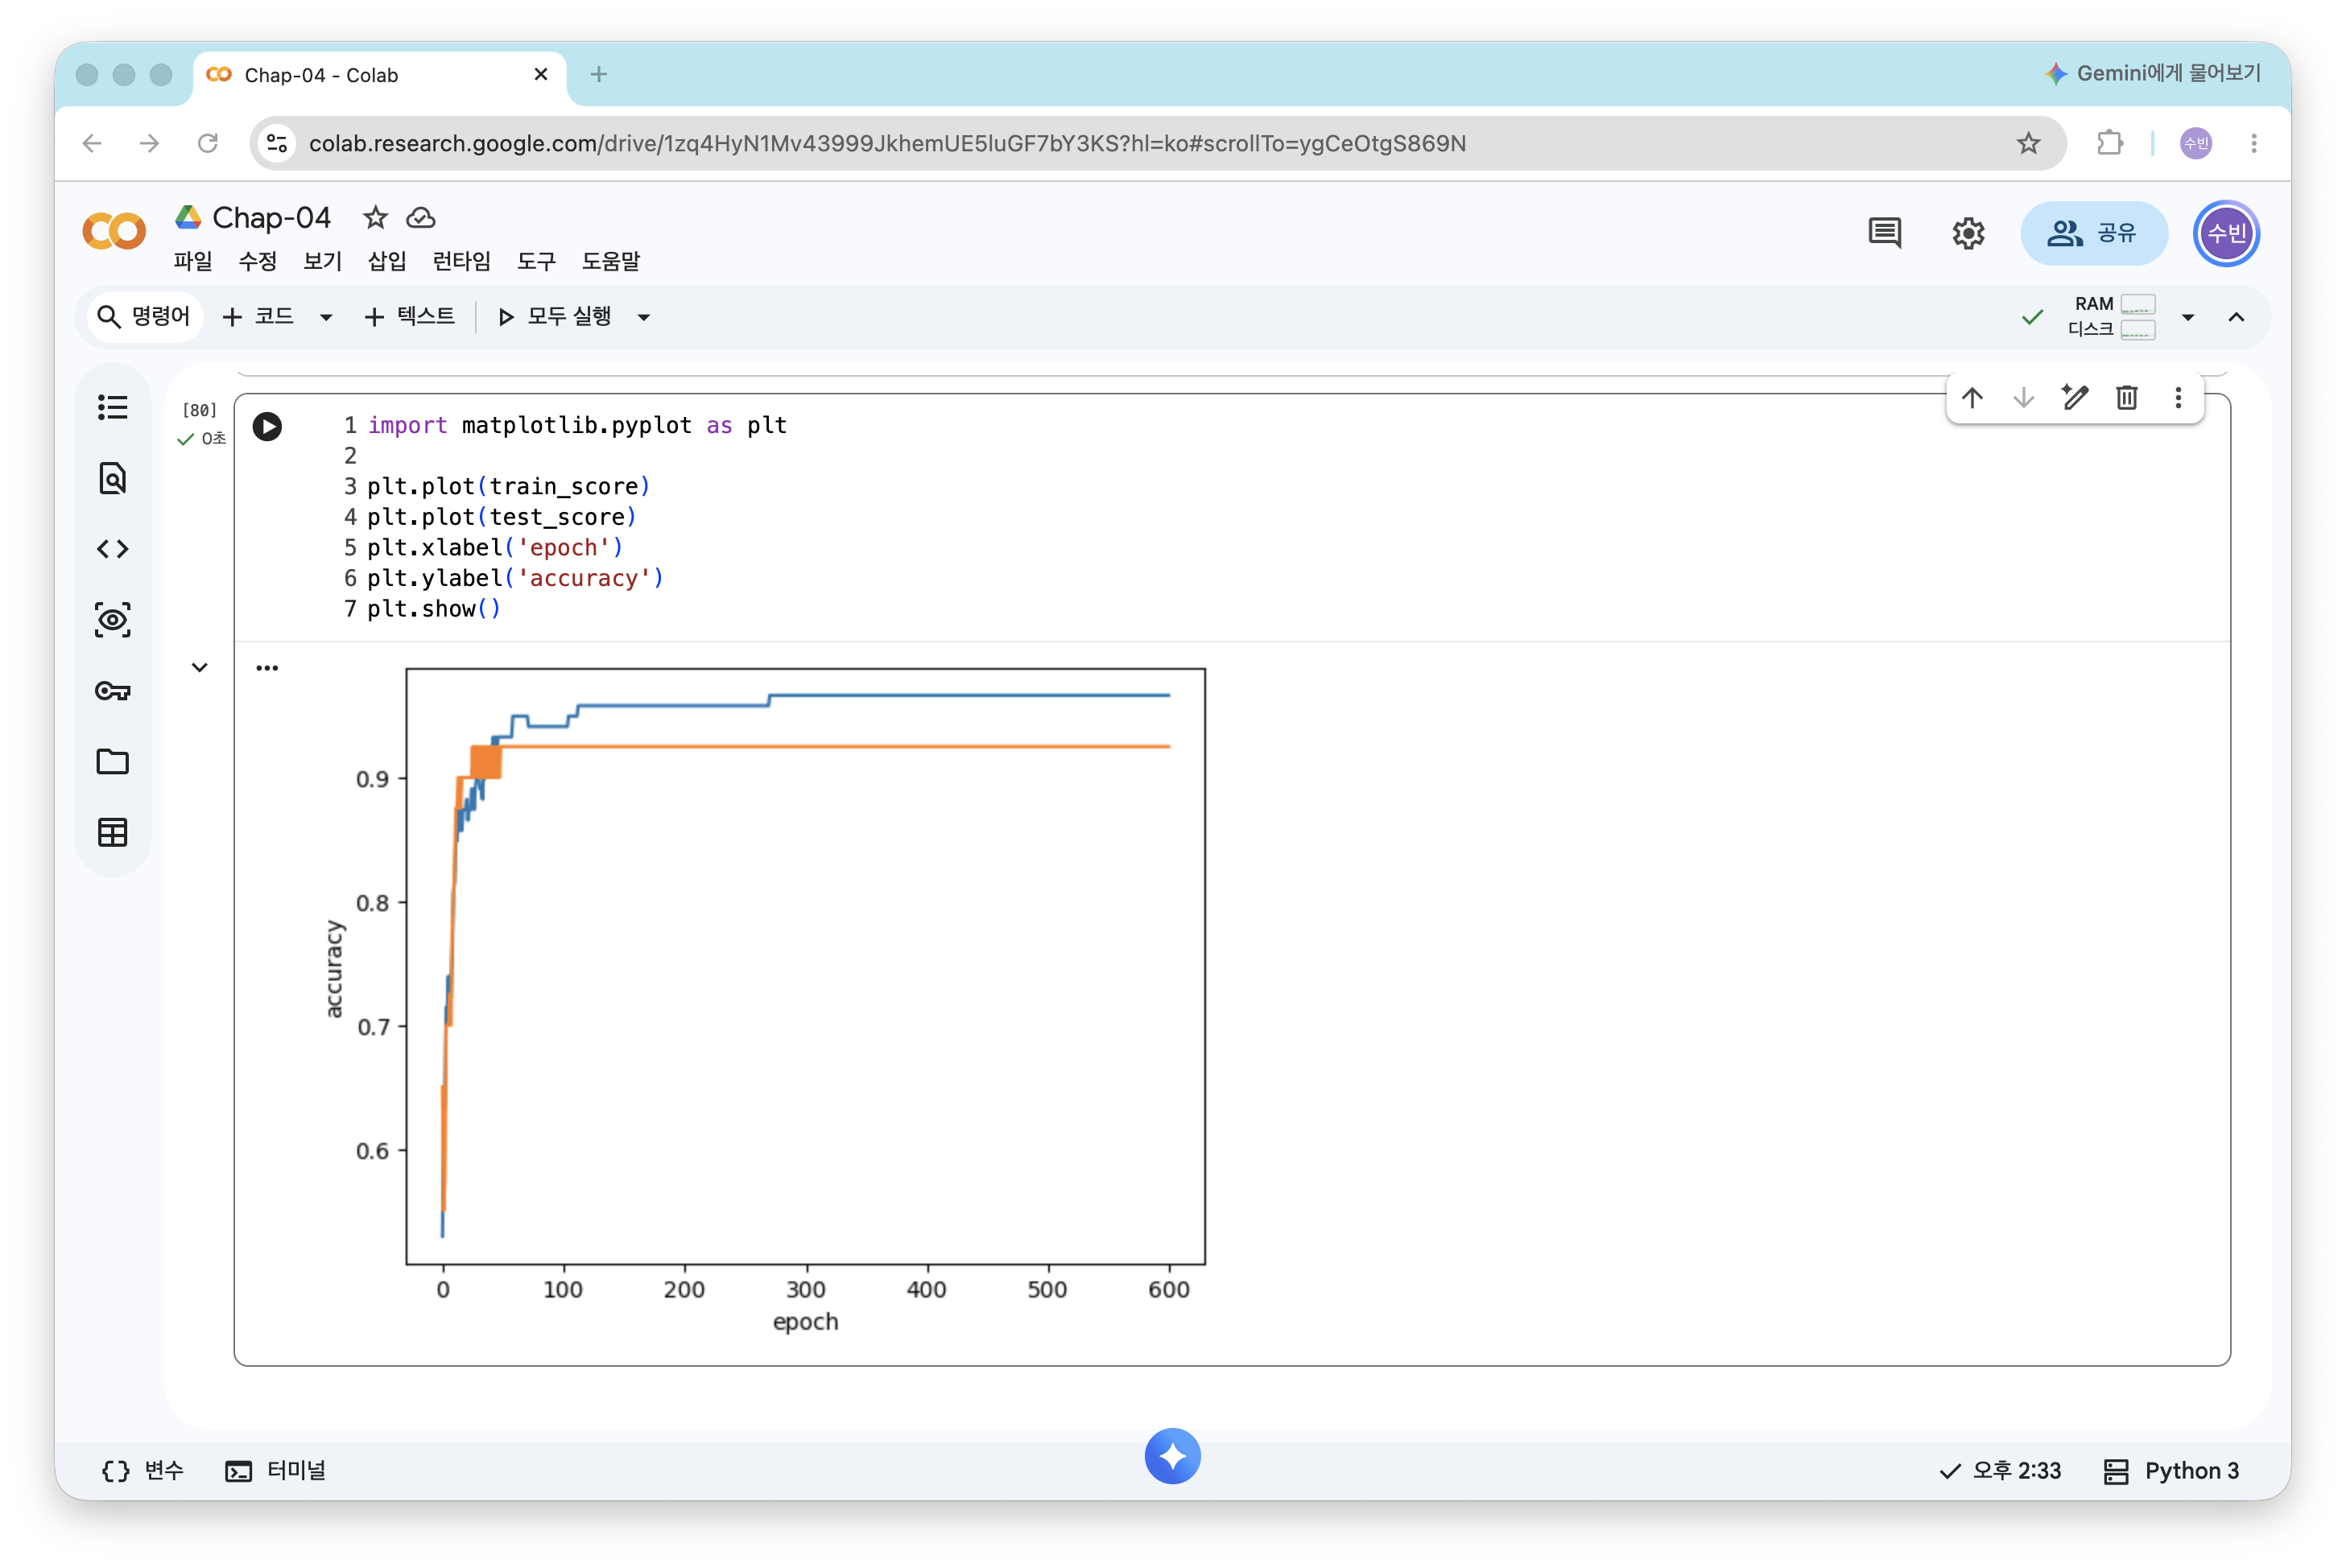
- 그래프를 보면 100번째 에포크 근처에서 두 점수가 가장 좋고, 그 이후에는 격차가 벌어진다
- 초기에는 두 점수가 모두 낮다 → 과소적합
- 100번째 이후로는 훈련 세트 점수만 올라가고 테스트 세트 점수는 제자리다 → 과대적합이 시작된다
- 따라서 반복 횟수를 100으로 맞추고 다시 훈련한다
1
2
3
4
5
| sc = SGDClassifier(loss='log_loss', max_iter=100, tol=None, random_state=42)
sc.fit(train_scaled, train_target)
print(sc.score(train_scaled, train_target))
print(sc.score(test_scaled, test_target))
|
1
2
| 0.957983193277311
0.925
|
tol: 향상될 최솟값. None으로 두면 자동으로 멈추지 않고 max_iter만큼 반복한다SGDClassifier는 일정 에포크 동안 성능이 향상되지 않으면 스스로 멈추기 때문에, 정확히 100번을 돌리려고 tol=None을 지정했다
- 훈련 세트 0.958, 테스트 세트 0.925로 처음(0.773 / 0.775)보다 크게 좋아졌고, 두 점수 차이도 크지 않다
1
2
3
4
5
| sc = SGDClassifier(loss='hinge', max_iter=100, tol=None, random_state=42)
sc.fit(train_scaled, train_target)
print(sc.score(train_scaled, train_target))
print(sc.score(test_scaled, test_target))
|
1
2
| 0.9495798319327731
0.925
|
loss='hinge': 힌지 손실. SGDClassifier의 기본값이며 서포트 벡터 머신(SVM) 을 위한 손실 함수다SGDClassifier는 손실 함수만 바꾸면 여러 종류의 선형 모델을 훈련할 수 있다- 힌지 손실로도 훈련 0.950 / 테스트 0.925로 로지스틱 손실과 비슷한 성능이 나왔다
점진적 학습을 위한 확률적 경사 하강법
이번 절의 문제 해결 과정을 정리하면 다음과 같다.
- 문제 인식: 데이터가 계속 추가되는 상황에서 매번 전체를 다시 훈련할 수 없다
- 해결 방법: 확률적 경사 하강법으로 기존 모델에 이어서 훈련 (
partial_fit()) - 에포크 조정: 에포크가 적으면 과소적합, 많으면 과대적합 → 300 에포크 동안 점수를 기록해 그래프로 확인
- 최적 에포크 선택: 100 에포크에서 훈련 0.958 / 테스트 0.925
- 손실 함수 비교:
log_loss(로지스틱) 대신 hinge(SVM)도 사용할 수 있다
📌 정리
- 클래스별 확률이 필요할 때 k-최근접 이웃은 이웃 개수에 갇힌 확률만 낸다 → 로지스틱 회귀를 사용한다
- 로지스틱 회귀는 선형 방정식 z를 계산한 뒤 시그모이드(이진)·소프트맥스(다중) 로 확률을 만든다
- 데이터가 계속 추가되는 상황에서는 확률적 경사 하강법으로 기존 모델에 이어서 훈련한다(
partial_fit()) - 에포크가 적으면 과소적합, 많으면 과대적합 → 점수 그래프를 그려 조기 종료 지점을 찾는다
핵심 용어: 다중 분류 / 로지스틱 회귀 / 시그모이드 / 소프트맥스 / 확률적 경사 하강법 / 에포크 / 손실 함수 / 로지스틱 손실 / 힌지 손실 / 조기 종료